图形训练服务器不是某一个型号,而是品牌GPU整机、OEM定制/白牌、GPU工作站、云GPU实例、租赁托管这五类形态;选型先看GPU平台、显存、卡间互联和散热供电,再算采购或租赁成本。
先把话说透,很多人搜“图形训练服务器有哪些”,以为会得到一张型号清单,实际上市面上能买到的机器,大多围绕NVIDIA HGX、AMD Instinct、昇腾等GPU平台做整机集成,品牌不同,卡型、拓扑、散热和售后差异很大,你要做的不是背型号,而是先分清形态,再按训练任务倒推配置。
图形训练服务器有哪些:五类形态先分清
品牌GPU整机:开箱即用,适合预算明确的大团队
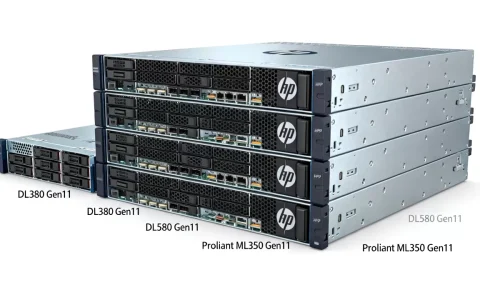
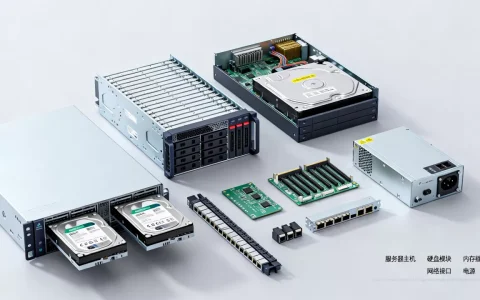
这类机器由服务器厂商基于GPU平台集成,常见公开产品包括NVIDIA DGX系列、HGX平台整机,以及戴尔PowerEdge XE9680、浪潮NF5688M6、联想问天WA7780 G3、新华三R5300 G6、超微SYS-821GE-TNHR、宁畅X660 G45等,它们通常提供8卡GPU、NVLink或PCIe互联、冗余电源、集中散热,适合视觉大模型、多模态训练和自动驾驶感知训练。
优点是交付完整、驱动和集群工具相对成熟,缺点是价格高,配置调整空间小,购买前要确认GPU是原厂整机方案还是后集成,卡间互联是NVLink还是PCIe Switch,售后是否覆盖GPU。
OEM定制和白牌服务器:灵活,但要盯紧工程能力
OEM定制和白牌准系统在中小团队里很常见,你可以选4卡或8卡,选风冷或液冷,选本地NVMe或外接存储,适合有运维经验、希望按项目压成本的团队。
这类方案的关键不是“便宜”,而是供电、散热、PCIe拓扑和固件兼容,同样8卡,风道设计不好,训练时降频;PCIe拆分不合理,数据搬运拖后腿,签合同前要让供应商提供压力测试记录,包括GPU满载温度、电源冗余、NCCL通信测试结果。
GPU工作站与桌面训练机:小团队验证模型够用
4卡以内的图形工作站适合高校实验室、算法预研、医疗影像单机训练,噪音、功耗和机房条件比机架服务器友好,它不适合长时间满载跑大模型,也不适合多机扩展。
如果你只是做图像分类、目标检测、分割这类任务,单机多卡工作站可以先把流程跑通,等任务稳定后再上机架服务器或云GPU,避免一上来就买重资产。
云GPU实例:短期项目和多地协作的折中方案
简米云GPU实例、酷番云GPU云服务器、华为云GPU加速型等,都属于这一类,优势是开通快、按需计费、不用管机房,适合投标验证、短期训练、数据不能出本地但又需要弹性算力的团队。
要留意数据上传下载成本、长期占用成本和实例规格连续性,训练任务如果持续几个月,云上按卡时累计可能高于自建,涉及敏感数据时,优先看专有云、托管云或本地部署。
租赁与托管:项目制团队的轻资产选择
北京图形训练服务器租赁适合周期明确的项目,比如三个月的视觉质检模型迭代、半年的多模态预研,北京地区常见机房资源集中在昌平、亦庄、酒仙桥等区域周边,租赁方通常按卡按月报价,托管则要另算机柜、电力和带宽。
租赁前问清三件事:GPU是否独享、机房是否支持RDMA网络、故障卡替换时限,别只看单卡月租,电力超限和存储扩容经常是隐藏成本。
图形训练服务器怎么选:先看显卡、显存和互联
先定GPU平台和显存,不要先看品牌
图形训练吃显存,做高分辨率图像分割、视频理解、多模态对齐,单卡显存和卡间带宽往往比CPU核数更关键,业内专家指出,训练任务先被显存卡住,再被通信卡住的情况很常见。
常见平台可以这样理解:
- NVIDIA H100/H200/B200及GB200方案,生态成熟,适合大规模训练和推理混合负载。
- AMD Instinct MI300X等平台,显存容量有优势,要确认框架和算子适配。
- 昇腾等国产平台,适合有信创要求的项目,要提前验证PyTorch适配和算子覆盖。
- 消费级卡或工作站卡,适合小规模验证,不建议硬撑大规模长时间训练。
图形训练服务器和普通服务器区别在哪
普通服务器强调CPU核数、内存容量和存储密度,图形训练服务器把重心放在GPU、PCIe通道、NVLink拓扑、电源和散热上,区别可以用一张表看清:
| 对比项 | 普通服务器 | 图形训练服务器 |
|---|---|---|
| 核心算力 | CPU为主 | GPU为主 |
| 内存与显存 | 内存大 | 显存和卡间带宽关键 |
| 互联 | 普通PCIe | NVLink、PCIe Switch、RDMA网络 |
| 供电散热 | 常规冗余 | 高功率冗余、风冷或液冷 |
| 适用场景 | Web、数据库、虚拟化 | 视觉训练、多模态、科学计算 |
本地部署图形训练服务器配置推荐
本地部署别只写“8卡GPU”,一套能落地的配置通常包括:
- GPU:4卡或8卡,按模型参数量和batch size定。
- CPU:双路服务器CPU,负责数据预处理和调度。
- 内存:1TB到2TB起步,数据管道重时继续加。
- 本地存储:NVMe做缓存,并行文件系统或高速NAS做数据集。
- 网络:多机训练优先InfiniBand或RoCE,别用普通千兆网硬扛。
- 电源与散热:按GPU峰值功耗留余量,8卡机尤其要算电费和机房承重。
上架前用命令做基础验收:nvidia-smi看卡和驱动,nvidia-smi topo -m看互联拓扑,lspci | grep -i nvidia确认PCIe链路,dcgmi diag做诊断,nccl-tests跑all_reduce,多机环境再查RDMA和交换机配置,据统计,训练效率问题里,数据加载和网络通信占了不少比例,别等跑起来才发现瓶颈。
图形训练服务器价格多少钱:整机、云租和托管怎么算
整机采购:看卡型,不看机箱
图形训练服务器价格跨度很大,单卡训练机几万元起,8卡高端GPU整机常见到几十万元到百万元级,同样8卡,H100/H200平台和上一代卡、国产卡、消费级卡方案不在一个价格带,行业共识认为,采购预算要把三年电费、机房改造、备件和运维人力一起算,不能只比整机报价。
云GPU按需:短期灵活,长期要算总账
云GPU按卡时或包月计费,适合验证和波动负载,价格受卡型、地域、抢占式实例和存储类型影响,做预算时把数据出网、快照、对象存储和长期占用一起算,项目周期短,云上更轻;周期长且负载稳定,自建或租赁更容易摊薄成本。
北京图形训练服务器租赁适合哪些团队
北京图形训练服务器租赁更适合项目制算法团队、外地进京做交付的团队、临时算力缺口大的实验室,选租赁时看机房位置、网络出口、GPU独享方式和故障响应,合同里写清卡型、显存、互联方式、电力和存储上限,价格别只问“一台多少钱”,要问“一张卡一个月多少钱、超电怎么算、故障怎么赔”。
部署与验收:参数漂亮不等于能跑满
上架前检查清单
- 驱动、CUDA、容器运行时版本匹配。
nvidia-smi topo -m确认GPU间是NVLink还是PCIe。- 电源模块和GPU满载功耗留余量。
- 风扇策略、进风温度和机房冷通道正常。
- 多机训练检查RDMA网卡、交换机和MTU。
- 用
nccl-tests跑带宽,用dcgmi看健康状态。
训练环境别临时拼
视觉训练常用PyTorch、TensorFlow和容器镜像,把驱动、CUDA、cuDNN、NCCL版本固定下来,再用Slurm或Kubernetes做调度,数据集放高速存储,别让GPU等磁盘,监控至少看GPU利用率、显存、温度、功耗和网络吞吐。
图形训练服务器常见问题Q&A
图形训练服务器有哪些常见采购误区?
只看GPU型号,不看互联和散热;只看整机价格,不算电力和运维;把工作站当机架服务器长期满载跑,先做小规模压力测试,再决定批量采购或租赁。
图形训练服务器能当普通服务器用吗?
能,但不划算,GPU服务器的高功耗、散热和采购成本都围绕训练负载设计,拿来跑Web或数据库会浪费资源,普通业务优先用普通服务器,训练任务再单独规划。
图形训练服务器采购和租赁哪个更合适?
采购适合长期稳定负载和涉密本地部署,租赁适合短周期项目和算力波峰,按实际卡时、折旧、电力和运维人力核算,项目结束后资产处置也要提前想清楚。
图形训练服务器的核心不是“有哪些型号”,而是先按任务定GPU平台、显存、互联和散热,再在整机、定制、工作站、云实例和租赁之间做取舍,把验收命令和成本账算清楚,比追一张品牌清单更可靠。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/810611.html