一文读懂大模型的技术难点,大模型技术实现有哪些挑战

大模型的技术实现是一项系统工程,其核心难点并非单一维度的技术瓶颈,而是算力效率、数据质量、算法架构与推理部署四者之间的深度耦合与平衡,要真正理解大模型的技术难点,必须认识到:算力是基础底座,数据是决定上限的核心,算法是提升效率的关键,而推理部署则是商业落地的最后一公里,这四个环节环环相扣,任何一个环节的短板都会导致模型性能的断崖式下跌或应用成本的失控。

一文读懂大模型的技术难点的技术实现

算力效率与显存优化的技术突围

训练千亿参数级别的大模型,首当其冲的挑战是显存墙与计算墙,如何在有限的硬件资源下实现高效的并行计算,是技术实现的第一道门槛。

  1. 显存瓶颈的突破: 模型参数、梯度、优化器状态占据了海量显存。混合精度训练成为标配,通过半精度(FP16/BF16)进行计算,单精度(FP32)进行权重备份,大幅降低显存占用。
  2. 并行策略的演进: 单卡显存无法容纳完整模型,必须依赖模型并行与流水线并行,模型并行将大矩阵切分到多张卡上计算;流水线并行则将模型的不同层分配到不同设备,通过微批次技术减少等待间隙。
  3. 显存卸载技术: ZeRO技术通过切分优化器状态、梯度和参数,消除了数据并行中的冗余内存占用,实现了计算资源与存储资源的极致利用,是当前解决显存瓶颈的核心方案。

高质量数据工程的构建与清洗

数据决定了模型能力的“天花板”,技术难点不在于数据的数量,而在于从海量原始数据中提炼出高质量训练语料的工程能力。

  1. 多源异构数据清洗: 原始数据包含大量噪声、重复内容和有害信息。去重算法(如MinHash、SimHash)和敏感词过滤系统必须具备极高的吞吐量。
  2. 数据配比与多样性: 不同领域数据的配比直接影响模型的泛化能力,技术团队需要通过主动学习策略,动态调整训练数据的分布,确保模型在代码、数学、文学等不同领域的能力均衡。
  3. 合成数据技术: 面对高质量数据的枯竭,利用强模型生成高质量指令数据微调弱模型,已成为提升模型对齐能力的关键技术路径。

算法架构与分布式训练的稳定性

模型架构的设计与训练过程的稳定性,直接关系到模型是否能够收敛以及最终的智能水平。

一文读懂大模型的技术难点的技术实现

  1. 注意力机制优化: 随着上下文窗口的扩大,标准Transformer的注意力计算复杂度呈二次方增长。Flash Attention通过优化GPU显存读写次数,在不牺牲精度的情况下实现了线性复杂度的加速,解决了长文本处理的痛点。
  2. 位置编码的改进: 传统的位置编码难以适应超长序列外推。RoPE(旋转位置编码)和ALiBi等技术通过相对位置信息,显著提升了模型对长序列的理解能力。
  3. 训练崩溃与Loss突刺: 大模型训练过程中常出现Loss突增甚至发散的现象。预归一化、梯度裁剪以及AdamW优化器的精细调参,是维持训练稳定性的必要手段。

指令微调与人类对齐的精细化打磨

预训练模型具备知识,但缺乏指令遵循能力,如何让模型“懂人话、听指挥”,是技术实现的另一大难点。

  1. 指令微调(SFT): 构建高质量的指令数据集是核心,技术难点在于数据质量远比数量重要,少量高质量的指令数据往往比大量低质数据效果更好。
  2. 人类反馈强化学习(RLHF): 这是实现价值观对齐的关键。PPO算法需要训练奖励模型来评判回答质量,过程极其不稳定且对超参数敏感。
  3. 直接偏好优化(DPO): 针对RLHF训练复杂的问题,DPO算法直接利用人类偏好数据优化策略,简化了训练流程,成为当前高效对齐的主流技术选择。

推理部署与成本控制的工程落地

模型训练完成只是开始,如何以低成本、低延迟将模型部署上线,是商业成功的决定性因素。

  1. 模型量化技术: 通过将模型权重从FP16量化为INT8甚至INT4,显存占用可减少一半以上,虽然会带来微小的精度损失,但推理速度大幅提升。
  2. KV Cache优化: 在自回归生成过程中,缓存注意力计算中的Key和Value矩阵,避免重复计算,是提升生成速度的标准操作。
  3. 投机采样: 利用一个小模型快速生成候选Token,大模型并行验证,通过“以小博大”的方式显著降低了首字延迟和整体推理成本。

在深入剖析上述环节后,我们可以清晰地看到,一文读懂大模型的技术难点的技术实现,本质上是在追求极致的资源利用率与模型性能的平衡,从底层的算力调度到上层的数据治理,每一个技术细节的突破,都是大模型从实验室走向产业应用的基石。

相关问答模块

一文读懂大模型的技术难点的技术实现

大模型训练中最容易出现的技术卡点是什么?
大模型训练中最常见的卡点是显存溢出(OOM)和训练不收敛,显存溢出通常源于Batch Size设置过大或模型参数未优化,解决方案是采用梯度累积、混合精度训练及ZeRO显存优化技术,训练不收敛则多由学习率设置不当或数据异常引起,需要通过Warmup策略预热学习率,并严格清洗训练数据中的异常值。

为什么推理阶段的显存占用比训练阶段大?
这是一个常见的误区。推理阶段的显存占用通常远小于训练阶段,训练时需要存储模型参数、梯度、优化器状态以及中间激活值,显存占用巨大,而推理阶段只需加载模型参数和KV Cache,无需反向传播,如果推理显存过高,通常是因为未开启KV Cache优化或未进行模型量化,通过Flash Attention和量化技术可有效降低推理显存需求。

您在阅读本文后,对大模型技术实现的哪个环节最感兴趣?欢迎在评论区分享您的见解或提出疑问。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://idctop.com/article/98568.html

赞 (0)
服务器怎么存储用户的照片?海量图片存储方案详解
上一篇 2026年3月17日 05:22
flex开发实例有哪些,flex布局实战案例教程
下一篇 2026年3月17日 05:28

相关推荐

  • 腾讯cdn效果怎么样,腾讯cdn加速服务

    腾讯CDN在2026年的核心优势在于其依托微信生态与腾讯云底层架构实现的“云边端”一体化加速,在动静分离场景下可提供99.99%的服务可用性,综合性价比优于传统单一线路服务商,特别适合高并发、低延迟要求的互联网应用及跨境电商业务,腾讯CDN技术架构与核心性能解析底层网络资源与节点覆盖腾讯CDN并非简单的节点堆砌……

    2026年6月15日
    7000
  • 字节阿里大模型对比哪家强?2026大模型厂商实力排行榜

    国内大模型领域的竞争格局已从“百模大战”演变为“巨头博弈”,字节跳动与阿里巴巴凭借各自生态优势,稳居厂商实力排行第一梯队,综合技术底座、应用落地、算力储备及商业化进程分析,字节跳动胜在C端流量与模型调用成本,阿里巴巴强在B端产业生态与企业级服务稳定性,对于寻求大模型解决方案的企业或个人而言,理解这两大巨头的差异……

    2026年4月5日
    14500
  • 服务器唤醒需输入密码?远程唤醒安全配置方法,服务器如何设置唤醒认证?远程开机密码保护技巧

    在服务器上设置唤醒后要求输入用户名和密码,是提升物理安全性的重要措施,可防止未经授权的人员在服务器从睡眠状态(如S3睡眠)恢复时直接访问系统,核心设置涉及服务器固件(BIOS/UEFI)和操作系统两个层面的配置,硬件与固件层配置 (BIOS/UEFI)这是实现唤醒密码保护的基础,通常在服务器启动时按特定键(如D……

    2026年2月6日
    16800
  • kimi大模型核心龙头是谁?揭秘kimi概念真正的龙头股

    Kimi大模型的核心投资逻辑与应用价值,早已超越了单一聊天机器人的范畴,其本质是国产大模型在长文本处理领域的一次降维打击,也是目前国内AI应用层最接近“超级应用”形态的流量入口,核心结论非常明确:Kimi大模型核心龙头的市场地位,建立在“长上下文技术壁垒”与“真实场景落地能力”的双重护城河之上,对于投资者和行业……

    2026年3月23日
    17300
  • cdn通俗的讲是什么,cdn是什么

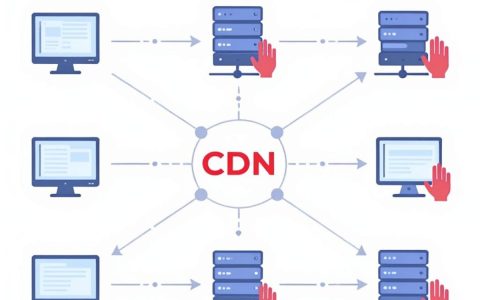
    CDN(内容分发网络)通俗来讲,就是通过在各地部署“前置仓库”,让互联网用户就近获取数据,从而解决跨地域访问慢、服务器压力大、易受攻击等问题的技术架构,在2026年的数字生态中,CDN已不再仅仅是加速工具,而是保障业务连续性与用户体验的底层基础设施,随着5G普及与边缘计算深度融合,CDN的形态发生了本质变化,C……

    2026年5月29日
    4500
  • 图片与短视频混布站点带宽如何一起计算,带宽大小怎么估算?

    图片与视频混布站点的带宽计算,核心思路是“分开算、叠加看”:视频按峰值并发和码率推算基础带宽,图片按页面请求量和缓存命中率计算增量,两者相加后还要留出突发余量,才是真实需要的带宽值,图片和视频混布网站怎么算带宽:先拆开看两种请求的脾气很多站长在给混布站点算带宽时,习惯把两个站点的带宽需求直接相加,结果预算翻倍……

    2026年9月16日
    400
  • 服务器上配置VIP的步骤是什么,配置过程中需要注意什么?

    在服务器上配置VIP(虚拟IP)是实现业务高可用的核心操作,通过Keepalived或系统网络命令即可完成,关键在于理解VIP的漂移与抢占机制,什么是服务器VIP,为什么需要配置它服务器VIP(Virtual IP)是一个不与特定物理网卡绑定的逻辑IP地址,它可以在多台服务器之间动态迁移,当一台服务器宕机时,V……

    2026年7月30日
    1000
  • 虚拟主机是cdn吗?虚拟主机cdn加速怎么选

    虚拟主机并非 CDN,两者在架构逻辑、功能定位及适用场景上存在本质区别,切勿混淆,在 2026 年的数字化基建体系中,许多企业仍对基础网络服务存在认知误区,将虚拟主机等同于内容分发网络(CDN),是典型的架构选型错误,虚拟主机是运行网站代码的“服务器空间”,而 CDN 是加速内容传输的“物流网络”,若您的目标是……

    2026年5月11日
    4900
  • CDN命中率低怎么解决,cdn命中率优化方法

    CDN命中率是衡量内容分发网络效率的核心指标,2026年行业优秀标准要求综合命中率不低于95%,否则将直接导致源站负载过高、访问延迟增加及带宽成本失控,CDN命中率反映用户请求在边缘节点缓存中直接命中的比例,是决定网站性能与运营成本的关键杠杆,根据《2026年全球CDN行业报告》,全球CDN市场规模已突破500……

    2026年7月21日
    1000
  • 新路由三cdn怎么设置?新路由器cdn加速慢怎么办

    新路由三CDN加速并非独立软件,而是通过修改路由器DNS设置或安装特定插件,将流量引导至第三方加速节点以优化访问速度的技术手段,其核心在于利用缓存机制减少延迟,对于许多家庭用户和小型办公场景而言,网络卡顿往往是比硬件老化更令人头疼的问题,新路由三作为一款曾经颇受欢迎的智能路由器,其硬件性能在当年属于中端水平,但……

    2026年6月15日
    4100

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注