机器学习解决fizzbuzz,就像用卫星导航找楼下便利店,技术上可行但性价比极低,这个看似荒谬的组合,恰恰是检验你对模型泛化、数据偏差和过拟合理解的试金石。
fizzbuzz机器学习面试题:面试官在考察什么?
在北京、上海等一线城市的数据科学面试中,fizzbuzz机器学习面试题的出现频率正在上升,面试官并不是真的想让你用模型解决一个简单规则问题,而是通过你的回答,观察你是否具备问题类型的判断力,行业共识认为,这道题能快速区分“工具导向”和“问题导向”的候选人。
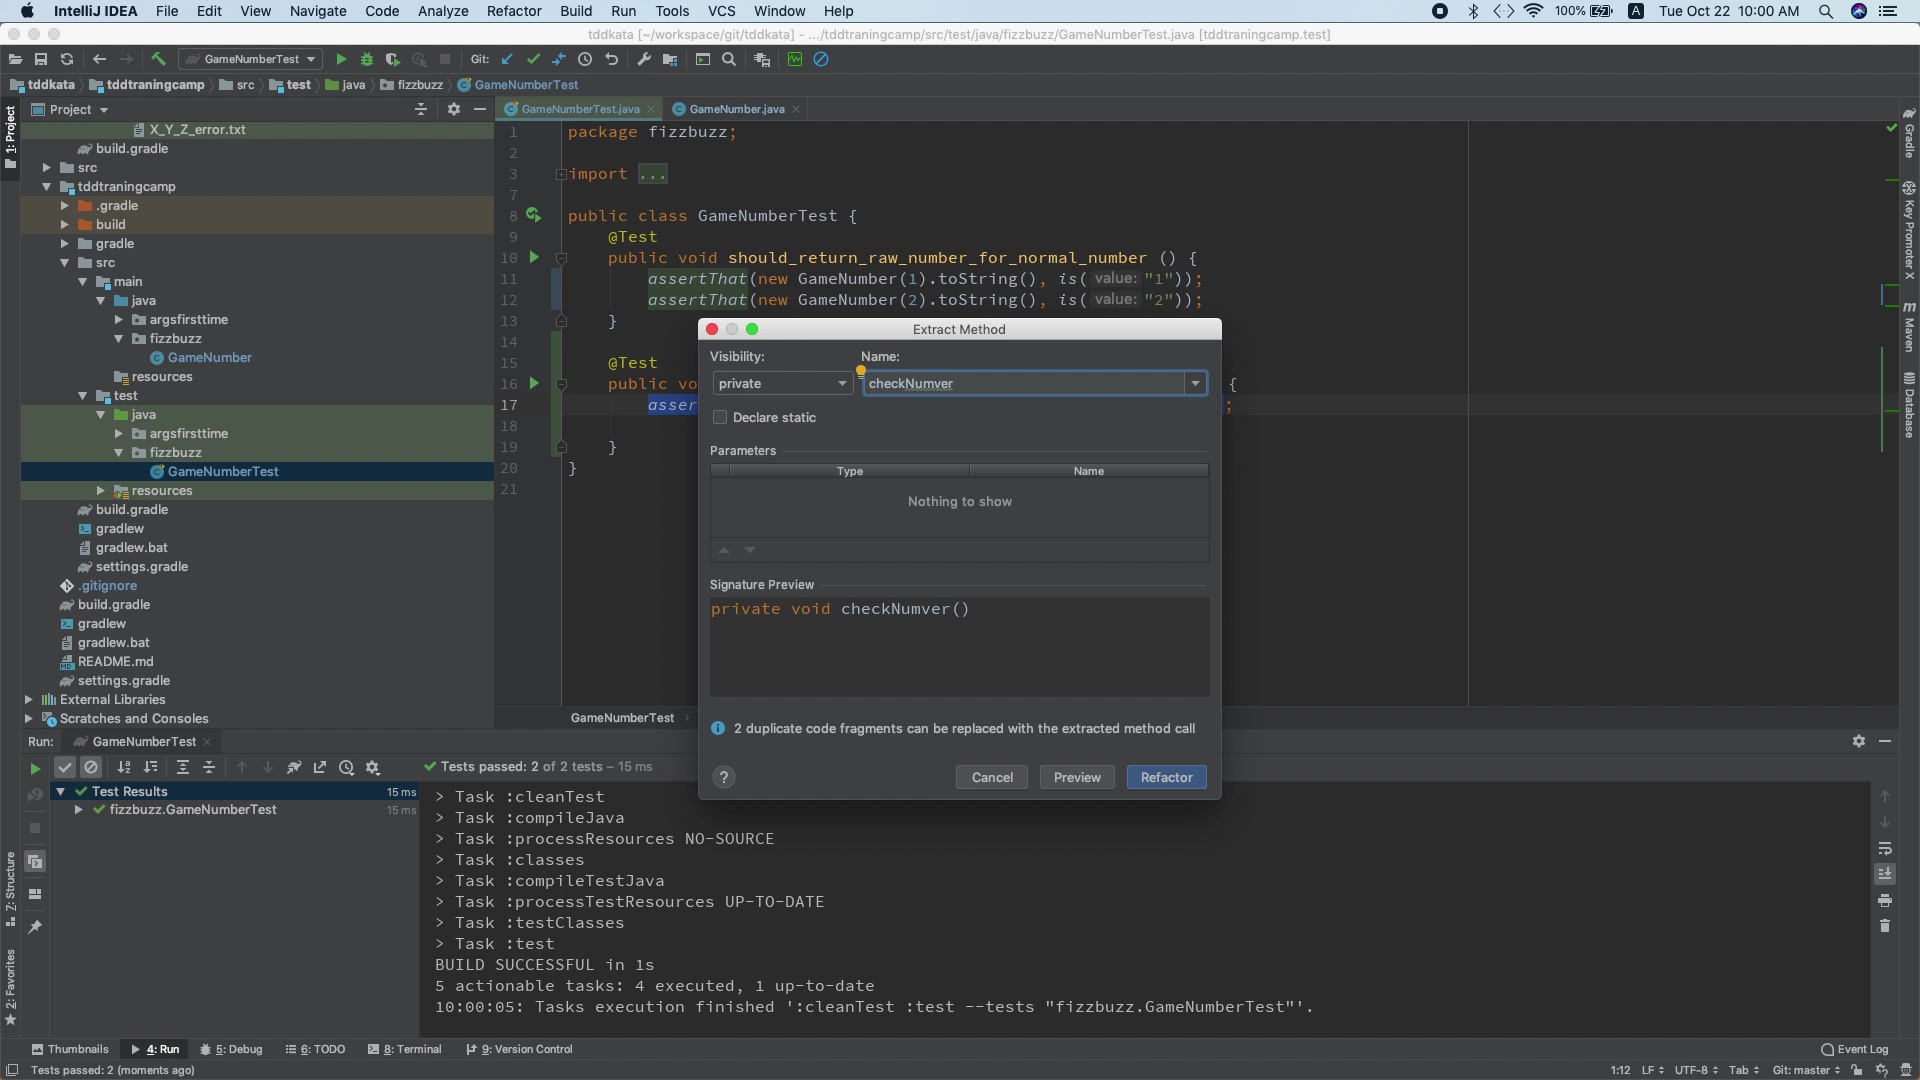
为什么面试官偏爱这道题?
因为fizzbuzz的规则是确定的,任何机器学习模型都无法超越规则引擎,如果你上来就讨论LSTM、注意力机制,说明你缺乏对问题本质的思考,面试官期待的是:你先分析任务,提出“这是一个规则问题,不需要学习”,如果必须实现,则强调特征工程和模型选择。
在北京一线面试中,如何拆解这个题目?
假设你身处北京,面试官抛出这个问题,你可以分三步回答:
- 指出任务本质:整除判断,规则明确。
- 如果非要使用机器学习,建议用逻辑回归或浅层网络,并解释为什么深度学习不适合。
- 展示你的特征工程思路:将数字转化为二进制表示,或者使用one-hot编码,甚至可以加入与3、5的模运算作为特征(但这样已经泄露了规则)。
这种结构化回答展现了你的问题拆解能力,远比直接写一个黑盒神经网络要高明。
如何准备fizzbuzz机器学习面试题?
准备这类面试题,不要只盯着代码,你需要培养一种元认知能力:对每个问题,先划分类型,你可以通过练习其他类似问题来强化,比如用机器学习实现“判断一个数是否为质数”,或者“判断一个字符串是否是回文”,这些规则明确的问题,都能帮你建立判断框架。
常见错误回答与行业共识看法
常见错误是直接套用复杂模型,调参后声称准确率极高,业内专家指出,这种回答暴露了候选人对过拟合的忽视,因为测试集如果包含训练集未覆盖的数字,模型很可能出错,行业共识是:fizzbuzz机器学习面试题没有标准答案,但有标准思维先判断,再选择工具。
fizzbuzz神经网络实现:从零开始搭建一个分类器
如果你好奇“fizzbuzz神经网络实现”具体怎么做,下面是一套完整操作路径,这套流程常用于教学,帮助你理解分类模型在结构化数据上的表现。
数据准备与特征工程的关键
你需要生成数据,从1到1000的数字,标签为四类,这步不难,难的是特征表示,直接把数字输入模型没有意义,必须做特征工程,常见做法有:
- 二进制展开:把数字表示为10位二进制位,每个位作为一个特征。
- 质因数分解:提取是否被3、5整除的标志,但这会引入规则,导致模型失去纯学习意义。
- 频率统计:比如计算数字的各位数和,与3、5的关系。
这些特征中,二进制展开是最常用的,因为它保留了数字的数值结构,又不直接泄露规则。
模型选择与训练实操
推荐使用一个简单的神经网络,输入层10个节点(二进制位),隐藏层32个节点,ReLU激活,输出层4个节点,softmax,训练时注意:
- 使用交叉熵损失。
- 学习率0.01,Adam优化器。
- 训练100个epoch,早停法防止过拟合。
具体实现可以这样:
- 导入Keras或PyTorch。
- 定义模型结构:Sequential,添加Dense层。
- 编译模型,指定优化器和损失函数。
- 用生成的数据训练,同时监控验证集损失。
- 评估模型在测试集上的准确率。
训练过程中的常见陷阱
你会发现,学习率设置不合理会导致收敛缓慢或震荡,数据量太小,模型很容易记住所有训练样本,导致过拟合,这时,你可以尝试增加正则化项,比如Dropout或L2正则化,但效果有限,因为根本问题在于任务与模型的不匹配。
评估结果:为什么准确率很高仍不可靠?
你会发现,模型在训练集和测试集上准确率可能相当高,但当你输入一个超出训练范围的新数字,比如10000,模型可能输出错误类别,因为模型并没有学会“整除”这个抽象概念,而是记住了训练集中数字与标签的映射,这就是过拟合的典型表现,fizzbuzz神经网络实现只能作为教学案例,不能用于实际。
对比:传统算法 vs fizzbuzz机器学习,哪个更实用?
这个对比很明显,但我们可以深入分析。
性能与可维护性对比
传统算法:一行条件判断,O(1)时间,无数据依赖,维护成本几乎为零,机器学习:需要GPU训练,模型文件可能数MB,预测时还需加载模型,推理速度慢,且需要持续监控数据分布是否变化。
| 维度 | 传统编程 | 机器学习 |
|---|---|---|
| 开发速度 | 几分钟 | 几小时甚至几天 |
| 可解释性 | 完全透明 | 黑盒,不易解释 |
| 泛化能力 | 规则不变则完美 | 可能因数据偏差而导致错误 |
| 所需数据 | 不需要 | 需要大量标注数据 |
| 维护成本 | 低 | 高,需要持续监控模型漂移 |
| 资源消耗 | 极低 | 可能需要GPU和大量内存 |
fizzbuzz算法与机器学习在资源消耗上的对比
传统算法只需要一个CPU周期,而机器学习的训练过程可能需要数百个epoch,每次迭代都要计算梯度,在资源消耗上,机器学习是传统算法的成百上千倍,在fizzbuzz这种小任务上,传统算法完胜。
什么时候该用机器学习?
当规则复杂到人类无法手动编写时,或者当规则随着时间动态变化时,机器学习才值得考虑,人脸识别、语音识别、情感分析,而fizzbuzz这种确定性规则,永远不该用机器学习。
一个真实案例:规则引擎 vs 机器学习
在金融风控中,初期规则引擎可以覆盖大部分欺诈模式,但随着欺诈手段变化,规则需要不断更新,这时机器学习可以通过学习历史数据自动发现新规则,但规则引擎仍有其价值,比如处理简单逻辑,fizzbuzz对比是一个极端案例,让你明白两种工具的边界。
搜索“fizzbuzz机器学习”的用户,到底想找什么?
从搜索趋势看,这个词的搜索量在每年毕业季和招聘季出现峰值,用户群体集中在校招求职者和转行学习者。
面试准备类查询
用户很可能在准备面试,搜索“fizzbuzz机器学习面试题”来了解如何应对,这类用户需要的是思维框架,而非具体代码。
教学实验类查询
另一类用户想了解“fizzbuzz神经网络实现”来学习模型构建,他们可能正在学习机器学习,需要一个简单数据集来实践分类模型。
代码实现类查询:fizzbuzz 机器学习 代码 实战”
这类用户希望直接拿到可运行的代码,在文章中提供清晰的代码步骤和资源链接(概念上)会很有价值,注意,这些代码通常托管在GitHub上,你可以搜索“fizzbuzz machine learning”找到相关仓库,但请根据自己的需求选择。
从fizzbuzz学习机器学习的核心概念:泛化与过拟合
这个案例是理解泛化和过拟合的最佳教材。
泛化能力为何重要
机器学习模型的目标是泛化到未见数据,fizzbuzz模型在测试集上表现好,但泛化到新数字时失败,说明它没有学到真正的模式,这提醒我们,在真实项目中,交叉验证和对抗验证非常重要。
过拟合的早期信号与应对
在训练过程中,如果验证集准确率停滞不前而训练集准确率持续上升,这是过拟合的迹象,在fizzbuzz这种任务中,由于数据量小且特征简单,过拟合尤其容易发生,学会识别这些信号,能帮你避免部署无用模型,应对方法包括增加数据量、使用正则化、简化模型等。
fizzbuzz机器学习是一个绝佳的反面教材,它教会我们尊重问题的本质。真正的高手,不是会用所有模型,而是能快速判断什么时候该用、什么时候不该用。 下次遇到类似问题,先停下来想一想:这是fizzbuzz吗?
Q&A
Q1: fizzbuzz机器学习面试题该怎么准备?
A1: 准备的关键不是背代码,而是理解问题类型,你可以自己练习:拿一个简单规则问题,尝试用机器学习实现,然后分析其局限性,这样就能在面试中游刃有余。
Q2: 有没有什么工具可以快速实现fizzbuzz神经网络?
A2: 可以用Keras或PyTorch,在Keras中,你只需十几行代码就能搭建一个全连接网络,但记住,这只是教学工具,不要用于生产环境。
Q3: 为什么我的fizzbuzz模型在测试集上准确率很高,但新数据上表现很差?
A3: 这是典型的过拟合现象,因为模型学到的不是规则,而是数据与标签的固定映射,要解决这个问题,可以增加训练数据的多样性,或者使用正则化技术,但最好的办法是回归规则引擎。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/fizzbuzz%e6%9c%ba%e5%99%a8%e5%ad%a6%e4%b9%a0%e6%98%af%e4%bb%80%e4%b9%88%ef%bc%8c%e5%a6%82%e4%bd%95%e5%ad%a6%e4%b9%a0%ef%bc%9f/