FPS观战系统的额外开销,大头不在画面渲染,而在“多路编码转发”:每新增一路观战视角,带宽大致要多占一条直播流的码率,算力则要多出接近一路独立的渲染与编码任务。 多数玩家以为观战只是“多看一块屏幕”,实际是服务器或主机要同时跑好几份游戏画面、状态同步和推流管线,本文拆开算这笔账,再给你可落地的压榨方案。
FPS观战系统占用带宽大不大?先算清三笔账
很多人拿“看直播”类比观战,觉得不就是在现有画面上加一路输出吗?差远了,FPS观战系统的带宽负担要分成三块:

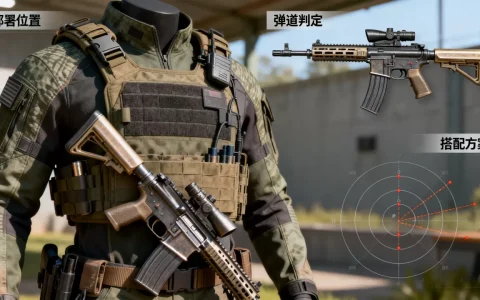
- 游戏逻辑同步流量:玩家位置、准星朝向、弹道、道具状态、血量变化这些数据,观战端每帧都要收到,单这一路数据不大,但观战人数一多,服务器就要反复广播,累积起来很可观。
- 画面编码流量:观战视角往往不是玩家第一人称,而是自由视角或第三人称追尾视角,意味着服务器要额外渲染一整份画面,然后单独编码、单独推流,这才是带宽的大头。
- 观战指令回传流量:观战者拖动视角、切换目标、打开记分板,这些交互指令会反馈给服务器,触发新的场景请求,频繁切视角时,瞬时带宽会跳高。
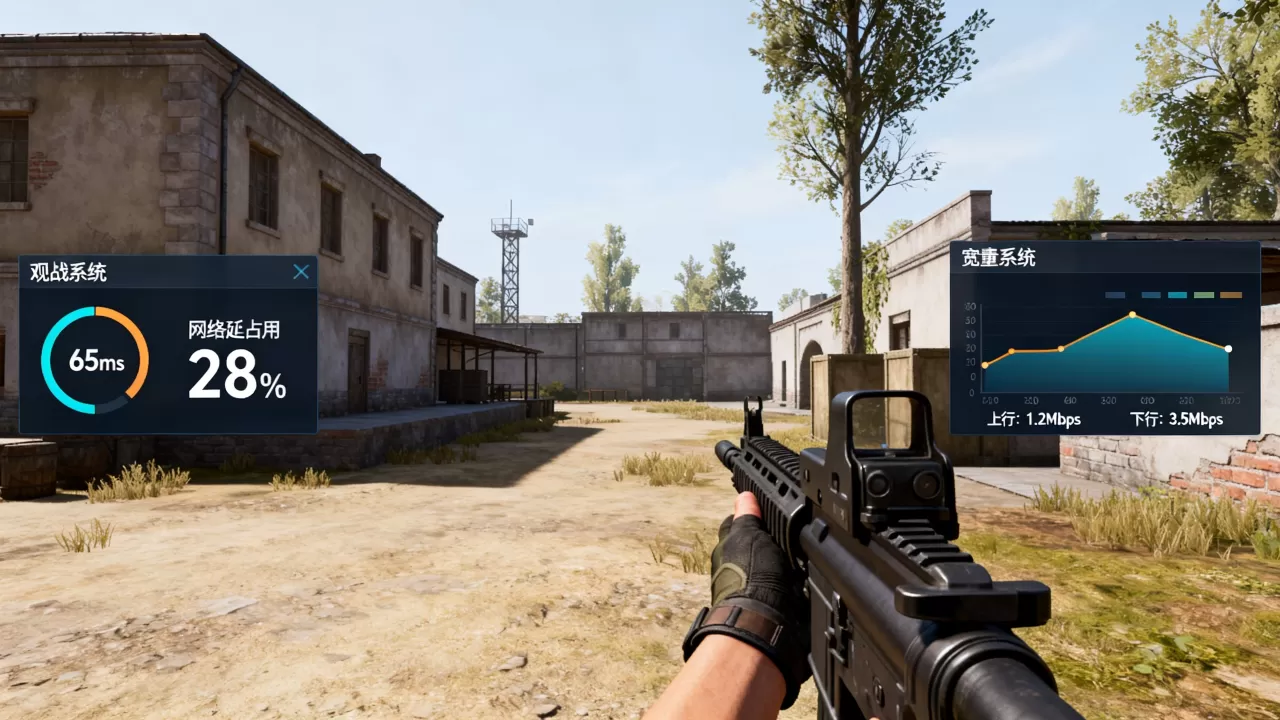
真正吃带宽的不是第一项,而是第二项,以常见的1080P 60帧直播码率来看,一路观战视角的码率普遍在6Mbps到8Mbps,如果开四路不同视角,上行带宽轻松突破30Mbps,普通家庭宽带的30Mbps上行在这个场景下基本见底。
同一场对局,单人直播和观战位的算力差异在哪
单人直播时,你只需要把玩家画面编码推出去,渲染管线只有一份,观战系统则完全不同:
- 每多一个观战视角,就多一份独立场景渲染,显卡的顶点处理和光栅化负载直接翻倍。
- 每路画面都需要单独编码,编码器不吃显卡渲染单元,但要占用独立的视频编码模块和CPU资源。
- 观战端如果还要做回放、慢动作、子弹轨迹追踪,CPU要额外承担物理回放计算。
业内专家指出,多路编码才是观战系统算力开销的主要来源,渲染本身的负担反而排在第二位,比如CS2内置的观战系统,用软件编码推流时,CPU占用率比单路直播高出接近一倍,即便用硬件编码,显卡的视频编码单元也会被占满,导致游戏主视角帧率下滑。
FPS观战系统配置要求里,算力到底消耗在哪
要判断一台机器能不能扛得住观战压力,先搞清楚三块算力去处:
- 场景渲染:不同视角意味着不同视锥体、不同物体剔除结果,GPU每帧执行多次绘制指令,这就是为什么观战视角越多,显卡越吃力。
- 动态编码:每路画面要用H.264或H.265压缩,编码参数(码率、GOP长度、编码档次)直接决定CPU占用高低,纯CPU编码时,4路720P广播就可能吃满一颗8核处理器。
- 状态快照与同步:服务器要维护每个观战者的可见实体列表、雾面剔除、弹道预测,这部分数据不重,但数据包非常碎,对CPU主频和网络中断处理能力要求高。
本地观战和远程观战,资源消耗差异悬殊
同样是观战,一个在局域网内看回放,一个在公网远程看OB视角,额外开销完全不同。
- 本地LAN观战:带宽几乎不计,主要吃宿主机显卡和编码器资源,延迟低到可以忽略。
- 公网远程观战:需要经过服务器或主播机中转,编码后的视频流推送出去,带宽、延迟、丢包重传全部成为变量。
- 网页嵌入观战(比如比赛平台的实时战况页):往往降低码率和帧率,走的是另外一套低延迟协议,算力需求相对小,但画质牺牲明显。
所以讨论配置要求时,必须先说清楚是哪种观战场景,行业共识认为,远程多路观战的硬件需求是本地单路观战的三倍以上,这不是同一维度的问题。
几类观战场景,额外开销差好几倍
FPS游戏观战有几个典型场景,资源消耗差异非常明显。
游戏内置观战系统
CS2、Valorant这类竞技游戏自带观战接口,负责接收全部玩家的游戏状态数据,它的特点是:
- 观战延迟低,画面与战局基本同步。
- 但每增加一个观战席位,服务器的数据分发压力线性增长

。
- 对本地主机的额外资源占用集中在渲染和编码,游戏逻辑开销不大。
第三方OB工具与直播平台插件
现在很多主播用OBS配合游戏内视角切换做OB,这种方式下,OBS本身要捕获游戏画面、叠加UI元素、再推流出去,比起游戏内置观战,多了一层采集和滤镜处理的算力开销,如果同时开启场景预设切换、转场动画、关键帧缓存,CPU和显卡显存的占用会再高一截。
自建观战服务器
打比赛或开黑时自建观战服,把游戏服务器和观战流转发分开,这种方式下原始带宽和算力成本由公网服务器承担,玩家端压力小,但服务器配置上需要预留多路编码资源和足够带宽,FPS观战系统搭建价格随地域和机房等级浮动较大,一线城市的BGP带宽月租普遍比二三线城市贵出一截,自建时务必把带宽成本算进总预算。
怎么压低观战系统的额外带宽和算力
理解了开销来源,优化就好办了,下面这些方法可以直接实操。
调整编码参数,别一味追求高码率
这不是让你牺牲画质,而是去掉无效开销,建议按优先级设置:
- 开启硬件编码:NVIDIA NVENC、AMD AMF、Intel Quick Sync,优先于CPU软编码,能省下大量CPU算力。
- 码率上限控制在8Mbps以内(1080P 60帧画面级别),超出这个值对实际观感提升有限,带宽负担却明显增大。
- 帧率降到50fps或30fps:FPS游戏回放中60帧确实更流畅,但非比赛即时观战场景,50帧几乎看不出差别,带宽直接少一截。
- GOP(关键帧间隔)设置在2秒左右:太长会导致画面切换时解码延迟,太短会增加码率开销。
用NDI或SRT协议替代RTMP直推
常用推流协议中,RTMP走TCP,延迟和重传开销都偏高,观战系统里更适合用:
- NDI:局域网内低延迟传输,CPU占用比RTMP低,适合本地多视角切换。
- SRT:公网传输抗丢包能力强,对带宽波动的容忍度比RTMP高不少。
用OBS做多路观战推流时,不要每条流单独走一遍RTMP到平台,而是先通过NDI汇总到中转机,再统一推送,这样能避免多路重复编码和重复上传。
控制观战人数和分路策略
FPS观战系统可以几人观战而不卡顿,取决于编码路数和带宽上限,实际操作上:
- 超过4路独立视角时,采用合流模式:把多视角拼成一屏再推流,减少编码器压力。
- 观战人数多时,改用单视角轮播:由导播或OB统一切换画面,而不是每人独立视角。
- 非比赛场景,开启“延迟观战”模式:缓冲30秒到1分钟再播放,带宽需求会显著降低。
服务器端部署转码集群
如果你的项目是多人同时观战(比如线上赛事),自建服务器时启用SFU(选择性转发单元)架构,SFU只转发视频流,不解码不转码,服务器资源占用很低,反观MCU(多点控制单元)架构,需要把所有画面混合后再分发,多路观战需求下很快耗尽算力,选型时优先SFU。
Q&A:FPS观战系统常见的三个问题
FPS观战系统可以几人观战而不卡顿?
没有统一上限,取决于三个变量:游戏内置观战位上限、服务器带宽、编码器路数,CS2的赛后回放支持十余人同时观战,Valorant自定义房间最多12个观察者席位,但这是游戏逻辑层面的上限,实际流畅观战人数受限于带宽和编码能力,多数情况下4路1080P普通码率就是一台主流游戏主机的合理边界。
观战会不会降低我自己的游戏帧率?
会,而且明显,开启内置观战,游戏渲染管线多了一份完整场景绘制;如果再开直播推流,编码器抢占GPU资源,帧率可能从高刷新率跌到不稳定的低帧区间,建议把观战和游戏分开在不同设备跑,或使用双显卡方案将编码任务交给独立显卡。
FPS观战系统搭建需要额外买服务器吗?
看规模,三五个人局域网观战完全没必要,公网远程观战且人数较多时,租一台开启硬件转码的云主机更划算,FPS观战系统搭建价格主要受带宽计费模式影响,按流量计费适合低频使用,按带宽计费适合高频常开场景,长期运营的话,独立服务器比家用机上云更稳定,因为公网延迟、断电、上行限速都不受你控制。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/754844.html