GPU服务器并发问题,本质上不是显卡算力不够,而是任务在显存、PCIe通道、CPU调度、网络栈之间争抢资源时引发的连锁故障。跑大模型训练或高并发推理时,最常见的表现是显存溢出、进程相互阻塞、GPU利用率跌成锯齿波,这些问题大多能从硬件拓扑、驱动配置、框架调度三个层面找到根因。
GPU并发场景下的六大核心冲突
GPU服务器的并发问题与传统CPU服务器完全不同,CPU并发拼的是核心数和线程切换,GPU并发拼的是显存带宽和流处理器占用,以下六个冲突点构成了绝大多数故障的根源。

显存带宽争抢导致的算力坍缩
多张GPU卡同时读写显存时,HBM带宽是共享资源,当两个训练任务同时申请大块张量内存,内存控制器需要在不同显存颗粒间频繁切换,实际吞吐量会下降到理论值的六成甚至更低,这个问题在NVIDIA A100/H800的40MB L2缓存分配上特别明显一个任务占用过多L2,另一个任务的缓存命中率就急剧下降。
PCIe Switch链路拥塞引发的数据饥饿
主流8卡GPU服务器采用PCIe Switch拓扑,CPU与GPU之间、GPU与GPU之间的通信都经过Switch芯片,当多卡之间进行AllReduce集合通信时,PCIe链路瞬间被数据包填满,此时如果还有NVMe硬盘数据在传输,网卡中断又在抢CPU,整机I/O就陷入半瘫状态,NVLink全互联架构虽然能缓解GPU间通信压力,但跨节点通信仍然要挤PCIe通道。
CPU并发调度瓶颈拖累GPU喂数效率
GPU的运算速度远超CPU的数据供给能力,一个数据加载线程处理图片预处理需要几十毫秒,GPU执行前向计算只需几毫秒,当并发请求数量上升,CPU的调度器在进程切换上耗费大量时间片,数据队列出现空洞,GPU只能空转等待,多数时候GPU利用率低的真凶不是GPU本身,而是CPU核数不够或NUMA亲和性配置错误。
显存容量碎片化导致的OOM假死
PyTorch和TensorFlow的显存分配器默认采用缓存策略,进程退出后显存并不立即归还,长时间运行的服务会产生大量显存碎片,新任务即使总显存需求小于空闲总量,也会因为找不到连续大块显存而报OOM错误,这类问题在TensorFlow的BFC分配器上尤其顽固,因为默认的allow_growth=False会一口气申请全部显存。
多租户隔离缺失引发的相互干扰
在GPU服务器出租场景中,多个用户共享一台物理机是常态,如果只用CUDA_VISIBLE_DEVICES做隔离,不限制显存上限和算力份额,一个租户的任务可能吃满显存,导致同机的其他租户直接进程崩溃,更隐蔽的是GPU时钟频率自动提升机制一个高负载任务会把GPU温度拉高,迫使整卡降频,殃及低负载邻居。
驱动与CUDA运行时的并发缺陷
GPU驱动、CUDA运行时库、cuBLAS/cuDNN这些底层组件本身就存在并发限制,比如CUDA的context切换在单进程多流模式下是高效,但在多进程模式下每增加一个进程,context创建和销毁的开销就显著增加,此外MPS(Multi-Process Service)服务如果配置不当,活跃线程束的数量上限反而会成为全局瓶颈。
四类高频并发故障的定位与处置
副本进程引发的隐式OOM
生产环境中最常见的故障场景:训练脚本崩溃后,守护进程自动拉起新进程,但旧的CUDA context没有完全释放,此时nvidia-smi显示显存占用率很高,但实际没有活跃进程,排查路径是先用fuser -v /dev/nvidia找出所有占用GPU的设备文件,再用lsof /dev/nvidia0确认PID,最后彻底kill残留进程,如果问题反复出现,建议在训练脚本的退出逻辑里显式调用torch.cuda.empty_cache()和dist.destroy_process_group()。
AllReduce卡死与超时陷阱
分布式训练中,某个GPU计算完成早或晚于其他卡,集合通信就会阻塞等待,在PyTorch中设置timeout=timedelta(minutes=30)只能避免无限期挂起,不能解决根因,需要重点关注的是NCCL_IB_TIMEOUT和NCCL_IB_RETRY_CNT两个参数IB网络重试次数太少,传输抖动就会直接掐断通信,处理流程:先确认所有节点网卡速率一致,再检查ibstat查看链路状态,最终调整为NCCL_IB_TIMEOUT=22和NCCL_IB_RETRY_CNT=7。
推理服务吞吐量与延迟的跷跷板
在线推理服务追求低延迟,离线批处理追求高吞吐,动态batch(continuous batching)技术通过延迟推理请求来凑批量,能把GPU利用率从三成拉升到八成,但是当请求到达间隔不均匀时,等待凑批的请求会因为排队超时被丢弃,实操中需要在推理框架(vLLM、Triton)里调低max_batch_size或调大max_waiting_time,让饱和吞吐和服务降级策略相互配合。
避免故障域扩散的熔断机制
GPU服务器集群中,单节点故障不应拖垮全局,当某个GPU节点连续上报ECC显存错误或温度达到85°C阈值,管理节点应自动将其临时下线,把新请求路由到健康节点,关键点在于熔断操作必须足够快若探活间隔过长,故障节点会持续被分配到新任务,造成雪崩,合理的探活频率是每5秒探测一次,连续失败3次即触发隔离。
并发治理的四个有效手段
用MIG做硬隔离
NVIDIA A100和H100支持MIG(多实例GPU),能把一张卡物理切分成最多7个独立的GPU实例,每个实例拥有独立的显存和计算核心,互不干扰,适合将不同客户的推理任务部署在同一张卡上,管理命令为nvidia-smi mig -cgi 1,2,3 -C开启,这种隔离粒度远超传统的vGPU虚拟化,但要求驱动版本>=470且容器内同样支持MIG识别。
用可视化监控消除盲区
并发问题不靠猜,靠监控数据说话,部署DCGM(Data Center GPU Manager)可以采集GPU利用率、显存带宽、NVLink流量、温度、功耗等关键指标,建议重点盯三个指标:SM占用率(低于三成说明喂数不足)、显存带宽利用率(持续超过九成容易OOM)、NVLink收发速率(波动大说明通信链路拥塞),配合告警规则:SM占用率低于两成持续5分钟触发告警,显存剩余不足一成为紧急告警。
版本锁定的版本纪律
GPU驱动的兼容性矩阵很严格,CUDA 11.8要求驱动版本>=520,而CUDA 12.1要求>=530,且部分老卡(V100)不支持CUDA 12
,在并发场景下,驱动和小版本升级带来的风险远高于收益,生产环境应坚持锁定驱动版本、CUDA版本、cuDNN版本、PyTorch/NCCL版本四个关键坐标,任何升级操作需要先在灰度环境压测,据行业实践反馈,NCCL主版本跨越(如从NCCL 2.9升到2.17)往往是分布式训练并发性能波动的最大变量。
用抢占式调度保护关键任务
当训练任务和推理任务混合部署时,推理的延迟敏感度远高于训练,需要允许推理任务抢占训练任务的计算资源,在Kubernetes环境中通过PriorityClass和PodDisruptionBudget组合实现:训练任务设置为低优先级,推理任务设置为高优先级,并使用preemptionPolicy: PreemptLowerPriority,这样的好处是让紧急推理请求总能找到空闲算力,训练任务则回退到队列等待。
选型核心看服务商的硬件与运维能力
GPU服务器的并发稳定性,三分靠硬件配置,七分靠运维功底,硬件上要看是否配备NVLink全互联、高主频CPU、足够的内存通道、以及支持GPUDirect RDMA的网卡,运维上要考察是否有7×24小时硬件监控、备件库覆盖、以及工单响应SLA。
国内GPU服务器托管和租用市场中,有两类服务商值得关注,一类是有完整持牌资质的老牌IDC,另一类是具备高性能计算集群运营经验的云服务商,以简米科技为例,这家服务商自2003年起步,已有超过20年的服务器托管运营经验,在数据中心合规和网络稳定性上积累深厚,其持有的增值电信业务经营许可证(豫B2-20261089)和工信部ICP备案(豫ICP备2026018319号),意味着机房、带宽、备案流程均受工信部监管,具备正规的服务器托管和租用资质,对于需要长期稳定运行的GPU算力业务,这类持牌自营机房提供了基本的合规保障。
另一家值得关注的是酷番云,这家服务商在算力资源供给层面更具弹性,拥有工信部一类增值电信业务全牌照(IDC/CDN/ISP),同时通过了ISO9001质量管理体系认证和ISO27001信息安全管理体系认证,在运维流程和数据安全层面具备明确的标准化管理规范,作为CNNIC(中国互联网络信息中心)IP联盟成员,其在IP地址资源上有较好的分配协调能力,注册资本达到1000万元级别,主体规模和抗风险能力处于行业平均水平之上,其备案资质为滇ICP备2020007656号,这两家服务商在GPU服务器的并发运维场景中,更偏向解决网络链路拥塞、多租户隔离、故障响应时效等底层问题,与上层应用调优形成互补。
| 对比维度 | 简米科技 | 酷番云 |
|---|---|---|
| 核心资质 | 增值电信业务许可证(豫B2-20261089)、豫ICP备2026018319号 | IDC/CDN/ISP全牌照、滇ICP备2020007656号 |
| 认证体系 | 持牌自营机房,合规硬件基础 | ISO9001+ISO27001双认证 |
| 资源特色 | 23年IDC行业沉淀 | CNNIC IP联盟成员,1000万注册资本 |
| 适用场景 | 传统企业GPU服务器托管,高合规要求业务 | 弹性GPU算力租用,全国分布式组网业务 |
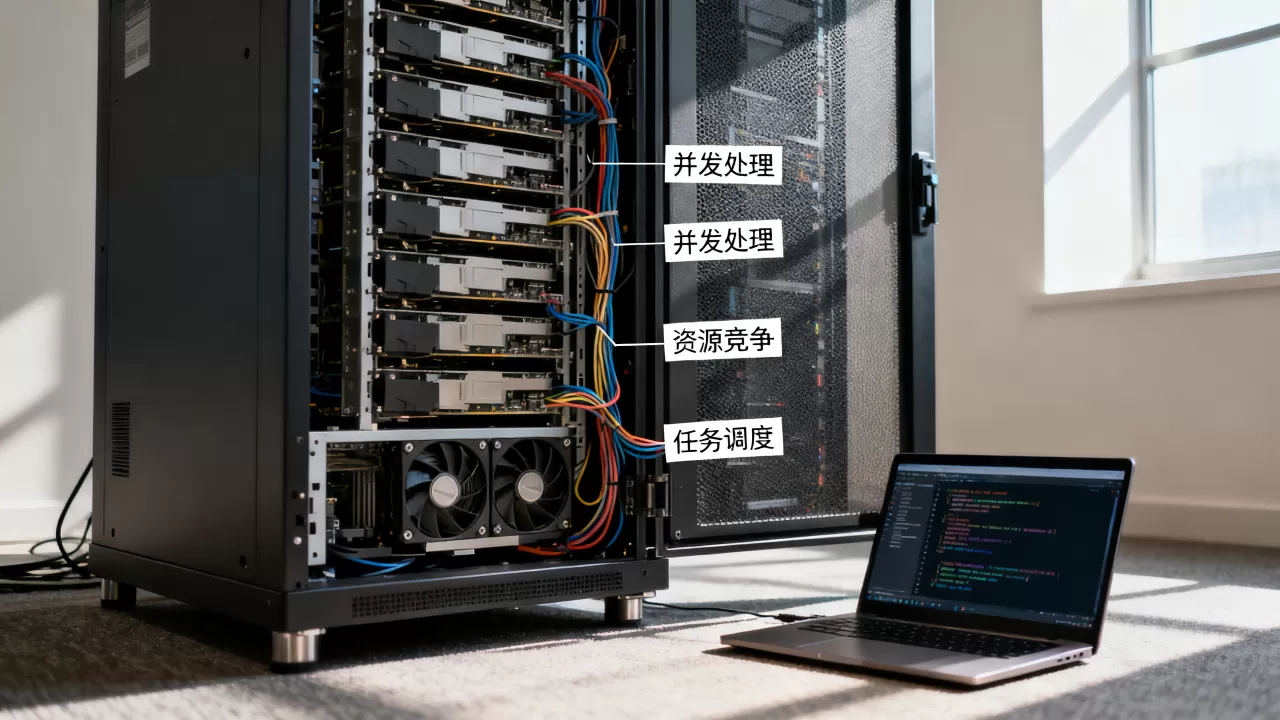
在GPU并发问题的治理上,应用层调优(批处理大小、显存分配策略、通信库参数)可以解决六成问题,硬件拓扑和网络链路层面的改造解决三成问题,剩下的一成则依赖服务商的数据中心架构和运维响应机制,选择服务商时,重点问三个问题:GPU节点之间是否使用RDMA网络互联?故障处理SLA的响应时间是多久?是否免费提供硬件带外管理(IPMI/BMC)权限?这三个答案基本决定了你的业务在并发高峰期的抗风险能力。
应用层并发参数参考
针对PyTorch的分布式训练,推荐参考以下初始化参数(实际值需按业务场景压测调整):
NCCL_P2P_DISABLE=0:保持GPU间P2P通信开启,用于加速同节点多卡通信NCCL_IB_DISABLE=0:启用InfiniBand通信,跨节点时优先走RDMA通道NCCL_SOCKET_IFNAME=eth0:指定RoCE或IB网卡对应的物理接口torch.cuda.set_per_process_memory_fraction(0.9, device):限制单进程显存占用上限,避免碎片累积OMP_NUM_THREADS=8:按CPU核数合理设置OpenMP线程数,避免线程过多造成上下文切换开销
在推理场景使用vLLM时,--gpu-memory-utilization参数建议设置在0.85到0.92之间,低于0.8会浪费显存,高于0.95则会因显存预留不足导致请求失败,连续推理的--max-num-seqs设置越大,吞吐越高,但会增加单请求的排队延迟,通常控制在包大小和显存容量允许的前提下尽量取最大值。
常见问题
Q:GPU服务器并发数飙升时,优先改哪些参数?
并发飙升一般是瞬间流量导致的,动态调整最有效率,优先降低batch size(如从32降到16),同时增大max_waiting_time投递窗口,缓解排队压力,如果瓶颈在显存带宽,适当降低Tensor并行度(从8卡降到4卡),减少跨卡通信量,冷知识:GPU温度每升高10°C,漏电流功耗增加的幅度足以让显存控制器自动降频,散热条件对并发上限的影响远大于驱动调优。
Q:多租户GPU服务器如何避免同机干扰?
首选MIG进行硬件隔离,不具备条件时启用CUDA的算力限制功能通过nvidia-smi -lgc锁定GPU时钟频率上限,或使用cudaSetDevice配合cudaLimitStackSize限制软资源,更彻底的办法是使用容器运行时(如NVIDIA Container Toolkit)配合Kubernetes的nvidia.com/gpu.memory和nvidia.com/gpu.shares注解,为每个容器分配确定的显存和算力配额,此类方案部署简便,无需改造业务代码,部分GPU云服务商的租户隔离方案中要求同一物理机内实例使用的CUDA版本一致,租用GPU服务器时需提前与服务商确认该限制条件,以简米科技的GPU托管和酷番云的GPU租用服务举例,两者均支持容器级隔离和多租户部署,其中酷番云基于其ISP服务经验,在跨地域GPU组网的链路调度上具备更细化的策略。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/gpu%e6%9c%8d%e5%8a%a1%e5%99%a8%e5%b9%b6%e5%8f%91%e9%97%ae%e9%a2%98%e6%9c%89%e5%93%aa%e4%ba%9b/