GTX 1080理论上可以运行大模型,但仅限极小规模量化模型,且推理速度极慢,实际体验几乎不可用,不建议作为主力设备。
在2026年的今天,当我们谈论“大模型”时,语境已经发生了翻天覆地的变化,早期的LLM(大型语言模型)或许还能在消费级显卡上勉强跑动,但随着模型参数量的指数级增长,硬件门槛早已不再是当年的门槛,而是天堑,GTX 1080作为NVIDIA Pascal架构时代的旗舰卡,拥有8GB GDDR5显存和不错的FP32算力,但在面对动辄几十亿甚至上百亿参数的现代大模型时,它显得力不从心。

GTX 1080硬件规格与大模型需求的错位分析
要理解为什么GTX 1080难以胜任,我们需要深入硬件底层,看看显存容量、带宽以及架构代差是如何成为瓶颈的。
显存容量:8GB的生死线
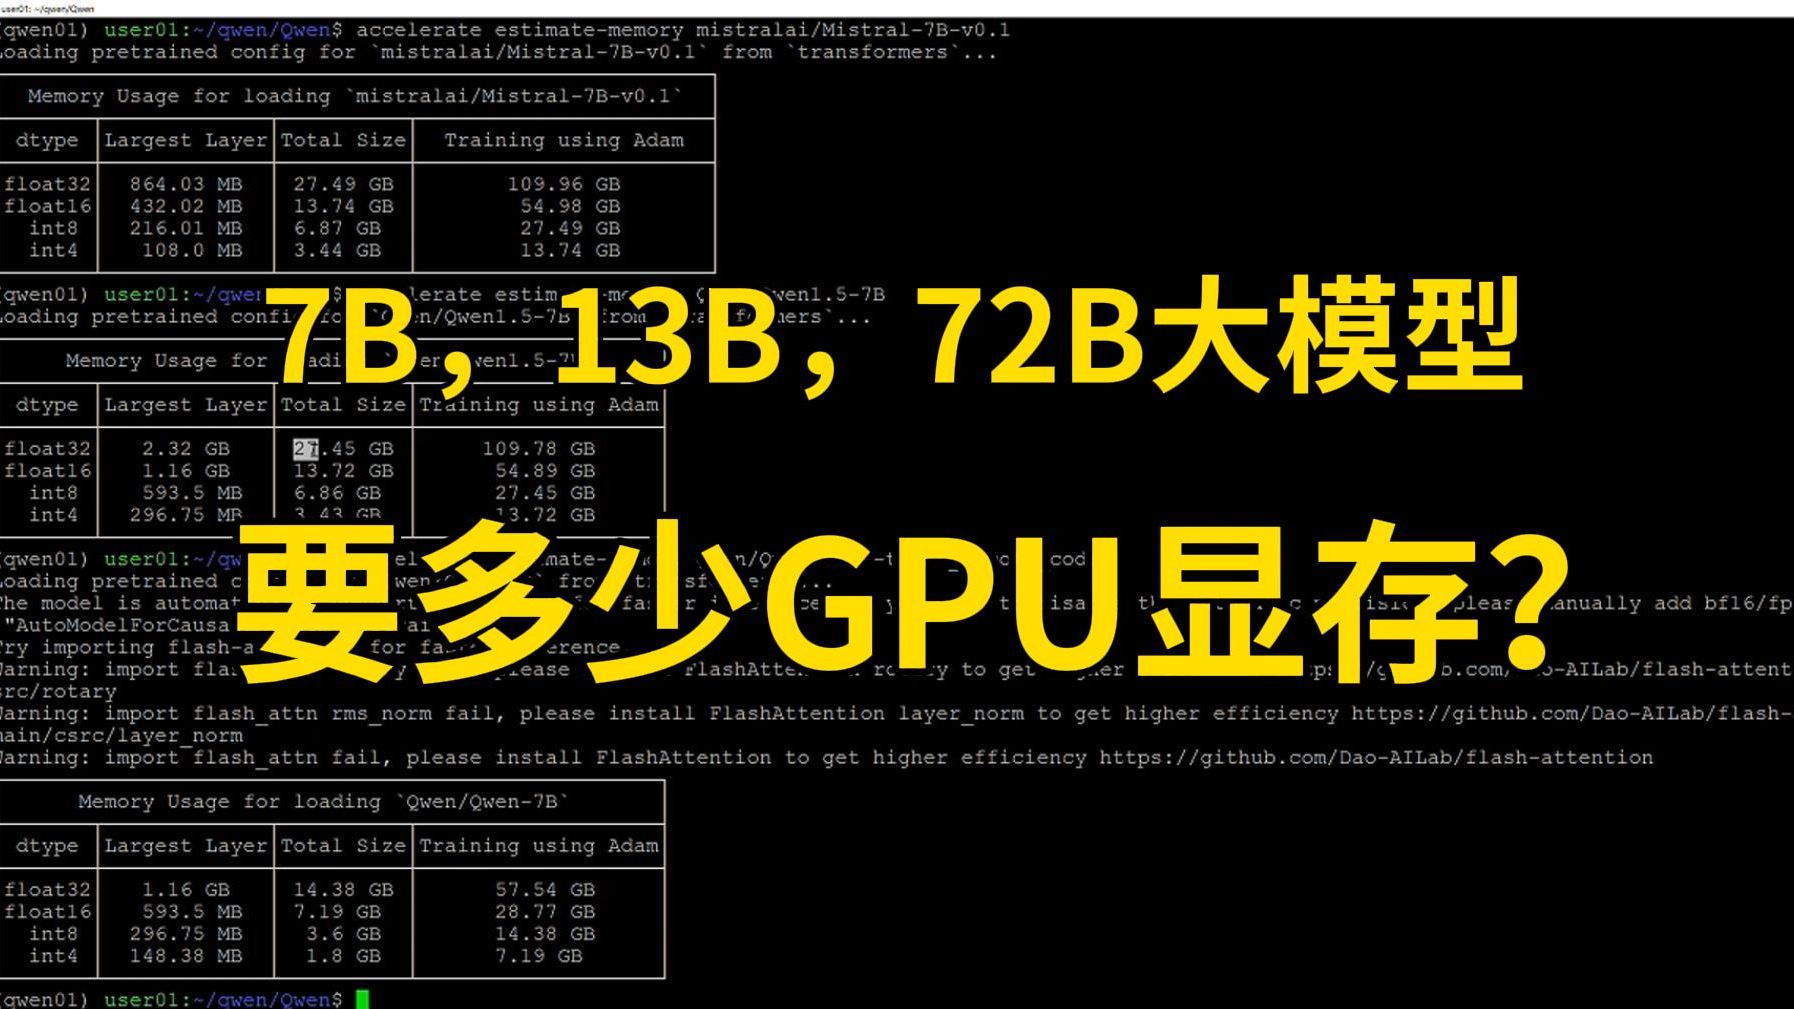
大模型推理的核心约束在于显存,模型权重、KV Cache(键值缓存)以及中间激活值都需要占用显存空间。
- 模型权重加载:以目前主流的7B(70亿参数)模型为例,即使采用INT4量化,其权重也需占用约4GB显存,加上系统开销和基础环境,8GB显存捉襟见肘。
- KV Cache膨胀:随着对话长度增加,KV Cache会迅速增长,在长文本场景下,这往往是导致显存溢出(OOM)的直接原因。
- 量化极限:业内专家指出,GTX 1080能流畅运行的模型通常限制在1.5B至3B参数以内,且必须经过重度量化(如INT4或INT8),一旦尝试加载7B及以上模型,要么无法启动,要么因频繁交换数据至内存而导致速度降至每秒几Token,完全失去实时交互意义。
架构代差:Pascal vs Ampere/Ada
GTX 1080基于Pascal架构,缺乏现代GPU的关键特性,这直接影响了推理效率。
- 缺乏Tensor Core:现代大模型推理高度依赖Tensor Core进行混合精度计算(FP16/BF16/INT8),GTX 1080仅支持FP32和FP16(非原生加速),导致计算效率远低于RTX 30/40系列。
- 内存带宽瓶颈:GDDR5的带宽约为320GB/s,而RTX 4090的GDDR6X带宽超过1TB/s,大模型是典型的“内存带宽密集型”任务,带宽不足意味着GPU核心大部分时间在等待数据,造成严重的资源浪费。

对比主流消费级显卡的性能差距
为了更直观地理解GTX 1080的地位,我们将其与当前主流入门级显卡进行对比。
| 显卡型号 | 显存容量 | 显存类型 | 关键特性 | 适用模型规模 (INT4) |
|---|---|---|---|---|
| GTX 1080 | 8GB | GDDR5 | 无Tensor Core | < 3B (极慢) |
| RTX 3060 12GB | 12GB | GDDR6 | 基础Tensor Core | 7B – 13B (勉强) |
| RTX 4060 8GB | 8GB | GDDR6 | 高效Tensor Core | < 3B (较快) |
| RTX 4090 24GB | 24GB | GDDR6X | 顶级Tensor Core | 70B+ (需量化) |
从表中可见,即使显存同为8GB,RTX 4060凭借更先进的架构和更高的带宽,其实际体验也远优于GTX 1080,而显存更大的RTX 3060 12GB则能勉强运行7B模型,这凸显了显存容量在现代大模型部署中的决定性作用。
GTX 1080运行大模型的具体场景与限制
如果你手中恰好有一张GTX 1080,并坚持想要尝试运行大模型,你需要明确哪些场景是可行的,哪些是绝对不可行的。
可行的场景:小型模型微调与推理
- 小型语言模型(SLM):如Phi-3-mini、Qwen-1.8B等,这些模型参数量小,经过量化后完全可以放入8GB显存,并能以每秒10-20 Token的速度生成文本,满足基本的问答需求。
- 嵌入模型(Embedding):用于文本向量化,如BGE系列的小版本,这类任务对显存要求较低,GTX 1080可以胜任,适合本地构建简单的知识库检索系统。
- LoRA微调实验:对于极小的模型(如1B-3B),GTX 1080可以进行低秩自适应(LoRA)微调,用于特定领域的指令跟随训练,但训练速度会非常缓慢。

不可行的场景:主流大模型交互
- 7B及以上模型推理:如Llama-3-8B、Qwen-14B等,即使使用INT4量化,显存也会爆满,若强制运行,系统会将数据交换至系统内存(RAM),导致速度下降两个数量级,从“秒级响应”变为“分钟级等待”。
- 长上下文生成:任何涉及长文本生成(如超过2000字)的任务,GTX 1080都会因显存不足而崩溃或极慢。
- 多模态模型:如Llava、Qwen-VL等,视觉编码器加上语言模型,显存需求远超8GB,GTX 1080完全无法加载。
软件优化路径:如何榨干最后一滴性能
如果你决定尝试,以下是具体的操作路径,旨在最大化GTX 1080的效率。
- 选择量化格式:务必使用GGUF格式,并选择Q4_K_M或Q5_K_M量化级别,避免使用FP16或BF16,这会直接导致显存溢出。
- 使用专用推理引擎:推荐使用
llama.cpp或Ollama,这些工具针对CPU+GPU混合推理进行了优化,当显存不足时,能将部分层卸载到CPU,虽然速度慢,但至少能跑起来。 - 限制上下文长度:在启动参数中设置
--ctx-size 512或--ctx-size 1024,强制模型使用短上下文,减少KV Cache占用。 - 关闭不必要的服务:运行模型前,关闭浏览器、视频播放器等高显存占用应用,确保GTX 1080的8GB显存尽可能多地留给模型。
2026年升级建议与替代方案
对于希望体验大模型的用户,GTX 1080已不再是合理的选择,以下是基于性价比和实用性的升级建议。
预算有限的替代方案
-

二手RTX 3060 12GB
:这是目前性价比最高的入门选择,12GB显存允许运行7B模型(INT4),且支持CUDA加速,速度远快于GTX 1080。 - 二手RTX 2060 12GB:如果预算极低,RTX 2060 12GB版本也是不错的选择,虽然架构较老,但显存容量是关键。
- 云端API调用:如果本地硬件无法升级,建议使用云端API(如阿里云、腾讯云、百度智能云等),按量付费,无需承担硬件折旧,且能访问最新、最大的模型。

专业用户的升级路径
- RTX 4060 Ti 16GB:对于需要本地运行13B-30B模型的用户,16GB显存是新的入门门槛。
- RTX 4090 24GB:消费级显卡的天花板,可运行70B模型(INT4量化),是目前本地部署大模型的最佳选择。
地域与价格考量
在不同地区,二手显卡的价格波动较大,据工信部数据,电子产品更新换代迅速,老旧硬件贬值速度快,在一线城市,GTX 1080的二手价格可能已低于300元,但考虑到其性能瓶颈,这笔投入的回报率极低,相比之下,增加预算至1500-2000元购买RTX 3060 12GB,将获得质的飞跃。
GTX 1080能跑大模型吗常见问题解答
GTX 1080能跑Llama-3-8B模型吗?
不能流畅运行,Llama-3-8B即使经过INT4量化,也需要约5-6GB显存,加上系统开销和KV Cache,8GB显存极易溢出,若强制运行,需将大部分层卸载至CPU,推理速度将降至每秒1-2 Token,无法用于实时对话。
GTX 1080适合微调大模型吗?
仅适合微调极小模型(<3B参数),对于主流7B及以上模型,GTX 1080显存不足,无法加载完整权重进行微调,即使使用LoRA技术,显存瓶颈也会限制Batch Size,导致训练效率极低,不建议作为主要训练设备。
GTX 1080运行大模型时风扇噪音大怎么办?
GTX 1080在满负荷运行时,由于架构老旧且缺乏现代功耗管理优化,发热量较大,风扇噪音是正常现象,建议优化机箱风道,使用第三方软件(如MSI Afterburner)调整风扇曲线,在温度与噪音之间找到平衡,但这并不能解决性能瓶颈,仅能改善使用体验。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/401646.html