在Hive中查看数据库编码,最直接的方法是使用DESCRIBE DATABASE命令配合EXTENDED关键字,或者通过查询information_schema元数据表来获取字符集和排序规则信息。
很多开发者在搭建数据仓库时,往往会忽略底层存储的字符集设置,直到遇到中文乱码或特殊符号报错才紧急排查,Hive本身作为一个基于Hadoop的数据仓库工具,其元数据管理依赖于关系型数据库(如MySQL或Derby),而数据本身则存储在HDFS上,理解这两层结构的编码差异,是解决“Hive看数据库编码”这一问题的关键。
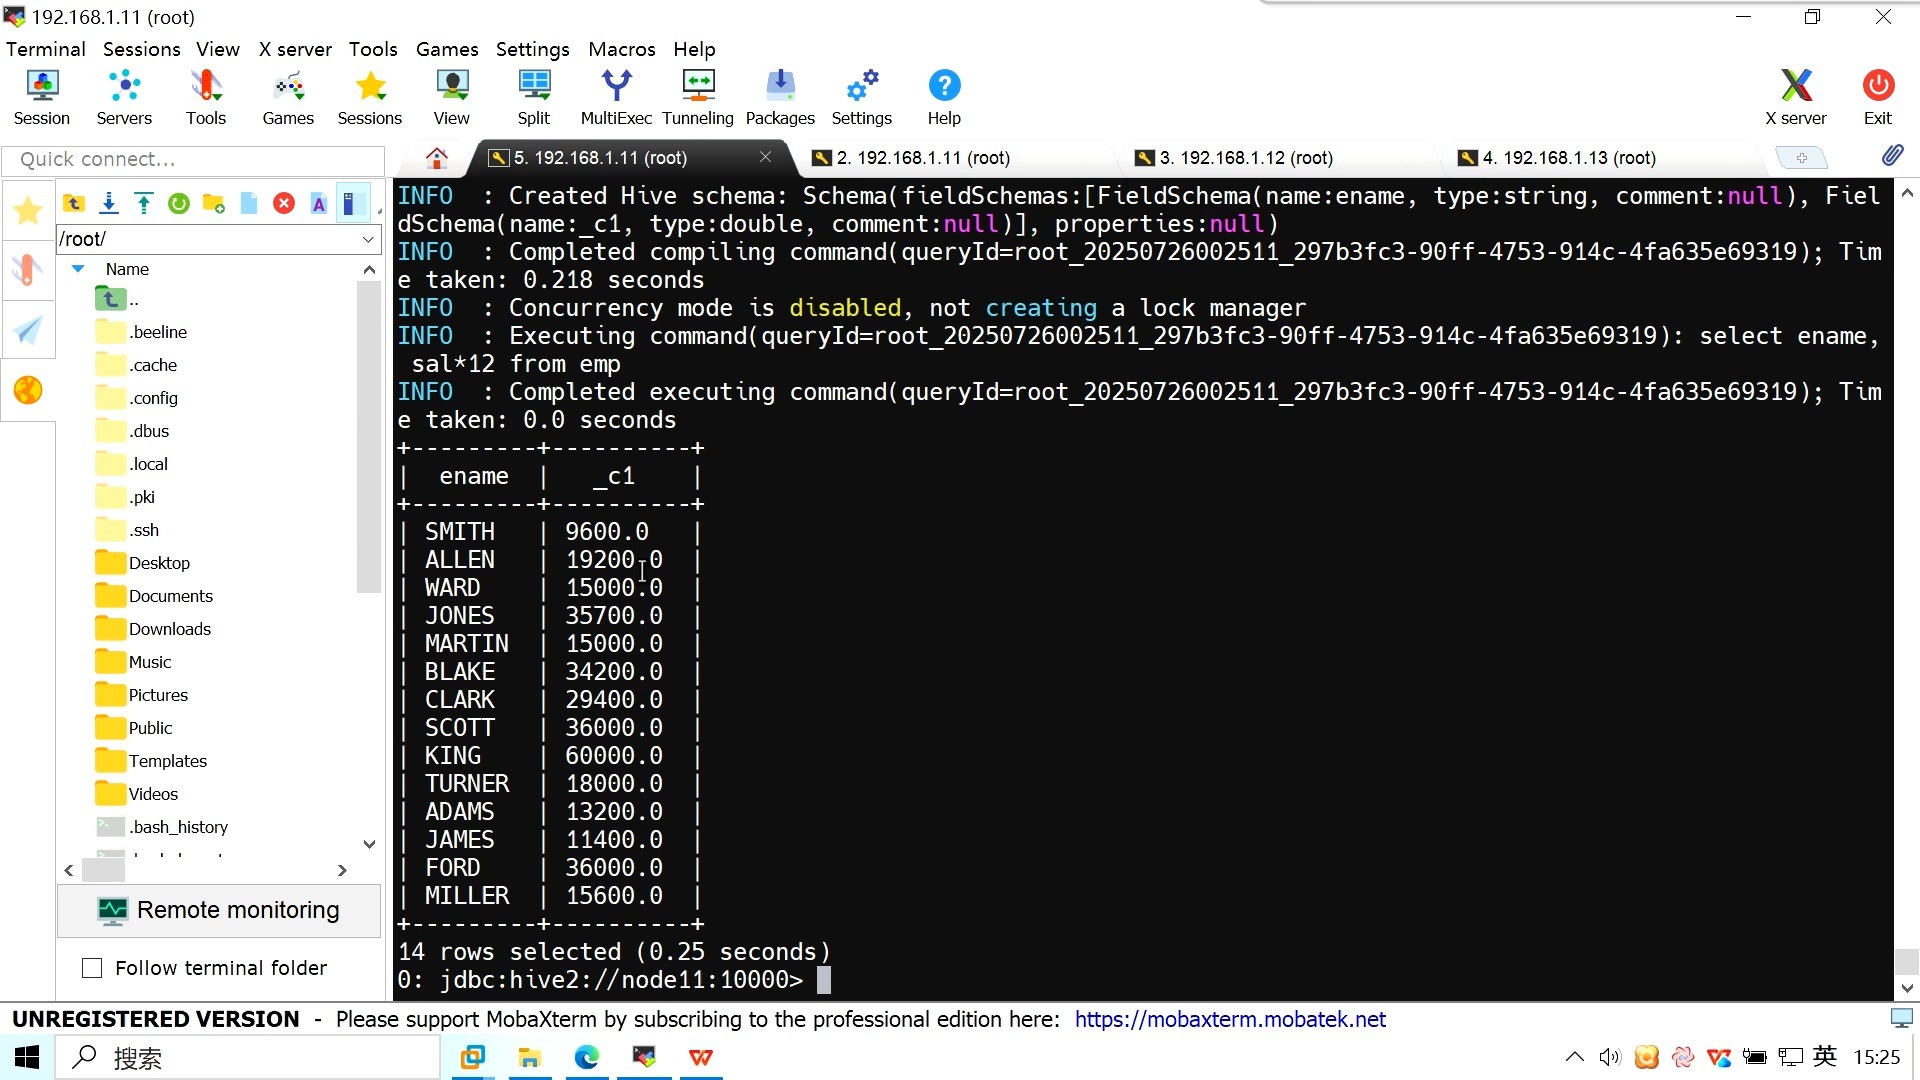
Hive元数据编码查看实操
Hive的元数据通常存储在关系型数据库中,这部分编码决定了表名、字段名等元数据的存储格式,对于大多数企业级部署,MySQL是首选的后端存储。
通过Hive CLI命令直接查询
这是最直观且无需深入底层数据库的方法,当你需要确认当前Hive实例中某个数据库的元数据编码属性时,可以使用以下命令:
- 执行
DESCRIBE DATABASE EXTENDED database_name;
这条命令会返回该数据库的详细属性,在返回结果中,重点查找 Parameter 列中包含 encoding、charset 或 location 相关的行,虽然Hive标准输出中不一定直接显示“UTF-8”这样的字样,但通过观察默认行为,我们可以推断其编码策略。
- 执行
SHOW CREATE DATABASE database_name;
这条命令会生成重建该数据库的SQL语句,在生成的语句中,通常会包含 LOCATION 路径以及可能的 COMMENT 信息,如果数据库创建时显式指定了编码属性,这里会直接体现,某些版本的Hive支持在创建时指定 WITH DBPROPERTIES ('serialization.encoding'='UTF-8')。
查询information_schema系统表

对于熟悉SQL语法的开发者,直接查询元数据数据库中的系统表更为灵活,Hive将元数据映射到了标准的SQL接口中。
- 连接Hive Metastore对应的数据库(如MySQL)。
- 执行查询:
SELECT FROM information_schema.SCHEMATA WHERE SCHEMA_NAME = 'your_database_name';
在返回的结果集中,关注 DEFAULT_CHARACTER_SET_NAME 和 DEFAULT_COLLATION_NAME 字段,这两个字段直接反映了底层元数据存储的字符集,如果显示为 utf8mb4 或 utf8,则说明元数据支持广泛的Unicode字符。
注意事项
需要注意的是,information_schema 的可用性取决于Hive版本及Metastore的实现方式,在较旧的Hive版本中,可能没有完整的 information_schema 支持,此时需直接查询 DBS 表。
数据文件编码与HDFS存储机制
很多用户混淆了“元数据编码”和“数据文件编码”,在Hive中,真正的数据存储在HDFS上,其编码方式取决于数据文件的格式(如TextFile, ORC, Parquet)以及数据写入时的序列化方式。
文本格式文件的编码处理
当使用 STORED AS TEXTFILE 时,Hive默认使用UTF-8编码写入数据,这是Hadoop生态系统的通用标准。
- 验证方法:你可以使用
hdfs dfs -cat /path/to/file查看原始文件内容,或者使用hadoop fs -text /path/to/file尝试读取。 - 如果数据源本身是GBK编码,直接导入Hive会导致乱码,此时需要在导入前进行转码,或在Hive中通过UDF(用户自定义函数)在查询时进行转换。
列式存储格式的编码优势
ORC和Parquet格式不仅提供压缩优势,还内置了复杂的类型系统和编码机制。
- ORC格式:默认使用UTF-8处理字符串,它采用字典编码和游程编码,对中文等非ASCII字符有较好的压缩效果。
- Parquet格式:同样遵循UTF-8标准,并在Schema中明确记录数据类型。

业内专家指出,选择合适的存储格式比纠结于底层编码更为重要,因为列式存储会自动处理字符集的元数据标记,只要写入时编码一致,读取时通常不会出现问题。
常见乱码场景与排查路径
在实际生产环境中,“Hive看数据库编码”往往是为了解决乱码问题,以下是几种典型场景及解决方案。
中文显示为问号或乱码
这通常是因为数据源编码与Hive元数据编码不一致,或者Hive客户端连接编码不匹配。
- 检查数据源:确认原始数据文件是否为UTF-8,如果不是,使用
iconv或 Python脚本在导入前转换。 - 检查Hive客户端:确保你的Beeline或Hive CLI客户端终端支持UTF-8,在Linux环境下,检查
LANG环境变量,确保设置为zh_CN.UTF-8或en_US.UTF-8。 - 检查JDBC连接:如果使用Java或Python连接HiveServer2,URL中应包含
characterEncoding=UTF-8参数。
特殊符号截断
如果数据中包含Emoji或生僻字,而底层数据库使用的是 utf8(3字节)而非 utf8mb4(4字节),会导致截断或错误。
- 解决方案:升级Metastore后端数据库(如MySQL)的字符集为
utf8mb4,并重建Hive元数据表或进行迁移。 - 验证:再次执行
DESCRIBE DATABASE EXTENDED,确认相关属性已更新。
跨系统数据交换乱码
当Hive数据导出到Excel或与其他系统交互时,编码转换是常见痛点。
- 建议:在导出时,明确指定输出编码为UTF-8,并在接收端正确识别,避免使用GBK等遗留编码进行跨平台交换。

最佳实践与预防策略
为了避免未来出现编码问题,建议在数据仓库设计阶段就确立统一的编码标准。
统一UTF-8标准
- 元数据层:确保MySQL Metastore使用
utf8mb4字符集。 - 数据层:所有导入Hive的数据文件统一转换为UTF-8。
- 应用层:所有连接Hive的客户端工具(Beeline, JDBC, ODBC)均配置为UTF-8。
自动化检测脚本
可以编写一个简单的Shell或Python脚本,定期扫描Hive数据库,检查是否存在非UTF-8编码的数据文件。
- 步骤:
- 列出所有表。
- 抽样读取文件头。
- 检测字节序列是否符合UTF-8规范。
- 标记异常文件并告警。
Q&A:关于Hive编码的常见问题
Hive中如何快速判断当前数据库的字符集?
使用 DESCRIBE DATABASE EXTENDED db_name; 命令查看输出中的属性字段,若未明确显示,通常默认为UTF-8,对于元数据存储,可查询 information_schema.SCHEMATA 表的 DEFAULT_CHARACTER_SET_NAME 字段。
Hive导入GBK编码数据会乱码吗?
会,Hive默认期望UTF-8编码,如果直接导入GBK数据,中文将显示为乱码,解决方法是在导入前将数据转换为UTF-8,或在Hive中创建表时使用 ROW FORMAT SERDE 配合特定的编码转换UDF。
修改Hive数据库编码会影响已有数据吗?
修改元数据层的字符集(如MySQL中的DBS表)通常不会影响HDFS上已存储的数据文件内容,如果元数据编码不支持某些字符,可能会导致表名或字段名操作失败,对于数据文件,编码是文件本身的属性,修改Hive元数据不会自动转换文件编码,需手动重新导入或转换文件。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/465498.html