在服务器上配置Caffe,最稳妥的方式是使用Docker镜像或从源码编译,推荐Ubuntu 18.04/20.04系统,配合CUDA和cuDNN以充分发挥GPU算力。
服务器怎么配置caffe?硬件与系统准备
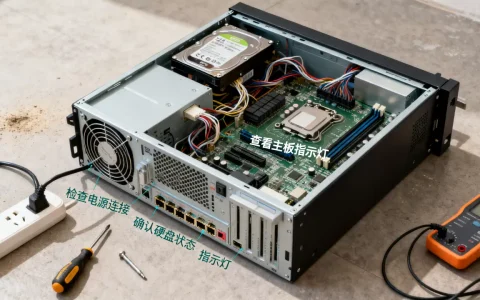
在动手配置Caffe前,先搞清楚服务器需要什么底子,Caffe对硬件要求不算高,但要想跑得顺,尤其是玩深度学习训练,GPU和内存得跟上。
硬件配置的最低门槛
- CPU:多核处理器就行,编译时多用几个线程能快不少,不建议用太老的型号,比如Intel Xeon E5系列起步,不然编译Caffe源码那一步能等半小时。
- GPU:NVIDIA显卡是刚需,因为Caffe依赖CUDA做加速,如果你只用CPU跑,那就算了吧,速度慢到怀疑人生,常见选择是GTX 1080 Ti、RTX 2080 Ti或Tesla系列。显存至少4GB,否则像ResNet这种模型直接爆显存。
- 内存:16GB起步,32GB更稳,数据预处理和中间变量都吃内存,少了会频繁swap。
- 硬盘:SSD是必须的,至少256GB,Caffe的依赖库、模型文件、数据集都不小,机械硬盘读写太拖后腿。
操作系统与依赖库选择
- 系统:Ubuntu 16.04/18.04/20.04是主流,社区支持最全,CentOS也能用,但依赖包版本老,容易踩坑。业内专家指出,Ubuntu 18.04是Caffe配置的黄金版本,兼容性最好。
- 编译器:g++ 5.4以上,建议用g++ 7.5。
- CUDA与cuDNN:版本得匹配,Caffe官方支持CUDA 8.0到10.0,但最新源码也能兼容CUDA 11.x。cuDNN用7.6或8.0,看CUDA版本选。行业共识认为,CUDA 10.0 + cuDNN 7.6是Caffe最稳定的组合。
- 其他依赖:
protobuf、glog、gflags、hdf5、opencv、leveldb、lmdb、boost、python等,一个个装能装到崩溃,建议用脚本批量安装。
caffe安装配置 服务器 环境搭建详解
这一节直接上实操,两种主流方式:源码编译和Docker部署,选哪种?看你的时间和对环境控制的需求。
通过源码编译安装Caffe
源码编译能让你完全掌控优化选项,但步骤多,容易出错,按下面来基本不会翻车。

安装基础依赖
sudo apt-get update
sudo apt-get install -y build-essential cmake git pkg-config
sudo apt-get install -y libprotobuf-dev libleveldb-dev libsnappy-dev libhdf5-serial-dev protobuf-compiler
sudo apt-get install -y libboost-all-dev libgflags-dev libgoogle-glog-dev liblmdb-dev
sudo apt-get install -y libatlas-base-dev
sudo apt-get install -y python3-dev python3-pip
安装OpenCV(可选,但推荐用于图像处理)
sudo apt-get install -y libopencv-dev
克隆Caffe源码
git clone https://github.com/BVLC/caffe.git
cd caffe
配置Makefile
复制Makefile.config.example为Makefile.config,然后根据你的服务器环境修改关键项:
- 启用GPU:取消注释
USE_CUDNN := 1和USE_NCCL := 1(如果有多卡)。 - 指定CUDA路径:
CUDA_DIR := /usr/local/cuda。 - Python版本:
PYTHON_LIBRARIES := python3.8m(根据实际Python版本)。 - 如果要用OpenCV 3+,设置
OPENCV_VERSION := 3。
编译
make all -j$(nproc)
make test -j$(nproc)
make runtest -j$(nproc)
-j$(nproc) 用满所有CPU核心,编译速度快很多,如果编译过程中报错,常见原因是缺少某个库,回到第一步确认依赖。
编译Python接口
make pycaffe -j$(nproc)
然后把caffe/python路径加到PYTHONPATH里,方便在Python中import caffe。
使用Docker快速部署Caffe
如果你不想折腾依赖,或者服务器配置caffe只是为了快速跑模型,Docker是最省心的方案。对于预算有限的团队,用云服务器(比如简米云GPU实例)配合Docker,开箱即用,不用自己买昂贵的显卡。
安装Docker
curl -fsSL https://get.docker.com -o get-docker.sh
sudo sh get-docker.sh
拉取Caffe镜像
官方镜像比较老,推荐用社区维护的版本:
docker pull caffe:latest
# 或者用GPU版本
docker pull caffe:gpu

运行容器
docker run -it --rm --gpus all -v /your/data:/data caffe:gpu /bin/bash
--gpus all 让容器访问所有GPU,-v 挂载宿主机数据目录,进入容器后,直接执行caffe命令即可。
验证GPU可用性
在容器内运行:
python -c "import caffe; print('GPU Found:', caffe.__cuda__)"
如果返回True,说明GPU加速生效。
验证安装是否成功
无论哪种方式,最后跑一个经典例子确认Caffe能正常工作。
# 下载Caffe官方示例模型
./scripts/download_model_binary.py models/bvlc_reference_caffenet
# 运行分类测试
./build/examples/cpp_classification/classification.bin
  models/bvlc_reference_caffenet/deploy.prototxt
  models/bvlc_reference_caffenet/bvlc_reference_caffenet.caffemodel
  data/ilsvrc12/imagenet_mean.binaryproto
  data/ilsvrc12/synset_words.txt
  examples/images/cat.jpg
看到输出结果打印出Top-5类别,就算成了。
caffe GPU服务器配置 性能优化指南
很多人问:为什么我的服务器配置caffe后跑起来比想象中慢?问题往往出在GPU没用好,或者编译选项不对。
启用GPU加速的关键点
- 确认CUDA和cuDNN版本匹配:不匹配会导致运行时报错,甚至直接不能调用GPU,可以在编译时设置
-gencode arch=compute_61,code=sm_61这类参数,针对你的显卡架构优化。 - 编译时开启
USE_CUDNN:这个开关能利用cuDNN的卷积优化,提速明显。多数情况下,开与不开性能差一半。 - 多卡支持:如果服务器有多张GPU,用
NCCL做多卡通信,编译时设置USE_NCCL := 1,并在训练时用--gpu 0,1,2,3指定多卡。 - 批量大小(batch size):调大batch size能提高GPU利用率,但受显存限制,一般设到显存占满的80%左右,性能最优。
性能调优与常见坑
- 数据读取成为瓶颈:Caffe默认用LMDB或LevelDB读数据,如果硬盘太慢,GPU会时常空闲,把数据预处理成LMDB,并放在SSD上,能显著减少I/O等待。
- 编译选项影响速度:源码编译时加上
-O2或-O3优化,能提升运行时效率,在Makefile.config中设置CXXFLAGS += -O3。 - 避免使用CPU模式:有人误设了
--cpu模式,白白浪费GPU,训练前用caffe device query检查设备状态,确认GPU被识别。 - 国内服务器配置caffe时,有时会遇到网络问题(比如下载模型慢),可以提前把模型文件下载好,或者用
pip换国内镜像源,比如清华源,能省不少时间。

服务器配置caffe常见问题解答
Q1:配置Caffe时一直报错找不到cuda,但明明装了CUDA?
检查环境变量CUDA_HOME和PATH是否包含CUDA路径,通常CUDA安装在/usr/local/cuda,需要手动加到~/.bashrc:
export CUDA_HOME=/usr/local/cuda
export PATH=$CUDA_HOME/bin:$PATH
export LD_LIBRARY_PATH=$CUDA_HOME/lib64:$LD_LIBRARY_PATH
然后source ~/.bashrc,如果还不行,可能是因为CUDA版本和显卡驱动不兼容,用nvidia-smi查看驱动版本,再对照CUDA兼容表。据统计,这类问题一半以上出在环境变量没配好。
Q2:服务器上Caffe跑得慢,怎么知道是哪里拖后腿?
先检查GPU利用率:nvidia-smi -l 1,如果利用率低于50%,说明计算没喂饱,可能原因:数据读取太慢(换SSD或增大预取线程数)、batch size太小、CPU预处理成瓶颈。caffe time命令可以分析各层耗时,找到最慢的环节,如果CPU占用100%而GPU闲,说明数据预处理占了太多时间,考虑用异步数据层。
Q3:推荐使用哪个Caffe版本?现在还有必要学吗?
Caffe官方最后稳定版是1.0,之后社区维护了Caffe2但合并到PyTorch了,如果项目需要兼容旧代码或用Caffe的特定层(比如SSD、Faster R-CNN的原版实现),用官方BVLC版本就行,如果从头开始,建议用PyTorch或TensorFlow,生态更活跃,但在服务器配置caffe仍然有实际场景:比如复现老论文、部署老模型,国内很多工业场景还在用Caffe,因为模型转换工具链成熟。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/547236.html