


Hive数据仓库架构图解的核心在于理解其将HDFS分布式存储与MapReduce/Tez计算引擎解耦的设计,通过元数据服务(Metastore)实现SQL对底层复杂分布式计算的透明化映射。
在大数据生态系统中,Hive扮演着“翻译官”的角色,它将结构化的数据文件映射为一张数据库表,并提供类SQL的查询语言HQL,对于习惯了传统关系型数据库的开发人员来说,这种架构极大地降低了使用大数据的门槛,要真正驾驭Hive,必须深入剖析其内部组件是如何协同工作的。
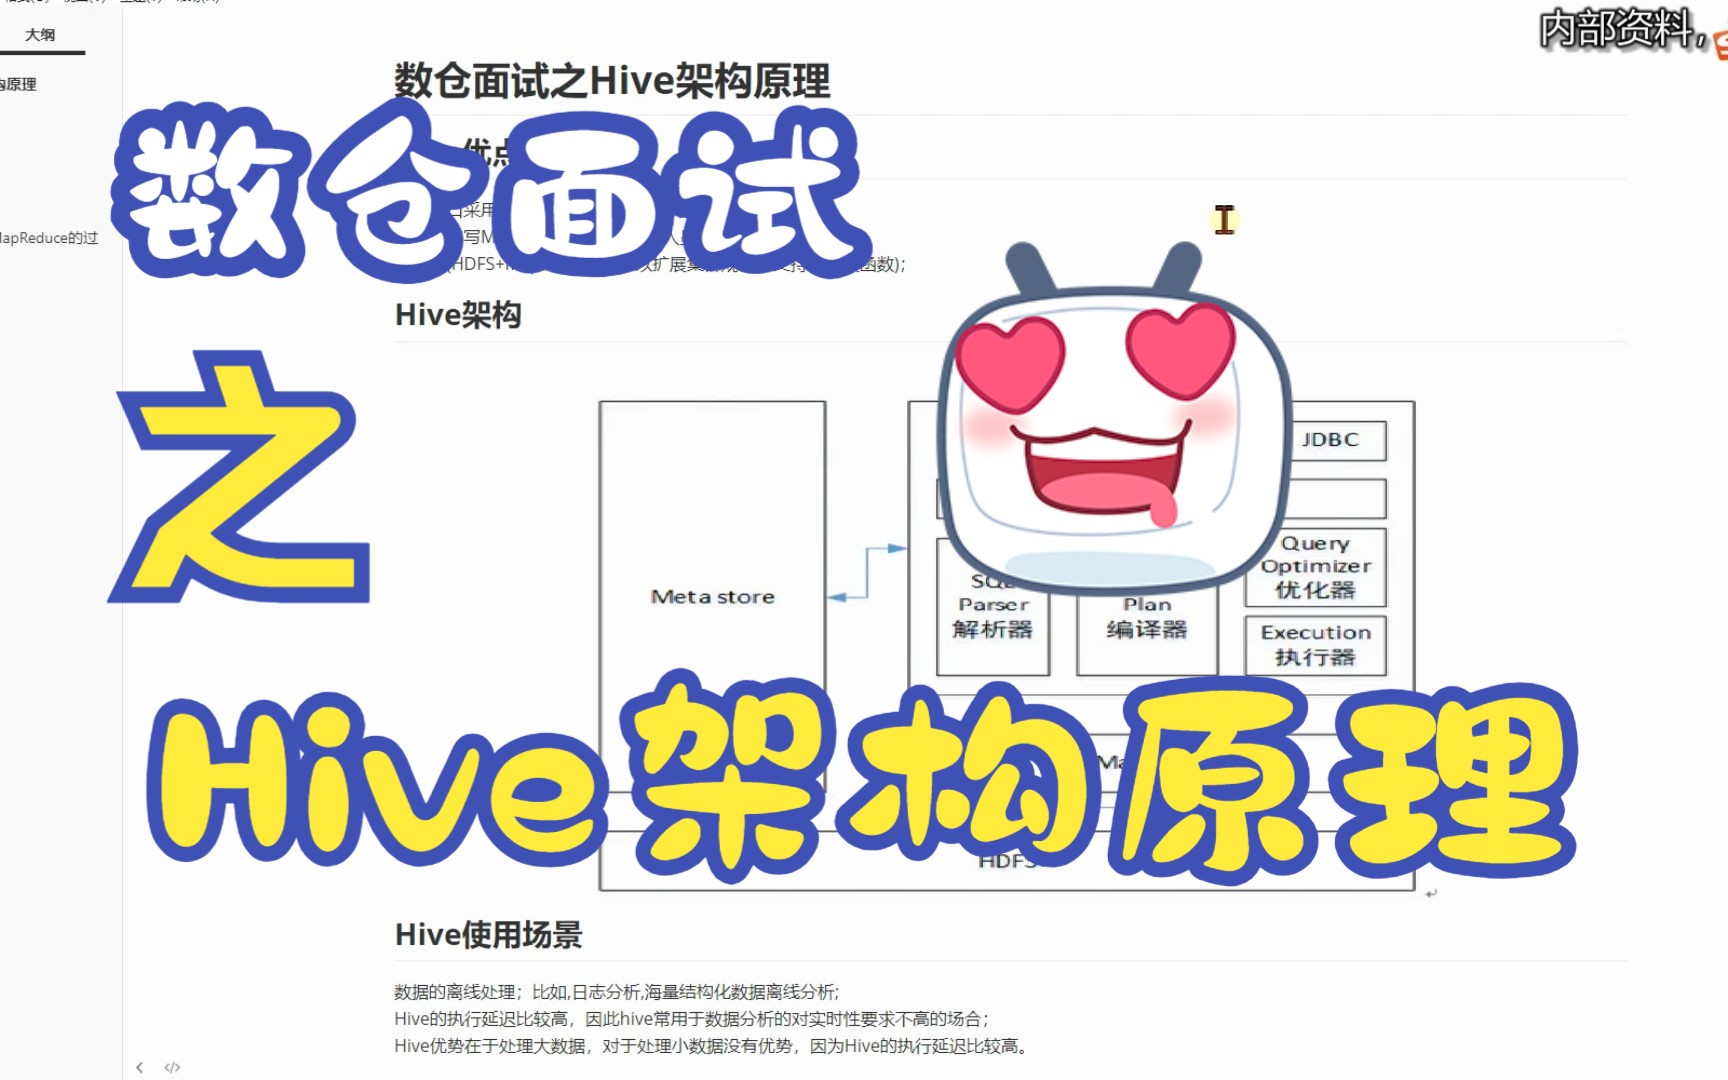

Hive核心组件架构深度解析
Hive的架构并非简单的单体应用,而是一个由多个独立服务组成的生态系统,理解这些组件的职责边界,是优化查询性能和解决故障的关键。
用户接口层:交互的入口
用户接口层主要包含三种访问方式,它们对应不同的使用场景和权限控制。
CLI(命令行接口)
这是最基础的交互方式,通过Shell脚本直接执行HQL语句,它适合自动化脚本和批量数据处理任务,无需图形界面支持,资源消耗最低。
Web UI
早期版本提供的Web界面,用于查看作业进度和日志,随着Hue等工具的普及,原生Web UI的使用频率已大幅降低,但在调试阶段仍具参考价值。
Thrift Server(JDBC/ODBC驱动)
这是企业级应用中最常用的接口,它允许Java、Python等应用程序通过标准的JDBC或ODBC协议连接Hive,这种架构支持多用户并发访问,是BI工具(如Tableau、FineBI)对接Hive数据源的标准通道。
元数据服务(Metastore):数据的目录
Metastore是Hive架构中至关重要的一环,它存储了表名、列、分区、属性以及表数据所在的HDFS位置等元数据信息。
业内专家指出,元数据的存储方式直接影响Hive的扩展性,默认情况下,Metastore使用内嵌的Derby数据库,但这仅支持单会话连接,极易产生冲突,在生产环境中,必须将元数据存储在MySQL或PostgreSQL等外部关系型数据库中,这种分离设计不仅解决了并发访问问题,还使得元数据的管理更加稳定和安全。

驱动器(Driver):任务的调度中心
当用户提交HQL语句后,Driver负责整个生命周期的管理,包括编译、优化和执行计划生成。
编译器
编译器将HQL语句转换为抽象语法树(AST),并进行语义检查,它会验证表是否存在、列名是否匹配,如果语法错误,会在此阶段直接报错,避免无效计算。
优化器
优化器是提升性能的核心,它会对执行计划进行多种优化,如谓词下推(Predicate Pushdown)、列裁剪(Column Pruning)和MapJoin优化,这些优化策略能显著减少数据传输量和计算资源消耗。
执行器
执行器将优化后的逻辑计划转化为物理执行计划,并提交给集群管理器(如YARN)运行。
底层执行引擎的演进与选择
Hive的强大之处在于其执行引擎的可插拔性,不同的引擎适用于不同的业务场景,选择合适的引擎是解决Hive性能瓶颈的关键。
MapReduce:经典但缓慢
MapReduce是Hive最初的执行引擎,它将HQL转换为MapReduce任务,利用HDFS的分布式存储特性进行计算。
虽然MapReduce具有极高的容错性和稳定性,但其磁盘I/O开销巨大,每次Map和Reduce阶段都需要将中间结果写入磁盘,导致在处理小规模数据或复杂关联查询时,响应时间长达数分钟甚至更久,MapReduce现多用于对实时性要求极低的大规模离线批处理场景。
Tez:中间件式的优化
Tez是一个通用的数据应用框架,它旨在克服MapReduce的局限性,Tez允许构建复杂的有向无环图(DAG)任务,而不是局限于Map-Reduce的两阶段模式。
通过减少中间数据的磁盘写入,Tez在处理多表关联、排序等复杂逻辑时,性能比MapReduce提升显著,Tez已成为许多大数据平台默认的Hive执行引擎,特别是在需要处理复杂ETL流程的场景中表现优异。
LLAP:实时交互的突破
LLAP(Live Long and Process)是Hive的一项重大创新,它引入了常驻内存的计算节点,实现了数据缓存和结果复用。
在LLAP架构下,数据被加载到内存中,后续的相同查询可以直接从内存中读取结果,无需重新执行MapReduce任务,这种机制使得Hive能够支持交互式查询,响应时间从分钟级降低到秒级甚至亚秒级,对于需要快速探索数据或构建实时报表的场景,LLAP是理想选择。

Hive与其他数据仓库技术的对比分析
在实际项目选型中,经常面临Hive与Spark SQL、Presto/Trino等技术的选择,理解它们的差异有助于做出更明智的决策。
| 特性维度 | Hive (MapReduce/Tez) | Spark SQL | Presto/Trino |
|---|---|---|---|
| 计算引擎 | 磁盘I/O密集,适合批处理 | 内存计算,速度极快 | 内存计算,低延迟 |
| 数据源支持 | 主要支持HDFS/Hive表 | 支持HDFS、Kafka、JDBC等 | 支持多种数据源,联邦查询能力强 |
| 查询延迟 | 高(分钟级) | 中(秒级至分钟级) | 低(亚秒级) |
| 适用场景 | 大规模离线ETL、历史数据归档 | 复杂ETL、机器学习特征工程 | 交互式BI查询、跨源联邦查询 |
行业共识认为,没有绝对完美的技术,只有最适合场景的方案,Hive在数据一致性、ACID事务支持(较新版本)以及与其他Hadoop生态组件的集成方面具有天然优势,而Spark SQL在迭代计算和机器学习方面更具优势,Presto则在多数据源联邦查询上表现突出。
Hive数据仓库架构实战优化策略
架构图解的最终目的是指导实践,以下是基于常见痛点的具体优化步骤。

分区与分桶策略
分区(Partition)是Hive性能优化的第一道防线,通过按日期、地区等字段对数据进行物理隔离,查询时可以跳过无关数据,查询“2026年10月”的数据,只需扫描对应的分区目录,而非全表。
分桶(Bucket)则进一步将数据划分为更小的片段,适用于采样查询和MapJoin优化,分桶数通常设置为2的幂次方,以便与Reduce任务数匹配。
小文件合并
在HDFS中,大量小文件会严重消耗NameNode的内存资源,并降低Map任务的效率,建议在HQL中设置参数:set hive.merge.smallfiles.avgsize=16000000;set hive.merge.mapfiles=true;set hive.merge.mapredfiles=true;
这些参数会在Map或MapReduce任务结束后,自动合并小文件,提升后续查询效率。
向量化执行
开启向量化执行(Vectorization)可以让Hive以列式方式批量处理数据,利用SIMD指令集加速计算,只需设置:set hive.vectorized.execution.enabled=true;set hive.vectorized.execution.reduce.enabled=true;
这一配置在大多数OLAP场景下都能带来显著的性能提升,且无需修改SQL语句。
Hive数据仓库架构常见问题解答
Hive数据仓库架构图解中Metastore数据库崩溃怎么办?
若使用外部MySQL作为Metastore,需确保MySQL服务正常运行并备份数据,若使用内嵌Derby,需迁移至外部数据库,恢复时,检查Hive配置文件中的连接字符串是否正确,并验证数据库权限。
为什么Hive查询速度比Spark SQL慢很多?
Hive默认使用MapReduce引擎,涉及大量磁盘I/O,而Spark SQL基于内存计算,若需提升Hive速度,可切换至Tez引擎,或开启LLAP服务,检查是否使用了合适的分区和索引,也是关键因素。
Hive数据仓库架构图解是否适用于实时数据流处理?
Hive本身设计用于离线批处理,不适合毫秒级实时处理,对于实时场景,建议结合Kafka进行数据接入,使用Flink或Spark Streaming进行实时计算,并将结果写入Hive或HBase供后续分析。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/hive%e6%95%b0%e6%8d%ae%e4%bb%93%e5%ba%93%e6%9e%b6%e6%9e%84%e5%9b%be%e8%a7%a3%e6%98%af%e4%bb%80%e4%b9%88%ef%bc%9fhive%e6%95%b0%e6%8d%ae%e4%bb%93%e5%ba%93%e6%9e%b6%e6%9e%84%e8%af%a6%e8%a7%a3/






评论列表(1条)
卧槽这架构图看着真头大!之前生产环境那Hive查询慢得我怀疑人生,死活想不通为啥加个索引还跑得跟蜗牛似的,大佬们这解耦到