llama.cpp通过其轻量级C++架构,让普通CPU也能高效运行大语言模型,核心在于利用量化技术降低显存依赖并优化指令集,实现本地化、低成本的AI推理。
曾经,运行大模型被视为拥有高端显卡用户的特权,借助llama.cpp这一开源工具,即便是集成显卡或老旧笔记本,也能流畅对话,这并非魔法,而是工程优化的胜利,它剥离了庞大的CUDA依赖,将模型压缩并适配到通用处理器上,对于开发者、学生或隐私敏感型用户,这不仅是技术选择,更是成本控制的务实方案。

llama.cpp怎么用CPU推理:核心原理与优势
理解“怎么用”之前,先明白“为什么能”,llama.cpp的底层逻辑是量化(Quantization),大模型原始参数通常是FP16或BF16格式,占用巨大内存,llama.cpp将其转换为INT4或INT8,体积缩小至原来的四分之一甚至更少,这种压缩不仅节省空间,还减少了内存带宽压力,让CPU在有限资源下跑得更快。
业内专家指出,这种量化策略在精度损失极小的前提下,大幅提升了推理速度,对于非实时性要求极高的应用,如文档摘要、代码辅助或创意写作,CPU推理的延迟完全在可接受范围内。
为什么选择CPU而非GPU?
很多人疑惑,既然有GPU,为何还要折腾CPU?场景决定工具。
- 硬件门槛低:无需购买昂贵的NVIDIA显卡,任何现代PC均可运行。
- 隐私安全性:数据完全本地处理,无需上传云端,避免泄露风险。
- 部署灵活性:可嵌入到各类软件中,无需依赖特定驱动环境。
- 成本效益:对于轻量级任务,CPU功耗远低于GPU,长期运行更省电。
CPU推理的性能瓶颈在哪里?
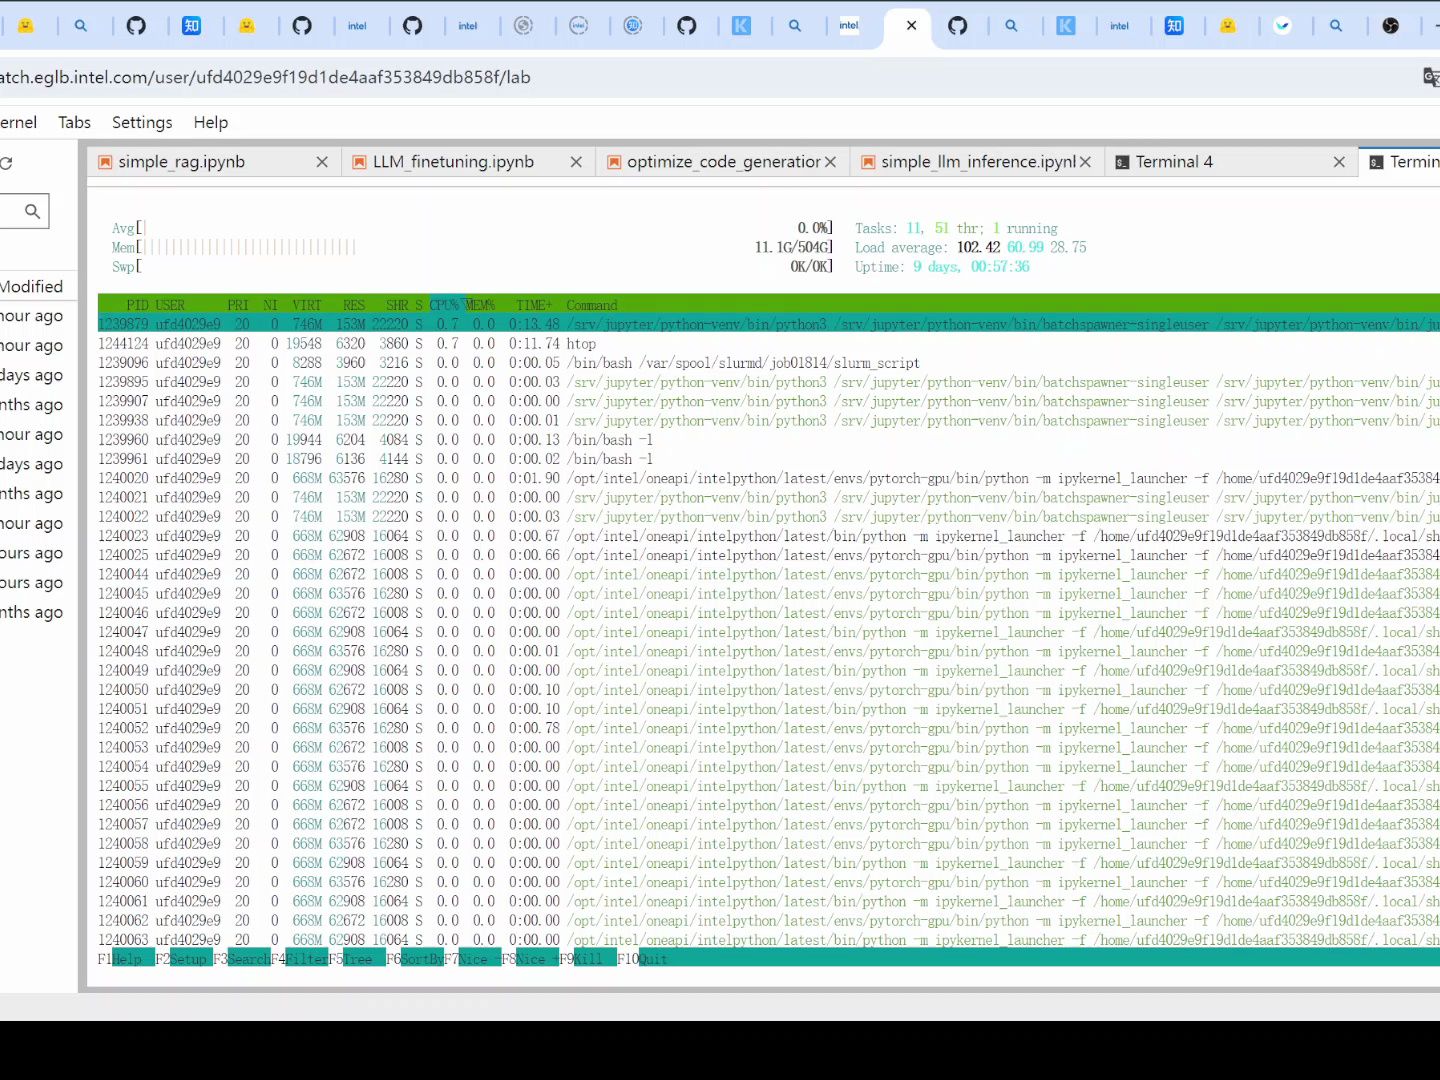
必须承认,CPU推理存在物理极限,主要瓶颈在于内存带宽和并行计算能力,GPU拥有数千个核心专门处理矩阵运算,而CPU核心数少,擅长逻辑控制,llama.cpp通过以下手段弥补差距:

- SIMD指令集优化:利用AVX2、AVX-512等指令集,单次处理更多数据。
- 内存层级优化:智能管理CPU缓存,减少数据搬运时间。
- 异步线程管理:将预处理、推理、后处理分流到不同线程,提升吞吐量。
llama.cpp怎么用CPU推理:实操步骤详解
理论讲完,进入实操环节,整个过程分为模型获取、环境准备、运行推理三个阶段,每一步都需精准操作,才能发挥最大效能。
第一步:获取量化模型文件
模型文件是推理的基础,推荐从Hugging Face或OpenRouter等平台下载GGUF格式的模型,GGUF是llama.cpp专用的量化格式,兼容性最好。
- 选择模型:初学者建议从Llama-3-8B或Qwen-7B开始,平衡效果与资源。
- 选择量化等级:Q4_K_M是性价比最高的选择,精度与速度兼顾,若内存充足,可选Q5_K_M;若内存紧张,Q3_K_S亦可尝试。
- 下载路径:直接下载.gguf文件,无需额外转换。
第二步:准备运行环境
llama.cpp支持Windows、macOS和Linux,macOS用户得益于统一内存架构,体验最佳,Windows用户需安装Visual C++ Redistributable。
- 下载二进制文件:访问GitHub官方仓库,下载对应系统的预编译版本,避免自行编译,除非你有特定需求。
- 解压文件:将下载的压缩包解压至任意目录,如D:llama.cpp。
- 放置模型:将下载的.gguf模型文件放入同一目录,方便调用。
第三步:执行推理命令
打开命令行工具(CMD、PowerShell或Terminal),进入llama.cpp目录,使用./main命令启动推理。
基础运行命令
./main -m model.gguf -n 512 -p "你好,请介绍一下你自己"

- -m:指定模型文件路径。
- -n:设置生成令牌的最大数量,512适合短对话。
- -p:提供提示词(Prompt),即你输入的问题。
高级参数优化
为了提升CPU推理效果,可添加以下参数:
- -t 8:设置线程数为8,根据CPU核心数调整,通常设为物理核心数,超线程核心数可酌情增加。
- -ngl 0:强制全部使用CPU推理,若需部分卸载到GPU,可调整此值。
- -c 2048:设置上下文窗口大小,默认2048,可根据内存调整至4096或更高。
- –temp 0.7:设置温度参数,控制生成内容的创造性,0.7适合大多数场景。
llama.cpp怎么用CPU推理:常见问题与优化技巧
在实际使用中,用户常遇到速度缓慢或内存溢出问题,以下技巧可显著改善体验。
如何提升CPU推理速度?
速度是CPU推理的最大痛点,以下方法可提速30%-50%:
- 使用更高量化等级:Q5_K_M比Q4_K_M稍慢,但精度更高;Q3_K_S更快,但可能丢失细节,根据任务需求权衡。
- 优化线程数:不要设置超过物理核心数,过多线程会导致上下文切换开销,反而降低速度。
- 关闭后台程序:推理时关闭浏览器、视频播放器等高内存占用应用,释放RAM带宽。
- 使用SSD存储:模型加载速度取决于磁盘I/O,SSD比HDD快数倍,显著减少等待时间。
如何解决内存不足错误?
当出现“Out of Memory”错误时,说明模型过大或上下文过长。
- 减小上下文窗口:将-c参数从2048降至1024或512。
- 更换更小模型:从7B模型切换至1.5B或3B模型,如TinyLlama。
- 降低量化等级:从Q4降至Q3或Q2,但需接受精度下降。
llama.cpp怎么用CPU推理:与GPU推理对比

| 维度 | CPU推理 | GPU推理 |
|---|---|---|
| 硬件要求 | 普通PC,无需独显 | 需NVIDIA/AMD独显,显存8GB+ |
| 推理速度 | 较慢,约5-15 tokens/s | 极快,可达50-100+ tokens/s |
| 内存占用 | 高,依赖系统RAM | 低,依赖显存VRAM |
| 适用场景 | 轻量任务、隐私保护、低成本部署 | 实时对话、复杂推理、高并发服务 |
| 能耗 | 低,适合笔记本 | 高,需良好散热 |
据工信部数据,近年来本地化AI部署需求增长显著,CPU推理因其低成本优势,成为中小企业和个人开发者的首选方案。
llama.cpp怎么用CPU推理:Q&A模块
llama.cpp怎么用CPU推理时出现乱码怎么办?
乱码通常由编码问题或模型损坏引起,首先检查模型文件是否完整下载,尝试重新下载,确保终端编码为UTF-8,Windows用户可在CMD中输入chcp 65001切换编码,若仍无效,尝试更换不同量化版本的模型文件。
llama.cpp怎么用CPU推理支持哪些操作系统?
llama.cpp支持主流操作系统,macOS用户体验最佳,因Metal框架优化良好,Windows用户需安装Visual C++运行库,建议使用预编译版本,Linux用户可通过apt或yum安装依赖,编译过程较为灵活,Android和iOS也支持,但需通过特定工具链编译。
llama.cpp怎么用CPU推理适合运行多大参数的模型?
这取决于系统内存,8GB内存可流畅运行1.5B-3B模型;16GB内存可运行7B模型;32GB及以上内存可尝试13B或更大模型,若内存不足,可通过量化降低模型体积,或减小上下文窗口,多数情况下,7B模型在16GB内存下表现最佳,平衡性能与资源。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/llama-cpp%e5%a6%82%e4%bd%95%e7%94%a8cpu%e6%8e%a8%e7%90%86%ef%bc%9fllama-cpp-cpu%e6%8e%a8%e7%90%86%e9%85%8d%e7%bd%ae%e6%95%99%e7%a8%8b/