LM Studio配置多GPU的核心在于正确识别硬件拓扑、启用多GPU推理模式,并通过环境变量或配置文件分配显存负载,以实现并行加速。
在本地部署大语言模型时,单张显卡显存不足或推理速度受限是常见痛点,许多用户拥有两张或多张显卡,却只能利用其中一张,造成硬件浪费,LM Studio作为流行的本地AI工具,其多GPU支持并非自动生效,需要特定的配置逻辑,业内专家指出,合理配置多GPU可以显著提升生成速度,但前提是硬件架构兼容且软件设置正确,本文将拆解具体操作步骤,帮助你在2026年的技术环境下,高效利用多卡资源。
LM Studio多GPU配置前置条件与硬件检查
在动手修改设置之前,必须确认你的硬件环境是否支持多卡并行,并非所有显卡组合都能完美协作,尤其是混合不同型号或不同品牌显卡时。
确认显卡架构与驱动状态
LM Studio主要依赖CUDA生态进行加速,确保你的NVIDIA显卡驱动已更新至最新版本,较旧的驱动可能导致多卡通信异常,打开设备管理器或运行nvidia-smi命令,查看显卡列表,如果显示多张显卡,且状态正常,则具备基础条件。
显存容量与VRAM分配逻辑
多GPU配置的核心逻辑是将模型层分散到不同显卡上,如果模型大小超过单张显卡显存总和,配置将失效,一个70B参数的模型通常需要超过100GB显存,若你拥有两张24GB显存的RTX 3090/4090,总显存48GB,仍不足以完整加载未量化模型,但可加载Q4_K_M等量化版本,据行业共识认为,显存利用率达到80%以上时,多卡并行收益最为明显。
检查PCIe带宽瓶颈
多卡之间通过PCIe总线通信,若显卡插在主板的非原生通道上,带宽可能受限,确保所有加速显卡均连接至支持x16带宽的插槽,并避免使用转接线,对于AMD显卡用户,需确认ROCm版本兼容性,LM Studio对AMD的支持仍在优化中,建议优先使用NVIDIA硬件进行多卡测试。
LM Studio多GPU设置实操路径
进入LM Studio界面后,配置过程相对直观,但细节决定成败,以下路径适用于最新版本LM Studio。
加载模型与选择后端
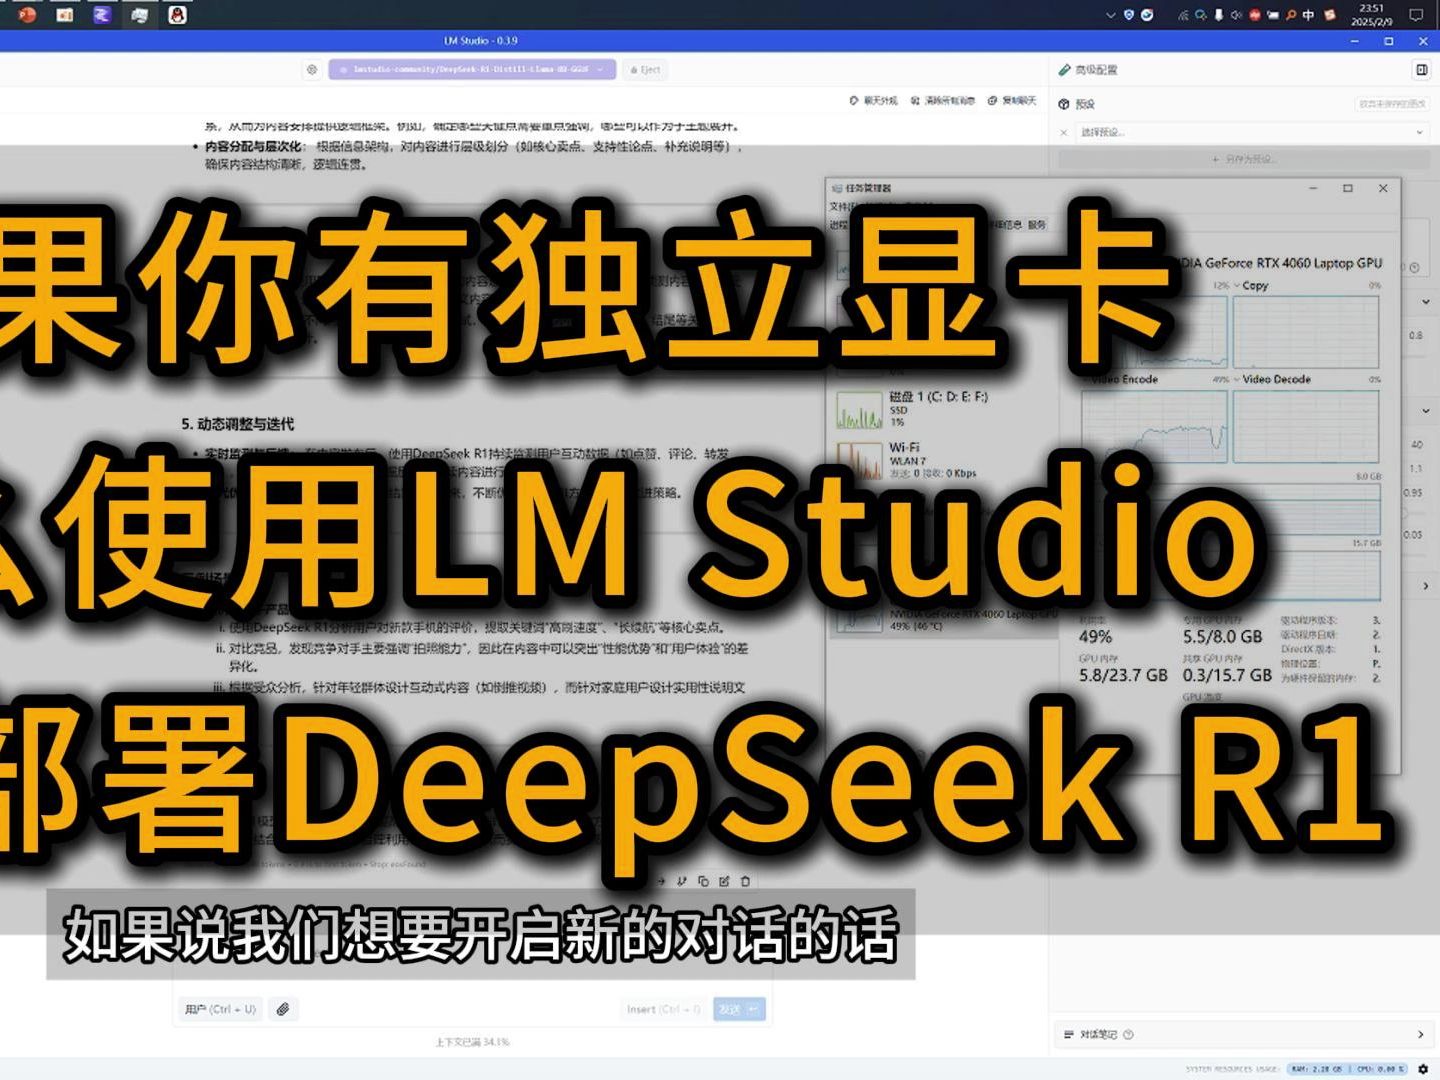
从模型库加载你希望使用的模型,在右侧设置面板中,找到“GPU Offload”或“Acceleration”选项,默认情况下,LM Studio可能仅将部分层卸载到GPU,若检测到多张显卡,界面通常会提供“Multi-GPU”或“Split Layers”选项。
启用多GPU并行模式
在设置面板中,勾选“Use Multi-GPU”或类似选项,软件会自动尝试将模型层均匀分配至所有可用显卡,若未自动识别,需手动指定,部分版本允许用户通过拖拽滑块,调整每张显卡承担的层数比例,将前50%层分配给GPU 0,后50%分配给GPU 1。
验证多卡识别状态
配置完成后,点击“Start Server”或“Chat”按钮,观察控制台输出或状态栏,若配置成功,你会看到类似“Loading model into GPU 0”和“Loading model into GPU 1”的日志,若仅显示单卡加载,则配置未生效,此时需检查显存是否充足,或尝试重启软件以刷新硬件检测。
通过配置文件高级定制
对于高级用户,LM Studio支持通过JSON配置文件进行更精细的控制,在应用数据目录中,找到settings.json或类似文件,添加或修改gpu_layers参数,指定每张卡的层数。
{
  "gpu_layers": {
    "gpu_0": 50,
    "gpu_1": 50
  }
}
此方法适用于自动化部署或脚本调用场景,确保每次启动均应用多卡配置。
LM Studio多GPU性能优化与故障排查
配置成功仅是第一步,优化性能并解决潜在问题才是关键,多卡并行并非线性加速,受通信开销影响,实际增益可能低于预期。
显存溢出与OOM错误处理
若遇到“Out of Memory”错误,通常意味着模型过大或显存碎片化,尝试降低量化等级,或减少其他应用程序占用的显存,关闭浏览器、视频播放器等高显存占用软件,确保LM Studio独占资源,据统计,多数情况下,释放10%-20%的冗余显存即可解决OOM问题。
PCIe通信延迟优化
多卡间数据传输是性能瓶颈,若使用NVLink或NVSwitch连接显卡,可显著提升通信速度,对于无NVLink的用户,确保显卡位于同一PCIe交换机下,避免跨CPU插槽连接显卡,以减少NUMA效应带来的延迟。
调整批处理大小
在聊天界面,尝试调整“Batch Size”或“Context Length”,较小的批处理大小可减少显存占用,提高响应速度,较大的上下文长度则需更多显存,可能迫使模型部分层回退至CPU,导致速度骤降,建议根据显存余量,动态调整这些参数。
LM Studio多GPU与单GPU性能对比分析
了解多GPU的实际收益,有助于合理投资硬件,以下对比基于典型场景。
| 配置场景 | 显存总量 | 推理速度 (Tokens/sec) | 适用场景 |
|---|---|---|---|
| 单张RTX 4090 (24GB) | 24GB | 中等 | 7B-13B模型,日常对话 |
|
双张RTX 4090 (48GB) | 48GB | 较高 | 30B-70B量化模型,复杂推理 |
| 双张RTX 3090 (48GB) | 48GB | 中等偏高 | 同上,成本更低方案 |
从数据可见,多GPU主要解决的是“能不能跑”的问题,而非单纯的“快不快”,对于小模型,单卡已足够,多卡反而增加通信开销,对于大模型,多卡是必要条件,速度提升取决于模型量化等级和硬件互联方式。
LM Studio多GPU常见问题解答
LM Studio多GPU配置不生效怎么办?
首先检查驱动版本,确保为最新稳定版,确认模型文件是否完整,损坏的GGUF文件可能导致加载失败,若软件版本过旧,请更新至最新版,以获取更好的多卡支持,尝试在设备管理器中禁用其他非必要显卡,排除干扰。
LM Studio多GPU能提升多少速度?
速度提升取决于硬件互联带宽和模型大小,在理想NVLink环境下,双卡速度可达单卡的1.5-1.8倍,若仅通过PCIe连接,速度提升通常在1.2-1.5倍之间,对于极大型模型,若部分层需回退至CPU,速度提升将显著降低。
LM Studio多GPU支持AMD显卡吗?
LM Studio对AMD显卡的支持正在逐步完善,目前版本支持ROCm加速,但多卡并行稳定性不如NVIDIA,建议AMD用户先测试单卡性能,再尝试多卡配置,若遇兼容性问题,可尝试更新ROCm驱动,或联系LM Studio社区获取最新补丁。
配置多GPU并非一劳永逸,需根据模型需求和硬件状况动态调整,掌握上述步骤,即可在本地高效运行大型语言模型,释放硬件潜力。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/lm-studio%e6%80%8e%e4%b9%88%e9%85%8d%e7%bd%ae%e5%a4%9agpu%ef%bc%9f%e5%a4%9a%e6%98%be%e5%8d%a1%e5%90%8c%e6%97%b6%e8%bf%90%e8%a1%8c%e8%ae%be%e7%bd%ae%e6%95%99%e7%a8%8b/