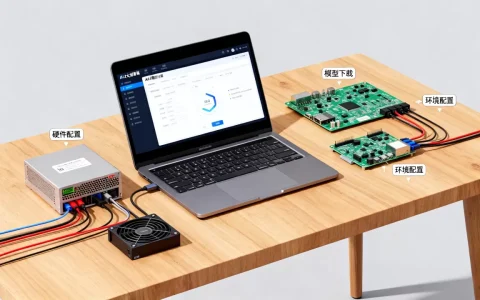
Ollama负责本地模型推理,AnythingLLM提供对话与管理界面,两者通过API接口无缝对接,即可在离线环境下构建安全、私有的企业级知识库系统。
将本地大模型与智能知识库结合,是许多技术团队和个人开发者在2026年应对数据隐私焦虑的首选方案,这种组合不仅避免了云端API的高昂费用,更实现了数据的完全本地化存储,Ollama作为轻量级的模型运行引擎,降低了硬件门槛;而AnythingLLM则像一个智能管家,负责文档解析、向量检索和对话管理,理解它们如何配合,是搭建私有AI助手的关键一步。

Ollama与AnythingLLM的协同工作原理
要理解两者的配合,首先要明确各自的角色分工,Ollama不是一个聊天界面,它是一个后台服务,专门负责加载和运行LLM(大型语言模型),AnythingLLM则是一个全栈应用,它包含前端界面、后端逻辑以及向量数据库。
架构层面的互补关系
在技术架构上,AnythingLLM并不直接运行模型,而是通过REST API与Ollama通信,这种解耦设计带来了极大的灵活性。
- 模型层:Ollama管理模型的生命周期,包括下载、量化、卸载和版本切换,它支持Llama 3、Qwen、Mistral等主流开源模型。
- 应用层:AnythingLLM处理用户输入,将问题转化为向量,在本地向量数据库中检索相关文档片段,然后将“问题+文档片段+系统提示词”发送给Ollama生成的模型进行回答。
这种分工使得你可以随时更换底层的推理引擎,而无需修改AnythingLLM的配置逻辑,对于寻求Ollama和AnythingLLM搭配教程掌握这一层API调用机制是基础。
数据流转的具体路径
当你在AnythingLLM中输入一个问题时,数据经历了以下过程:
- 预处理:AnythingLLM接收文本,清洗噪音。
- 向量化:利用内置的Embedding模型将文本转化为高维向量。
- 检索:在本地向量库(如Chroma或LanceDB)中查找最相似的文档片段。
- 组装提示词:将检索到的上下文与用户问题组合,形成最终的Prompt。
- 推理请求:通过HTTP请求将Prompt发送至Ollama的API端点(默认localhost:11434)。
- 流式返回:Ollama逐字生成回答,AnythingLLM实时渲染到前端界面。

本地部署与API对接实操步骤
实现两者的配合并非难事,核心在于确保Ollama的服务端口对AnythingLLM可见,并正确配置模型参数,以下是经过验证的标准操作流程。
第一步:安装与启动Ollama服务
你需要在本地机器上安装Ollama,支持Windows、macOS和Linux,安装完成后,打开终端或命令行,拉取一个适合你硬件的模型,对于大多数现代电脑,Llama 3.1 8B是一个平衡性能与速度的选择。
运行以下命令:
ollama pull llama3.1
启动Ollama服务通常会自动进行,但请确保它正在监听0.0.1:11434端口,你可以访问http://localhost:11434来验证服务是否在线,如果是在局域网内其他设备访问,需确保防火墙允许该端口通信。
第二步:配置AnythingLLM连接
下载并启动AnythingLLM Desktop版或Docker版本,进入设置界面,找到“Workspace Settings”(工作区设置)或“Model Provider”(模型提供商)选项。
在模型提供商选择中,找到“Ollama”选项,系统会自动检测本地的Ollama实例,如果未自动检测,手动输入API地址http://localhost:11434。
关键步骤在于选择模型,下拉菜单会列出Ollama当前加载的所有模型,选择你刚才拉取的llama3.1,注意,某些高级功能可能需要特定的模型结构支持,建议优先选择Llama系列或Qwen系列,它们在中文理解和代码生成方面表现优异。
第三步:向量数据库与文档导入
配置好模型后,创建一个新的工作区(Workspace),在“Documents”(文档)标签页,上传你的PDF、TXT或Markdown文件,AnythingLLM会自动分割文档并生成向量嵌入。

这一步决定了知识库的质量,建议上传结构清晰、文本密集的文档,对于复杂的表格或图片,可能需要额外的OCR预处理,否则检索效果会大打折扣,业内专家指出,文档预处理的质量直接决定了RAG(检索增强生成)系统的最终准确率。
性能优化与常见问题排查
在实际使用中,用户常遇到响应慢、幻觉多或连接失败的问题,这些通常与硬件资源分配和配置细节有关。
硬件资源分配策略
Ollama默认会根据显存或内存自动分配层数,如果模型加载失败或速度极慢,可能需要手动调整。
- GPU加速:确保安装了正确的NVIDIA驱动,并在Ollama环境变量中设置
OLLAMA_NUM_GPU=-1以启用全量GPU加速。 - 内存限制:对于大内存模型(如70B),确保系统有充足的RAM,如果显存不足,Ollama会自动将部分层卸载到CPU,导致速度下降。
连接失败的解决方案
如果AnythingLLM提示“无法连接Ollama”,请按以下顺序检查:
- 端口冲突:确认11434端口未被其他程序占用。
- 跨域问题:如果使用Docker部署AnythingLLM,Ollama需暴露在宿主机网络,而非仅localhost。
- 模型未加载:在Ollama终端运行
ollama list,确认模型已存在。
对于寻找Ollama本地部署避坑指南的用户,特别注意Docker网络模式的选择,bridge模式可能导致容器间无法通过localhost通信,需改用host模式或配置正确的网络别名。
应用场景与成本效益分析
这种组合方案并非适合所有用户,它在特定场景下具有不可替代的优势。
隐私敏感型场景
金融、医疗和法律行业对数据出境极其敏感,使用Ollama+AnythingLLM,所有数据均在本地服务器或终端处理,无需上传至任何第三方云服务,这符合GDPR等数据合规要求,是企业构建内部知识中台的合规基石。
离线环境作业

在网络安全隔离区或网络不稳定的偏远地区,云端AI服务不可用,本地部署方案提供了完整的离线AI能力,确保业务连续性。
成本对比
| 方案 | 初期投入 | 长期成本 | 数据安全性 | 灵活性 |
|---|---|---|---|---|
| 云端API (如OpenAI) | 低 | 高 (按Token计费) | 低 (数据上传) | 高 |
| Ollama+AnythingLLM | 中 (硬件成本) | 极低 (电费+硬件折旧) | 高 (完全本地) | 中 (受限于硬件) |
多数情况下,对于日均对话量超过1000次的团队,本地部署的TCO(总拥有成本)在一年内即可低于云端API费用。
Ollama和AnythingLLM配合常见问题解答
Ollama和AnythingLLM配合需要多大的显存?
显存需求取决于选择的模型参数量,对于8B参数模型,建议至少4GB显存;对于70B参数模型,建议至少24GB显存或使用多卡聚合,如果显存不足,模型将回退到CPU推理,速度显著降低但功能可用。
AnythingLLM支持哪些类型的文档格式?
AnythingLLM原生支持PDF、TXT、MD、DOCX、CSV和JSON,对于PPT和Excel,建议先转换为PDF或TXT格式以确保解析准确性,复杂的扫描件图片需要依赖OCR引擎,目前内置引擎对中文识别率良好,但复杂排版仍可能丢失结构信息。
如何更新Ollama中的模型版本?
在Ollama终端运行ollama pull <model_name>即可拉取最新版本,AnythingLLM无需重启,只需在设置中刷新模型列表,选择新版本即可生效,建议定期更新模型以获取最新的安全补丁和性能优化。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/ollama%e6%80%8e%e4%b9%88%e5%92%8canythingllm%e9%85%8d%e5%90%88%ef%bc%9follama%e4%b8%8eanythingllm%e9%9b%86%e6%88%90%e6%95%99%e7%a8%8b/