Python反垃圾邮件方案的核心在于结合正则表达式过滤、机器学习分类模型以及发件人信誉验证,构建多层防御体系,而非依赖单一规则。
在数字化营销日益泛滥的今天,企业邮箱和即时通讯工具面临着前所未有的垃圾信息冲击,传统的基于关键词匹配或黑白名单的静态过滤手段,已经难以应对日益智能化的垃圾邮件攻击,越来越多的技术团队开始转向使用Python构建动态、智能的反垃圾系统,这不仅是技术升级的需求,更是保障业务连续性和用户隐私的必然选择。
Python反垃圾邮件技术架构解析
构建一个高效的反垃圾系统,需要理解其背后的技术逻辑,业内专家指出,现代反垃圾技术已经从简单的规则匹配演变为基于概率统计和机器学习的综合判断,Python凭借其丰富的生态库,成为实现这一架构的首选语言。
数据预处理与特征工程
垃圾邮件检测的第一步是数据清洗,原始邮件数据通常包含HTML标签、特殊字符以及乱码,这些噪声会严重影响模型效果。
文本清洗流程
- 去除HTML标签:使用
BeautifulSoup或re模块提取纯文本内容。 - 分词处理:利用
jieba(中文)或nltk(英文)进行分词,去除停用词。 - 向量化表示:将文本转换为计算机可理解的数字向量,常用方法包括TF-IDF和Word2Vec。
常用算法模型对比
不同场景下,算法的选择至关重要,以下是几种主流算法的对比:
| 算法类型 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 朴素贝叶斯 | 训练速度快,对小数据集效果好 | 假设特征独立,实际中往往不成立 | 基础垃圾邮件过滤 |
| SVM支持向量机 | 在高维空间表现优异,泛化能力强 | 大数据集训练慢,调参复杂 | 中等规模数据集 |
| 随机森林 | 抗过拟合能力强,可解释性较好 | 模型体积较大,预测速度稍慢 | 需要高准确率的场景 |
| LSTM深度学习 | 能捕捉上下文语义,效果最佳 | 需要大量数据和算力,黑盒模型 | 大规模企业级应用 |

实战:构建基于机器学习的反垃圾系统
理论之外,实操才是检验真理的标准,以下是一个基于Python和Scikit-learn构建简易垃圾邮件分类器的具体步骤,这套流程适用于大多数中小型企业的内部邮件过滤需求。
环境准备与数据加载
确保安装了必要的库:pandas, scikit-learn, nltk,假设你已准备好标记好的邮件数据集,包含ham(正常邮件)和spam(垃圾邮件)两类。
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.naive_bayes import MultinomialNB
from sklearn.metrics import classification_report
# 加载数据
df = pd.read_csv('emails.csv')
X = df['text']
y = df['label']
# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
模型训练与评估
使用TF-IDF将文本转换为特征向量,并训练朴素贝叶斯分类器,朴素贝叶斯在文本分类任务中表现稳定,且计算成本低,适合实时性要求较高的场景。
# 特征提取
vectorizer = TfidfVectorizer(stop_words='english')
X_train_vec = vectorizer.fit_transform(X_train)
X_test_vec = vectorizer.transform(X_test)
# 训练模型
model = MultinomialNB()
model.fit(X_train_vec, y_train)
# 预测与评估
y_pred = model.predict(X_test_vec)
print(classification_report(y_test, y_pred))

模型优化策略
如果基础模型准确率不足,可以考虑以下优化手段:
- 特征选择:移除低频或高频无意义词汇,减少噪声。
- 集成学习:结合SVM和随机森林的结果,通过投票机制提高鲁棒性。
- 阈值调整:根据业务容忍度调整分类阈值,平衡误报率和漏报率。
Python反垃圾邮件部署与运维挑战
模型训练完成只是第一步,如何在生产环境中稳定运行才是关键,许多企业在python反垃圾邮件部署过程中遇到了性能瓶颈和误报问题。
实时过滤性能优化
对于高并发场景,单次邮件的处理时间必须控制在毫秒级。
- 异步处理:使用
asyncio或Celery队列异步处理邮件,避免阻塞主线程。 - 缓存机制:对常见垃圾邮件特征进行缓存,减少重复计算。
- 模型轻量化:使用
ONNX格式导出模型,加速推理过程。
误报与漏报的平衡
误报(正常邮件被拦截)比漏报(垃圾邮件进入收件箱)后果更严重,运维中需要建立反馈机制。
- 用户反馈闭环:允许用户标记“误报”或“漏报”,数据回流至训练集。
- 定期重训练:每周或每月使用新数据重新训练模型,适应垃圾邮件的新变种。
- 人工审核队列:对置信度在阈值附近的邮件,送入人工审核队列,由专人处理。
常见问题与解决方案
python反垃圾邮件系统如何防止绕过?

垃圾邮件发送者常使用图片嵌入、变体拼写或加密内容来绕过基于文本的检测,应对策略包括:
- OCR识别:对邮件中的图片进行光学字符识别,提取潜在垃圾信息。
- 语义分析:引入深度学习模型,理解邮件的整体语义而非仅依赖关键词。
- 行为分析:监控发件人的发送频率、时间段和收件人分布,识别异常行为模式。
python反垃圾邮件成本如何控制?
对于中小企业,高昂的云服务成本可能难以承受。
- 本地部署:利用现有服务器资源,部署轻量级模型,降低API调用费用。
- 开源工具集成:结合
SpamAssassin等开源规则引擎,减少自定义开发工作量。 - 混合架构:简单规则过滤前置,复杂模型后置,降低整体计算负载。
python反垃圾邮件与现有邮件系统如何集成?
集成过程需确保无缝衔接,不影响用户体验。
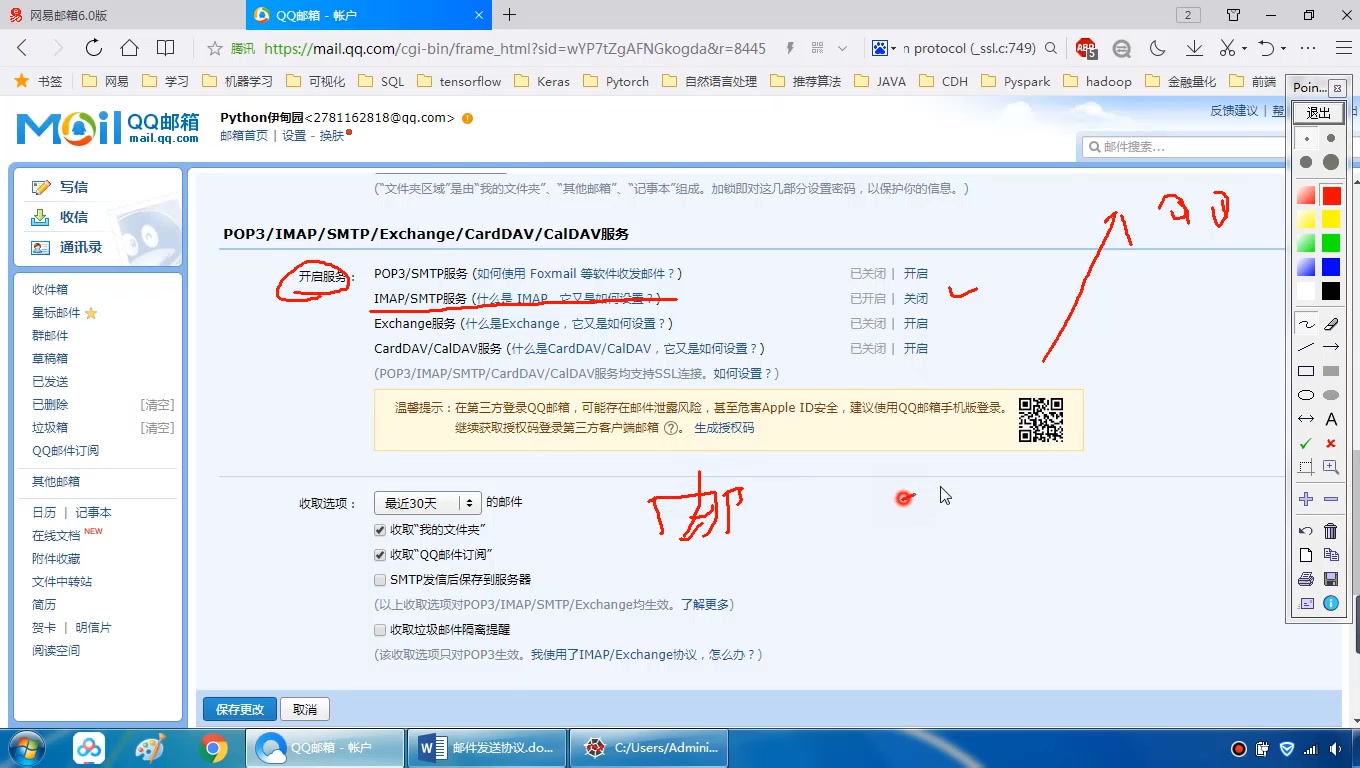
- SMTP拦截:在邮件服务器入口部署Python脚本,通过SMTP协议拦截可疑邮件。
- API接口:通过RESTful API与现有CRM或邮件客户端对接,实现实时查询。
- 插件开发:为Outlook或Thunderbird等客户端开发插件,实现客户端侧过滤。
未来趋势:AI驱动的智能防御
随着大语言模型(LLM)的兴起,反垃圾技术正迎来新的变革,LLM能够理解更复杂的语境和隐含意图,从而更精准地识别伪装成正常邮件的钓鱼攻击,这也带来了新的风险,如模型幻觉和对抗性攻击。
行业共识认为,未来的反垃圾系统将不再是单一的过滤器,而是一个集内容分析、行为监控、信誉评估于一体的智能生态系统,Python作为连接各组件的胶水语言,将继续在这一领域发挥核心作用,企业应尽早布局,构建适应未来威胁环境的防御体系,而非仅满足于当前的基础过滤需求。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/python-antispam%e6%98%af%e4%bb%80%e4%b9%88%ef%bc%9fpython%e5%8f%8d%e5%9e%83%e5%9c%be%e9%82%ae%e4%bb%b6%e5%ba%93%e6%80%8e%e4%b9%88%e7%94%a8/