vLLM部署报错时,最核心的排查逻辑是遵循“环境依赖-显存资源-模型配置-网络通信”的递进顺序,优先通过日志定位OOM或版本冲突,再针对性调整参数或升级驱动。
在实际的大模型落地场景中,vLLM因其高吞吐和连续批处理特性成为首选,但这也意味着它对底层环境极其敏感,很多开发者在初次部署时,常遇到服务启动失败、推理延迟极高或结果乱码等问题,这些问题往往不是单一原因导致,而是软硬件协同工作的结果,我们需要像侦探一样,通过日志线索还原现场,逐一排除干扰项。
排查环境依赖与版本兼容性
环境配置错误是导致vLLM无法启动的首要原因,vLLM对CUDA版本、PyTorch版本以及cuDNN版本有严格的对应关系,如果版本不匹配,Python解释器可能直接抛出ImportError,或者在初始化引擎时静默崩溃。
检查CUDA与PyTorch版本匹配
业内专家指出,绝大多数启动失败源于版本不对齐,vLLM通常要求PyTorch版本与CUDA Toolkit版本严格一致,如果你使用的是CUDA 11.8,那么PyTorch必须安装对应11.8编译的版本,而不是最新的CUDA 12.x版本。
操作路径如下:
- 在终端输入
nvcc -V查看服务器CUDA版本。 - 输入
python -c "import torch; print(torch.version.cuda)"查看PyTorch使用的CUDA版本。 - 两者必须完全一致,如果不一致,需使用conda或pip重新安装匹配版本的PyTorch。
解决依赖包冲突
vLLM依赖大量底层库,如ray、transformers、sentencepiece等,当环境中存在多个不同版本的库时,极易发生冲突,建议始终在干净的虚拟环境中安装vLLM。
对于vllm安装报错,推荐使用以下命令构建隔离环境:
conda create -n vllm_env python=3.10
conda activate vllm_env
pip install vllm
若遇到ImportError: DLL load failed,通常是因为Windows环境下缺少Visual C++ Redistributable,或Linux环境下缺少libstdc++库,此时需检查系统底层库是否完整,而非仅仅关注Python包。
诊断显存溢出与资源分配问题
显存不足(OOM)是vLLM运行时最常见的错误,vLLM采用PagedAttention技术管理显存,但如果配置不当,仍会触发OOM。
识别OOM错误类型
当看到RuntimeError: CUDA out of memory时,不要盲目增加显存,而应先分析是预填充阶段(Prefill)还是解码阶段(Decode)溢出。
- Prefill OOM:通常由输入序列过长引起,vLLM在接收长文本时,需要分配大量显存进行注意力计算。
- Decode OOM:通常由并发请求过多或最大序列长度设置过大引起。
调整关键参数优化显存
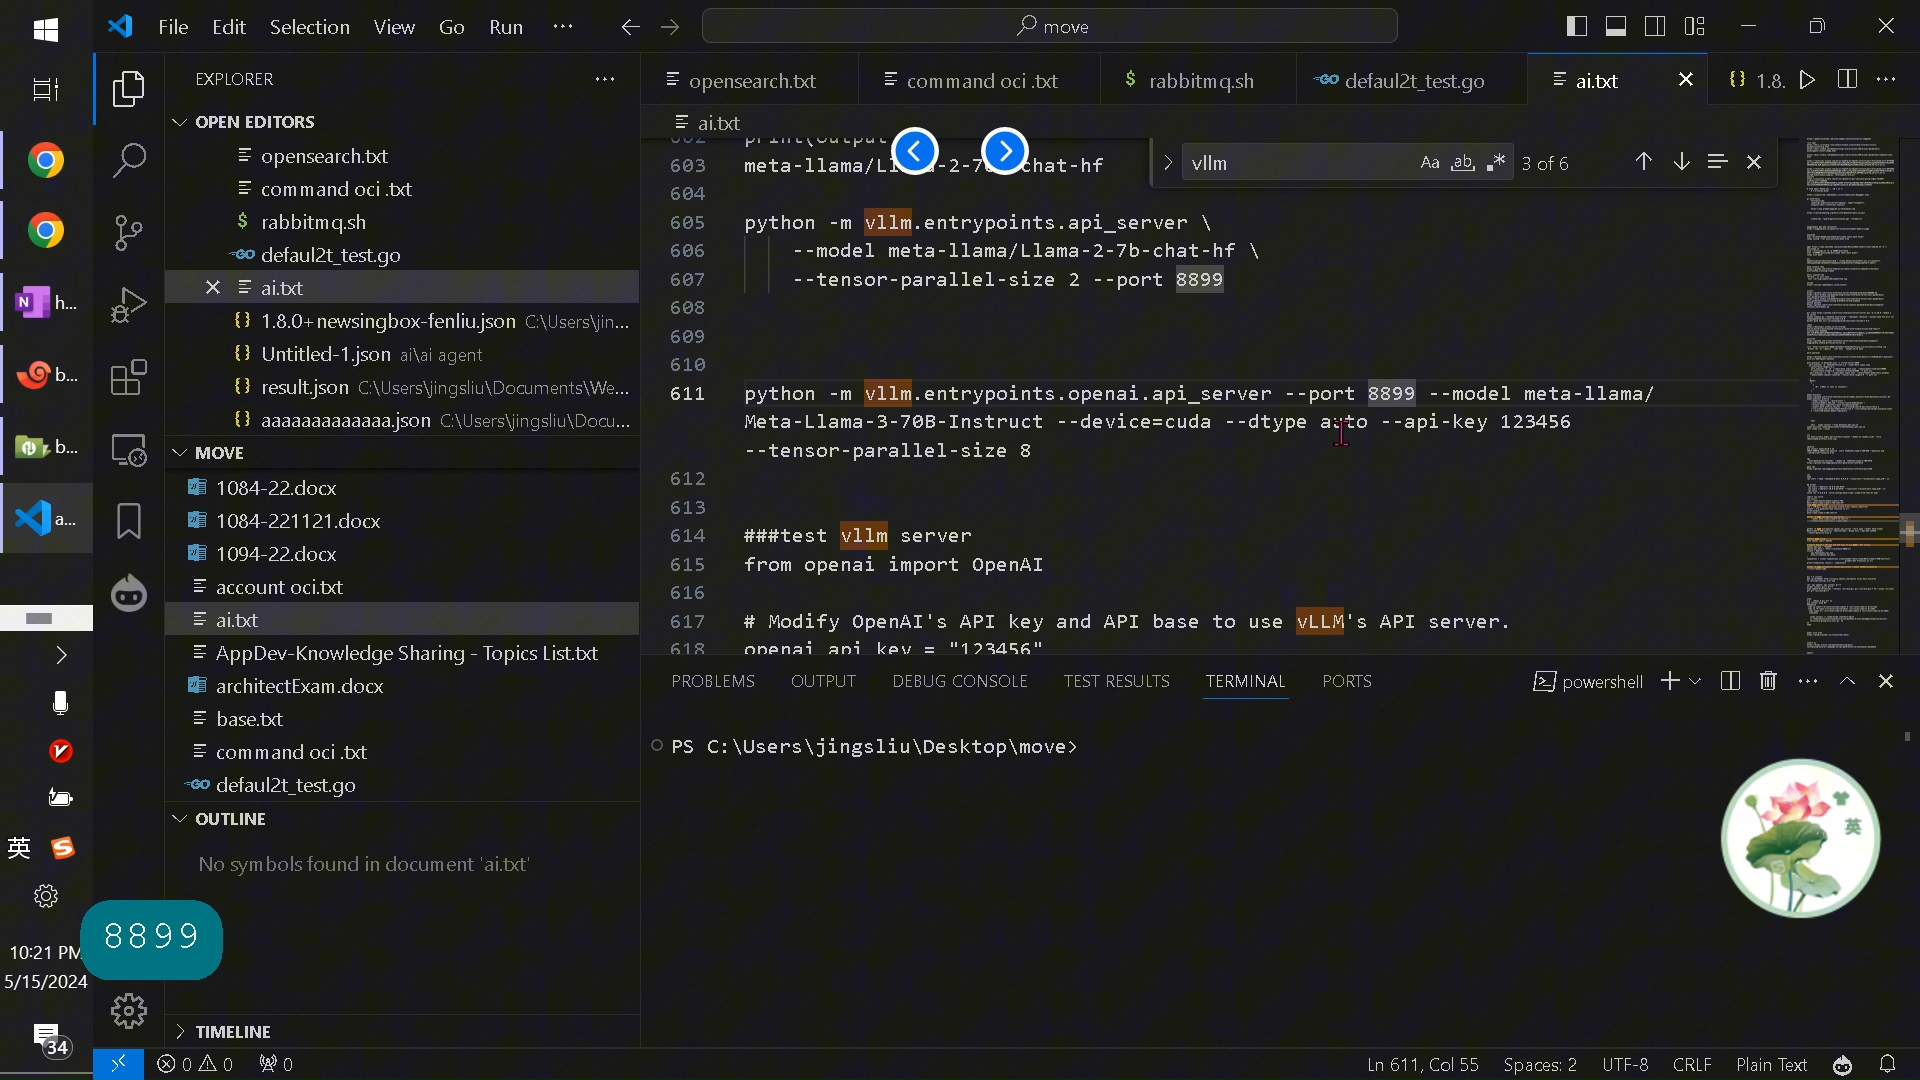
通过调整启动参数,可以有效缓解显存压力,以下是几个关键参数的作用及建议值:
| 参数名称 | 作用描述 | 建议调整策略 |
|---|---|---|
--max-model-len |
模型最大上下文长度 | 若报错,尝试减小此值,如从8192降至4096 |
--gpu-memory-utilization |
GPU显存使用上限 | 默认0.9,若OOM可降至0.85或0.8 |
--max-num-batched-tokens |
每批最大token数 | 限制并发批次,防止瞬时显存峰值过高 |
--swap-space | CPU交换空间大小 | 增加此值可利用部分CPU内存缓解显存压力 |
对于多卡部署场景,若出现部分GPU显存不均,可尝试设置--tensor-parallel-size为实际GPU数量,并确保所有GPU状态一致。
排查模型加载与配置错误
模型文件损坏或配置错误会导致推理结果异常或启动失败,vLLM支持多种模型格式,但HuggingFace格式最为通用。
验证模型文件完整性
在加载模型前,务必检查模型文件夹中是否包含config.json、model.safetensors(或pytorch_model.bin)等核心文件,若文件缺失或损坏,vLLM将无法初始化。
对于本地部署大模型报错的情况,建议先使用HuggingFace官方库加载模型,确认模型本身无问题后,再切换至vLLM,若HuggingFace加载正常而vLLM失败,则问题出在vLLM的配置或后端兼容性上。
检查模型架构支持
并非所有Transformer架构都得到vLLM的完整支持,对于较新的模型架构(如某些MoE模型或自定义架构),vLLM可能需要更新版本才能支持。
若遇到Unsupported model architecture错误,请执行以下操作:
- 检查vLLM版本是否为最新:
pip install --upgrade vllm。 - 查阅vLLM官方文档,确认该模型架构是否在支持列表中。
- 若不支持,考虑使用
--model参数指定兼容的架构,或等待官方更新。
优化网络通信与分布式部署
在分布式环境中,vLLM依赖NCCL进行GPU间通信,网络配置错误会导致同步失败或性能急剧下降。
解决NCCL初始化失败
若启动时出现NCCL error,通常与网络接口选择或防火墙设置有关。
操作建议:
- 确保所有节点间网络延迟低且带宽充足。
- 设置环境变量
NCCL_DEBUG=INFO以查看详细日志。 - 若使用多网卡服务器,指定正确的网络接口:
export NCCL_SOCKET_IFNAME=eth0(替换为实际网卡名)。
调整分布式并行策略
对于超大模型,需使用张量并行(Tensor Parallelism)或流水线并行(Pipeline Parallelism),若配置不当,会导致负载不均或通信瓶颈。
对于多卡部署vllm性能优化,建议根据模型大小和GPU数量调整--tensor-parallel-size,该值应等于GPU数量,若模型较小,可尝试减少并行度以降低通信开销。
常见问题快速问答
vllm部署报错怎么排查显存不足问题?
首先检查--gpu-memory-utilization参数,默认0.9可能过高,可尝试降至0.85,减小--max-model-len和--max-num-batched-tokens,若仍无效,检查是否有其他进程占用显存,使用nvidia-smi命令清理无关进程。
vllm安装报错如何解决依赖冲突?
使用conda创建全新虚拟环境,避免系统库干扰,确保CUDA版本与PyTorch版本严格匹配,若使用pip安装,指定CUDA版本对应的wheel包,如pip install vllm --no-cache-dir。
vllm推理速度慢是什么原因?
推理速度慢通常由输入序列过长、并发请求过多或并行策略不当引起,检查--max-num-batched-tokens是否过小,导致批处理效率低,调整--tensor-parallel-size以匹配GPU数量,确保GPU处于高性能模式,而非节能模式。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/400796.html