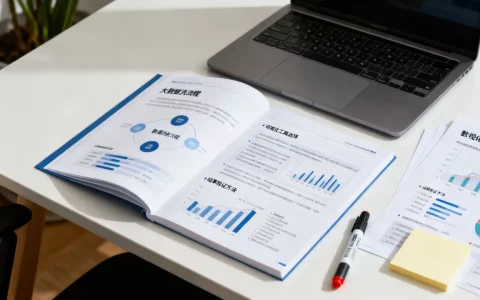
VSM(向量空间模型)在Python中通过scikit-learn等库实现,核心是将文本转化为数值向量以计算相似度,是构建搜索引擎和推荐系统的基石。
什么是VSM及其在Python中的核心逻辑
向量空间模型(Vector Space Model, VSM)听起来高大上,其实本质很简单,想象一下,你把每一篇文章都看作宇宙中的一个点,这个点的位置由它包含的关键词决定,如果两篇文章讨论的都是“人工智能”和“深度学习”,它们在空间里的距离就会很近;如果一篇讲“人工智能”,另一篇讲“烹饪技巧”,它们之间的距离就会很远。

在Python生态中,我们不需要手动去计算这些复杂的几何距离,现有的工具库已经帮我们封装好了,业内专家指出,TF-IDF(词频-逆文档频率)算法是目前最经典且高效的VSM实现方式之一,它不仅能统计一个词在单篇文档中出现的频率,还能衡量这个词在整个语料库中的稀缺程度,那些出现频繁但普遍存在的词(如“的”、“是”),权重会被降低;而那些出现频率高且独特的词,权重会被提升。
Python实现VSM的三大主流方案对比
在实际开发中,选择哪种工具取决于你的数据规模和性能需求,目前Python社区中主要有三种选择:scikit-learn、Gensim和Hugging Face Transformers。
scikit-learn(适合中小规模文本分析)
这是最入门也最稳健的选择,对于初学者或者处理几万条以内文档的场景,scikit-learn的TfidfVectorizer是首选,它的API设计非常直观,几行代码就能完成从原始文本到矩阵的转换。
- 优点:文档齐全,社区支持好,集成度高,容易与其他机器学习模型(如SVM、KNN)结合。
- 缺点:内存占用较高,当语料库达到百万级时,稀疏矩阵会变得非常庞大,导致处理速度变慢。
- 适用场景:垃圾邮件过滤、短文本分类、小规模知识库检索。
Gensim(适合大规模语料库)
如果你需要处理百万甚至千万级的文档,Gensim是更好的选择,它采用了流式处理机制,不需要一次性将所有数据加载到内存中。
- 优点:内存效率高,支持分布式计算,内置了LDA等高级主题模型。
- 缺点:API相对复杂,学习曲线较陡,主要用于主题建模而非单纯的相似度计算。
- 适用场景:新闻聚类、大规模文档主题挖掘、实时流数据处理。
Hugging Face Transformers(适合高精度语义理解)

传统的VSM基于词袋模型,忽略了词序和上下文,如果你追求更高的语义准确性,可以使用基于BERT等预训练模型的Embedding技术。
- 优点:能理解上下文语义,捕捉同义词和语境差异,精度远超传统TF-IDF。
- 缺点:计算资源消耗巨大,推理速度慢,不适合实时性要求极高的场景。
- 适用场景:智能客服、复杂语义搜索、情感分析。
Python实操:从零构建VSM相似度引擎
光说不练假把式,下面我们通过具体的代码示例,展示如何用scikit-learn快速搭建一个文本相似度计算模块,这一步是理解VSM原理的关键,也是很多开发者在面试或项目中需要展示的核心能力。
环境准备与数据加载
确保你的环境中安装了必要的库,在命令行中执行以下命令即可:
pip install scikit-learn numpy pandas
我们准备一组简单的测试数据,假设我们有三篇关于科技新闻的短文:
- “苹果公司发布了新款iPhone,搭载A17芯片。”
- “三星电子推出全新Galaxy手机,采用骁龙处理器。”
- “今天的天气真不错,适合去公园散步。”
向量化处理核心代码
以下是完整的Python实现代码,重点在于理解fit_transform和transform的区别。
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity
import numpy as np
# 1. 准备语料库
corpus = [
    "苹果公司发布了新款iPhone,搭载A17芯片",
    "三星电子推出全新Galaxy手机,采用骁龙处理器",
    "今天的天气真不错,适合去公园散步"
]
# 2. 初始化TF-IDF向量化器
# min_df=2 表示忽略只在1个文档中出现的词,减少噪声
vectorizer = TfidfVectorizer(min_df=1)
# 3. 拟合并转换数据
# fit: 学习词汇表
# transform: 将文本转换为TF-IDF矩阵
tfidf_matrix = vectorizer.fit_transform(corpus)
# 4. 查看特征名称(即词汇表)
feature_names = vectorizer.get_feature_names_out()
print("词汇表:", feature_names)
# 5. 计算相似度
# 使用余弦相似度计算两两文档之间的距离
similarity_matrix = cosine_similarity(tfidf_matrix)
print("相似度矩阵:")
print(similarity_matrix)
代码解读与结果分析
运行上述代码后,你会得到一个3×3的矩阵,对角线上的值为1.0,表示文档与自身的相似度最高,矩阵中[0,1]位置的数值反映了文档1和文档2的相似度,由于它们都涉及“手机”、“芯片/处理器”等概念,数值会显著高于文档3(关于天气)与其他文档的相似度。

这里有一个关键的技术细节:fit_transform用于训练集,而transform用于测试集或新文档,这意味着你只需要训练一次词汇表,之后对新来的文档只需调用transform即可快速生成向量,这对于在线服务至关重要。
VSM在Python中的性能优化与避坑指南
虽然VSM原理简单,但在实际生产环境中,往往会遇到性能瓶颈,根据行业共识认为,内存管理和算法选择是优化的两大核心方向。
内存溢出问题的解决方案
当文档数量超过10万条时,直接使用TfidfVectorizer可能会导致内存溢出(OOM),解决这一问题有几种有效策略:
- 使用HashingVectorizer:这是一种无状态的特征提取器,它通过哈希函数将词映射到固定维度的向量空间,不需要存储词汇表,因此内存占用恒定,非常适合流式数据。
- 降低ngram范围:默认情况下,
ngram_range=(1, 1)只考虑单字,如果设置为(1, 2),词汇量会指数级增长,对于中文分词,建议根据业务需求谨慎选择n-gram的大小。 - 使用稀疏矩阵存储:scikit-learn默认返回的是CSR(压缩稀疏行)格式的矩阵,这种格式只存储非零元素,极大地节省了内存,切勿将其转换为稠密矩阵(Dense Matrix),除非数据量极小。
中文分词的预处理陷阱
英文文本有空格分隔,可以直接切分,但中文文本需要额外的分词步骤,常见的误区是直接对中文字符进行切分,这会破坏语义。
- 推荐工具:使用
jieba或pkuseg进行中文分词。 - 自定义词典:对于特定领域的术语(如“华为Mate60”),建议加入自定义词典,避免被错误切分为“华为”和“Mate60”。
- 停用词过滤:务必构建一份高质量的停用词表,过滤掉“的”、“了”、“在”等无意义词汇,否则会影响TF-IDF权重的准确性。
VSM与其他搜索技术的对比与选型
在构建搜索系统时,VSM并非唯一选择,了解其与其他技术的优劣,有助于做出正确的技术选型。
VSM vs BM25
BM25是传统搜索引擎(如Elasticsearch)中默认的排序算法,与VSM相比,BM25考虑了文档长度归一化和词频饱和效应。
- VSM优势:实现简单,易于解释,适合小规模数据。
- BM25优势:对长文档更友好,抗噪能力更强,工业界应用更广泛。
- 如果是简单的标签匹配或短文本推荐,VSM足够;如果是全文检索,BM25是更成熟的选择。

VSM vs 深度学习Embedding
深度学习模型(如BERT)生成的向量能捕捉语义相似性,而VSM只能捕捉字面相似性。
- 场景举例:用户搜索“苹果”,VSM可能匹配到“苹果手机”或“苹果水果”,取决于训练数据;而BERT能根据上下文判断用户意图。
- 成本考量:深度学习模型需要GPU加速,推理延迟高,成本高,VSM基于CPU即可高速运行,成本极低。
- 混合策略:最佳实践往往是“粗排用VSM/BM25,精排用深度学习”,先用VSM快速筛选出Top 100候选集,再用BERT进行精细排序。
常见问题解答(VSM Python相关问题)
Python中VSM如何处理未登录词(OOV)?
在标准的TF-IDF实现中,未登录词(即训练集中未出现的词)会被直接忽略,其向量维度为0,这会导致新文档的相似度计算出现偏差,解决此问题的方法包括:使用HashingVectorizer,它通过哈希映射将未知词映射到固定向量空间;或者在训练模型前,使用更广泛的语料库进行预训练,扩大词汇表覆盖范围。
VSM在中文分词后效果不佳怎么办?
中文分词的质量直接决定VSM的效果,如果效果不佳,首先检查分词工具是否准确,特别是专有名词是否被正确切分,尝试引入字符级N-gram(如bigram或trigram),例如将“人工智能”拆分为“人工”、“工智”、“智能”,这样可以捕捉部分语义信息,考虑使用预训练的词向量(如Word2Vec或GloVe)进行加权,而不是简单的TF-IDF。
VSM Python库中哪个最适合实时推荐系统?
对于实时推荐系统,速度是关键,scikit-learn的TfidfVectorizer在数据量较大时预处理较慢,推荐方案是:离线计算好所有文档的TF-IDF向量并存储到向量数据库(如Milvus或Faiss)中;在线服务时,仅对新用户查询进行向量化,然后与预计算的向量库进行快速近似最近邻(ANN)搜索,这种架构平衡了精度与实时性,是目前业界的主流做法。
VSM作为自然语言处理的基石,虽然在深度学习时代显得“古老”,但其简洁、高效和可解释性的特点,使其在特定场景下依然不可替代,掌握Python中的VSM实现,不仅是学习NLP的入门必经之路,更是构建高效、低成本文本处理系统的实用技能。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/vsm-python%e6%98%af%e4%bb%80%e4%b9%88%ef%bc%9fvsm-python%e6%80%8e%e4%b9%88%e5%ae%89%e8%a3%85/