内存告警别只盯着占用率,交换区(swap)的使用情况才是那个最会“隐瞒真相”的变量。 当服务器内存亮起红灯,相当一部分运维同行第一反应是看 free -h 里的used列,但往往真正拖垮性能的,是那个静悄悄增长的swap分区。
内存占用率不高,系统却卡成PPT?问题多半出在交换区
业内专家指出,内存告警的排查逻辑应该是“物理内存不足 → 触发swap → 性能断崖式下跌”,而不是直接看物理内存还剩多少,下面的内容,咱们就把swap这个“幕后角色”的底细翻个底朝天,不管是半夜收到告警短信,还是接手一台卡顿的旧服务器,你都能快速找到那个真正的“内存黑洞”。

为什么说交换区是内存告警的“照妖镜”
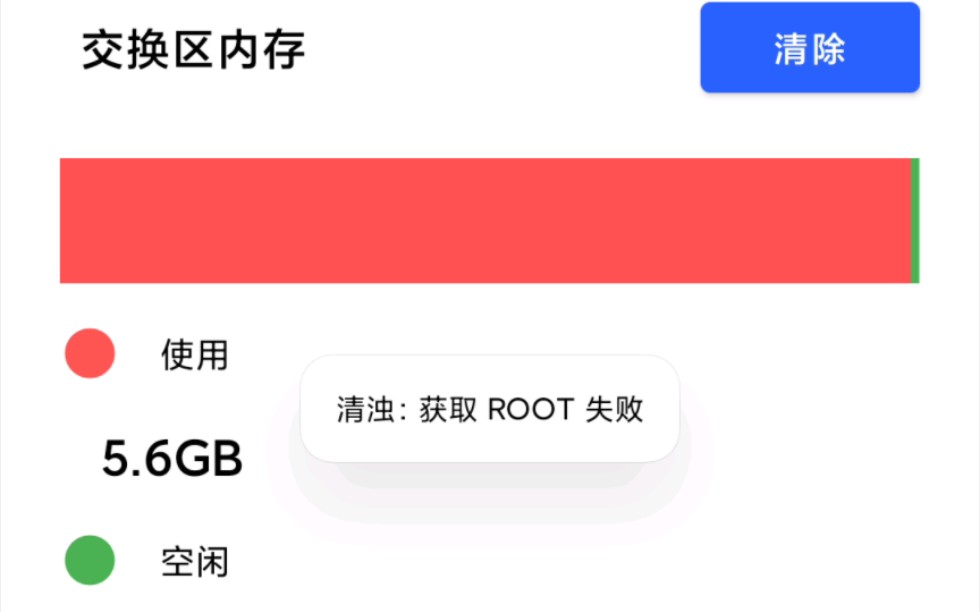
想象一下,物理内存是一个身手敏捷的柜台服务员,而交换区(swap)则是后场的仓库,服务员的台面(内存)可以快速响应客户(进程)的需求,但一旦台面堆满,就得把暂时不用的货物(内存页)搬到仓库里。
问题就出在这个搬运过程上。从内存换出到swap,再到从swap换回内存,这两个动作的耗时比直接访问内存慢几个数量级,就算你的内存占用率只有80%,但只要系统开始频繁使用swap,应用的响应时间就会瞬间飙升。
- 典型场景:数据库查询突然变慢,但CPU利用率不高。
- 排查盲区:看着内存还有余量,但实际上进程的内存页已经被换出,每次读取都要去磁盘“搬货”。
这就是内存占用高交换区使用率也高怎么办这个问题的核心矛盾你需要处理的不是物理内存不够,而是内存回收策略是否合理。
告警阈值别只看百分比,要区分“脏页”和“文件页”
很多监控面板把内存使用率超过90%设为告警线,这其实是个粗糙的做法,行业共识认为:内存告警的评估必须结合/proc/meminfo和vmstat的输出,重点看si(swap in)和so(swap out)这两个指标。
- 若so持续大于0,说明内存压力大,系统正在主动换出内存页。
- 若si持续大于0,说明系统在频繁换入,此时性能已经受损。
- 若si和so均为0,且swap已用空间在增长,说明是内存页被换出后一直没有被访问,属于“静默积压”。
一键定位:用两条命令看清swap的真实压力
不要只看free -g的输出,请用以下组合拳:
# 查看swap使用率及当前内存压力
cat /proc/pressure/memory
# 动态观察swap换入换出速率(每秒刷新)
vmstat 1 5
# 看看谁在占用swap(按占用大小排序)
for file in /proc//status ; do awk '/VmSwap/{size=$2} /Name/{name=$2} END{print size, name}' $file; done | sort -n | tail -10
这组命令能告诉你是谁在悄悄把内存堆进swap,通常结果会出乎意料,占swap最大的进程往往不是内存占用第一的进程,而是一个跑偏的定时任务或内存泄漏的守护进程。
linux服务器内存告警排查:分清“物理耗尽”和“性能劣化”
在实际运维中,linux服务器内存告警排查通常遇到两类截然不同的场景,搞错方向,容易把问题越弄越糟。
场景A:物理内存确实告急,swap沦为“抢救室”
这种情况下,物理内存几乎跑满,free -h显示available非常低,swap使用率持续攀升,此时如果你还在纠结“内存占用率不高啊”,那就是犯了教条主义错误。
正确的处理路径不是急着加内存条,而是先释放被无效缓存占用的内存页:
# 清理页缓存,但不要随意执行!先看下面的解释
sync; echo 1 > /proc/sys/vm/drop_caches
这条命令有风险,生产环境慎用,更稳的做法是调整vm.swappiness参数,让系统更倾向于释放文件缓存,而不是把进程内存换到swap:
# 查看当前值,临时调整(重启失效)
sysctl vm.swappiness
# 永久修改
echo 'vm.swappiness = 10' >> /etc/sysctl.conf
sysctl -p
把swappiness从默认的60调低到10,意味着系统在物理内存还有余量时,优先回收文件缓存,而不是把进程地址空间换出,这能有效缓解“内存占用率看着不高,swap却在涨”的尴尬。
场景B:物理内存还有余量,swap却“爆表”
另一类高发问题:内存才用了70%,swap却已经用了60%,这通常不是内存容量问题,而是内存碎片化或进程内存页异常锁定。
- 检查是否有进程使用了
mlock()系统调用,导致内存页无法被回收。 - 检查内核版本是否有内存管理相关bug(如旧版内核在特定io负载下swap膨胀)。
- 检查
/proc/sys/vm/min_free_kbytes设置是否过大,导致可用内存被预留,触发早期swap。
针对性的服务器内存检查工具和查看方法
对于服务器内存检查工具这一块,除了free、top、vmstat,建议多用sar -r(历史趋势)和ps aux --sort=-rss(物理内存排序)来交叉验证。
# 查看历史内存使用趋势(需安装sysstat)
sar -r -f /var/log/sa/sa$(date +%d) | grep -E 'kbmemfree|kbmemused|kbswpused'
但别忘了,sar统计的是瞬时值,不是压力峰值,最好是结合监控系统的告警历史,倒推内存是缓慢泄漏(持续数月)还是突发性飙升(几分钟内)。
简米云服务器内存告警怎么办:别急着升配,先看swap水位
很多在简米云、酷番云上跑业务的团队,一看到简米云服务器内存告警怎么办的工单,第一反应就是提工单升配内存,这是最贵且最无效的解法。
云服务器的swap特殊陷阱:swapfile在系统盘上
云服务器的swap分区通常位于系统盘或数据盘上,磁盘IO性能远低于本地物理机的NVMe盘,这意味着云服务器一旦开始swap换入换出,性能衰减比物理机更明显。
- 绝大多数云主机默认swapfile大小是0,需要自己配置。
- 但配置不当会引发磁盘IOPS瓶颈,最典型的症状是load average飙升,但CPU和内存都“正常”。
正确姿势:先看云监控里的“内存使用率”和“磁盘IO延迟”关联图
如果告警时磁盘IO读写延迟同步升高,说明就是swap在作祟,此时你要做的不是升配,而是限制swap的使用频率:
# 将swappiness调整为0,让内核在内存不足时优先杀掉低优先级进程,而不是swap
sysctl -w vm.swappiness=0
但注意,swappiness=0不代表不用swap,只是降低使用倾向,如果确实需要swap兜底,建议单独购买ESSD云盘并创建swap分区,避免和系统盘抢IO,这一段在简米云服务器内存告警怎么办这个搜索意图下,实操价值远高于“建议升配”这种万金油答案。
内存监控的最终武器:基于“使用率+swap趋势”的复合告警
为了避免在半夜被无效告警吵醒,监控策略必须升级,不要设置单阈值,要用组合条件触发。
| 告警场景 | 监控项1 | 监控项2 | 阈值建议 | 处理动作 |
|---|---|---|---|---|
| 慢请求 | 内存使用率 > 85% | swap使用率 > 50% | 持续5分钟 | 抓ps aux和vmstat 1 10,重启异常进程 |
| swap异常增长 | 内存使用率 < 70% | swap使用率 > 30% | 持续10分钟 | 检查/proc/pressure/memory的si/s0值,查泄漏进程 |
| 内存泄漏 | swap使用率爬升斜率 | rss增速对比 |
24小时基线 | dump堆栈,检查malloc或jvm参数 |
写在最后:内存告警的本质是性能告警,不是容量告警。 swap使用率才是衡量服务器内存是否“真饱和”的试金石,下次通知群再响起内存告警,不妨先运行一下vmstat 1 1,看看si和so的数值,再做判断,这比盲目看占用率山头来得靠谱得多。
关于内存告警和交换区的常见疑问
为什么swap还有很多空余,内存却显示告警?
因为内存告警通常基于物理内存使用率触发,而swap空余多说明系统还没把压力传导到磁盘,但这并不代表进程性能没受损内核可能在后台进行内存压缩(memory compaction)或快速回收页缓存,这些操作同样会消耗CPU并引发延迟,所以物理内存告警可能发生在swap被大量使用之前,两者存在时间差。
增加物理内存后,swap占用会自动清零吗?
不会。已经被换出的内存页面不会因为物理内存变大而自动换回,只有进程再次访问这些内存页时,内核才会通过缺页异常将其换回物理内存,这也是为什么加了内存条后,swap使用率依然居高不下的原因,解决思路是修改/proc/sys/vm/drop_caches配合swapoff -a && swapon -a来强制重建swap空间,但这会导致短暂的服务中断,生产环境请配合业务维护窗口操作。
有没有必要完全关闭swap来提升性能?
不建议在Linux服务器上完全关闭swap,除非你的业务有极端低延迟要求(比如高频量化交易)且内存余量常年大于30%。 行业共识认为,swap在内存峰值压力下是最后一道缓冲,直接关闭可能导致OOM Killer频繁触发,误杀关键业务进程,正确的优化方向是调低vm.swappiness并精细化管理内存分配,而不是简单粗暴地用swapoff命令,存在内存泄漏风险的Java应用或Python服务,保留少量swap反而能争取到内存溢出前的现场留存时间。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/627677.html