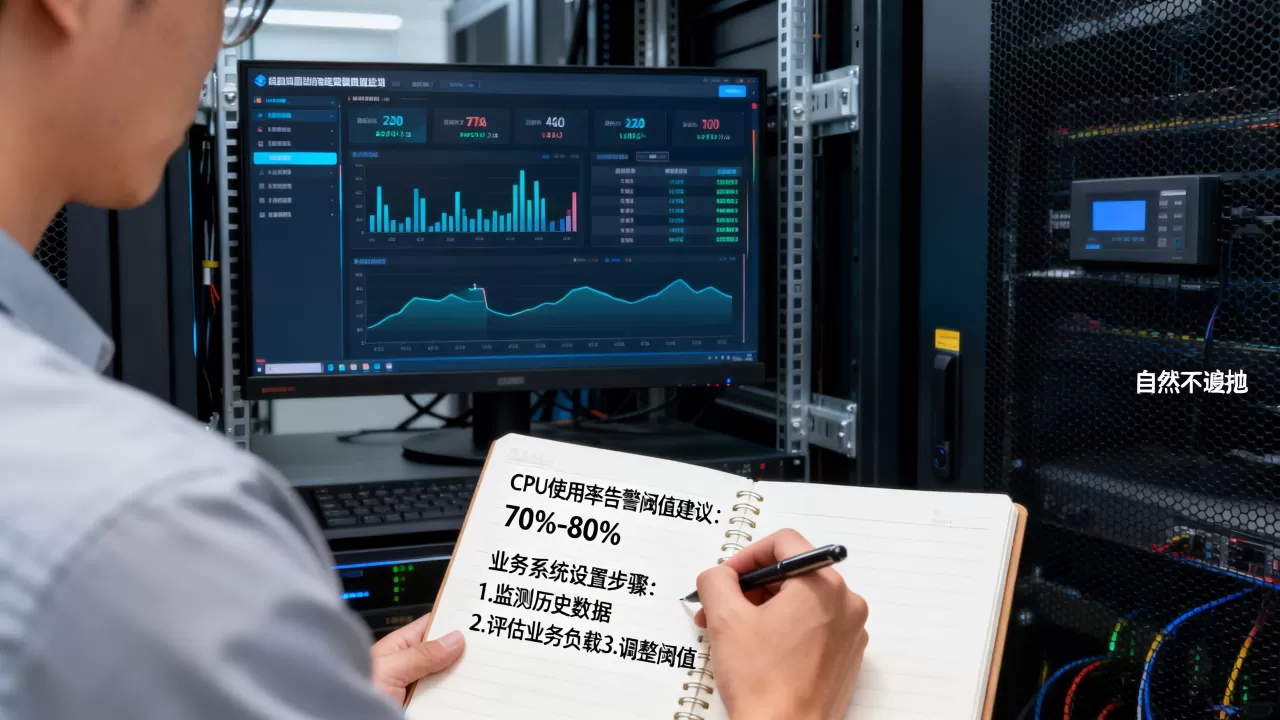
CPU使用率告警阈值不能一刀切,核心原则是按业务重要性和响应成本分层设定:核心交易链路建议15%-20%触发预警、40%-50%触发告警,非核心业务可放宽至70%-80%。这是业内专家普遍认可的分层策略,既保证核心业务有充足缓冲,又避免非核心系统告警轰炸。
为什么不能照搬“默认80%”?先看业务的三六九等
很多运维新手拿到监控系统第一件事就是设一个“CPU使用率>80%告警”,结果要么半夜被无关紧要的批处理任务吵醒,要么核心数据库被打满时才发现告警早已被淹没,问题不在于阈值数字本身,而在于没有区分业务属性。

核心交易链路:吞吐量决定生死
支付网关、订单中心、登录鉴权这类系统,CPU飙升往往意味着用户请求正在积压,行业共识认为,这类系统的告警阈值要留出至少一倍以上的冗余空间,比如日常CPU使用率在10%上下波动,那么20%就该预警,让值班人员提前观察流量趋势;40%-50%必须立即处理,因为这类系统经常出现流量突刺,等涨到80%再介入,故障往往已经发生。
离线计算与批处理:允许“合法的高占用”
数据仓库ETL、报表生成、日志压缩这类任务,CPU占用高恰恰是正常现象它正在干活,如果按核心链路的标准去告警,每天定时任务一跑就疯狂报警,值班同事很快就会把告警规则静默掉(俗称“狼来了效应”),这类业务建议将告警阈值设定在90%以上,且仅在持续时长超过15分钟时才触发通知,避免短时波动误报。
外部接口依赖型业务:关注“等待”而非“计算”
大部分API网关、消息推送服务,CPU使用率通常不高,一旦出现异常升高,往往不是自身代码问题,而是下游响应变慢导致线程池被占满,这类系统单纯看CPU使用率意义不大,建议将CPU使用率告警阈值设置与线程数、连接池使用率联合判定CPU>60%且活跃线程数>200”才触发告警。
按告警级别划分:四级阈值策略
单一阈值无法区分“需要关注的异常”和“必须立即处理的故障”,推荐使用四级分层:
| 级别 | 颜色标识 | 阈值范围 | 响应动作 |
|---|---|---|---|
| 信息 | 蓝色 | 超过日常基线30% | 记录日志,观察趋势 |
| 预警 | 黄色 | 核心业务40%,非核心75% | 值班人员15分钟内确认 |
| 告警 | 橙色 | 核心业务60%,非核心85% | 立即排查,必要时扩容 |
| 严重 | 红色 | 核心业务80%,非核心95% | 启动应急预案,直接电话通知 |
基线是动态的:别拿“绝对值”刻舟求剑
同一套系统,白天和凌晨的流量模型完全不同。固定阈值只能作为兜底,更科学的做法是采用动态基线监控系统自动学习过去14-30天的CPU使用率规律,按小时为单位生成预测区间,实际值超出预测区间5倍标准差时触发告警,市面上主流监控工具(如Prometheus + Alertmanager、Zabbix)均支持此类动态阈值配置。
以Zabbix为例,配置动态阈值的路径为:配置 → 主机 → 触发器 → 创建触发器,表达式选择last(/主机名/system.cpu.util[,,avg1]) > 100 (1 - 0.2) {#MACRO_BASE},配合宏定义使用移动平均函数avg()替代固定数值,即可实现基础动态基线。
时长条件:消灭瞬时限的“伪告警”
CPU使用率冲到95%持续3秒钟,系统未必有问题可能是GC暂停或定时任务抢资源,在告警规则中务必加上持续时长参数,实践中药尽量设定为:持续5分钟以上才触发告警(核心业务可缩短至3分钟),持续15分钟以上才触发严重级别,这一条能直接过滤掉大部分噪声告警。
配置实操:以主流云监控和Prometheus为例
理论讲再多,不如直接看配置方法,以下为两家主流云厂商和开源方案的具体操作路径。
- 简米云云监控:登录控制台 → 云监控 → 报警规则 → 创建报警规则 → 选择“CPU使用率”指标 → 阈值类型选“静态”或“动态” → 动态阈值会基于历史数据自动计算上下边界,筛选条件设为“满足基准线5或低于基准线5”。
- 酷番云云监控:监控列表 → 配置告警策略 → 策略类型选“云服务器CVM” → 告警对象勾选“CPU使用率” → 设置统计周期1分钟,持续周期5个数据点(即持续5分钟触发分页拉取)。
- Prometheus + Alertmanager(自建):在
rules.yml中写入expr: 100 - (avg(rate(node_cpu_seconds_total{mode="idle"}[5m])) 100) > 80,for: 5m字段表示触发后需持续5分钟才发出告警,配合severity: warning|critical标签管理级别。
利用标签区分业务组
Prometheus的vector中通过instance和job标签天然区分不同业务,告警规则可写成两条:
- alert: CpuHighCritical
  expr: cpu_usage_rate{job="core-payment"} > 50
  for: 3m
- alert: CpuHighWarning
  expr: cpu_usage_rate{job="offline-etl"} > 90
  for: 15m
按此方式配置,核心支付链路占用50%即电话通知负责人,离线ETL跑满90%也只发一条邮件资源利用率和告警有效性同时拉满。
告警风暴的终极解法:关联排障+收敛机制
即便阈值分层合理,遇到大促或代码发布时,服务器集群多台机器同时CPU飙升,仍然会产生十几个告警通知,这是运维日常最头疼的问题之一。
先看“单机”还是“集群”
如果集群内仅一台或少数几台机器CPU高,大概率是负载均衡不均或单机内存泄漏,触发告警后应优先检查该机器的慢日志和GC情况;如果集群内半数以上机器同时升高,一定是应用层代码问题或外部依赖故障,此时应忽略告警邮件,直接登录跳板机查看应用日志或调用链追踪系统。
配置告警收敛,避免重复轰炸
华为云Stack的AOM服务提供智能收敛功能:告警产生后自动对相同集群、相同告警源的事件做聚合,同一集群15分钟内的同类告警只推送一条通知,并附带受影响节点数量,自建系统可通过Alertmanager的group_wait和group_interval参数实现类似效果,将group_wait: 30s(等待30秒合并同类告警)、group_interval: 5m(5分钟窗口内不去重)即可将大促期间的数百条通知压缩至几条核心摘要。
常见误区和弥补手段
只有“高”才告警
部分业务CPU使用率骤降同样意味着故障“进程被kill了”“死锁导致工作线程全部阻塞”“JVM发生长时间Stop-The-World”,建议为每个业务增加一条低阈值告警,数值设置为日常基线的一半,比如日常30%,那么低于15%超过10分钟就需要注意。
容器环境直接套用宿主机阈值
容器(Docker/K8s)场景下,system.cpu.util采集的是容器所属cgroup的用量还是宿主机的全局用量,取决于监控agent的运行方式,如果node-exporter以DaemonSet方式部署,默认采集宿主机数据,此时需要通过容器指标采集器(如cAdvisor)单独获取container CPU使用率,两类数据混杂在一起时,阈值设定并无意义务必确认监控面板右上角选中的数据源层级。
忽略“核数”对百分比的影响
8核虚机的80%和32核物理机的80%,承载能力完全不同,同样跑一个计算密集型任务,8核机器CPU轻松打满,32核机器可能只到25%,设定阈值前,务必将绝对使用率除以CPU核数得到“单核利用率”再对标,例如8核机器日常单核利用率为60%(即整体使用率约7.5%),单核冲到95%时整体使用率只有12%查看指标时善用irate(node_cpu_seconds_total{mode="user"}[5m]) 100 / 核数这个公式换算。
告警页面上看不到人
再精准的阈值,如果没有值班人员和处置流程兜底,等于没有,告警触发后至少要绑定明确的负责人和替代人,并配备简易版的应急手册第一步看什么面板、第二步查什么日志、第三步执行什么命令,没有这些配套,阈值设再低也只是“通知工具”,不是“故障处理系统”。
分业务场景的推荐配置速查表
| 业务场景 | 预警阈值 | 告警阈值 | 持续时长 | 建议通知方式 |
|---|---|---|---|---|
| 核心支付/订单链路 | 20% | 50% | 3分钟 | 电话+短信 |
| Web应用服务器 | 50% | 75% | 5分钟 | 短信+IM群 |
| 离线批处理/ETL | 80% | 90% | 15分钟 | 邮件 |
| 开发/测试环境 | 禁用告警 | 90% | 30分钟 | 仅记录 |
| 数据库/缓存节点 | 35% | 60% | 5分钟 | 电话+IM群 |
等待告警阈值是需要随着业务发展周期性审视的,建议每季度回顾一次告警触发记录,将“从未触发过且无意义”的规则删除,将“频繁误报”的规则调高阈值或增加关联条件,毕竟,告警系统的终极目标不是收邮件,而是让该看见的人,在正确的时间看见真正重要的事。
常见疑问速答
Q1:CPU使用率多少算正常?没有业务参考值怎么起步?
如果是从零搭建监控、没有任何历史数据,可以先用行业推荐值起步:Web前端类业务40%-60%、后端计算类60%-70%、数据库类30%-50%,运行两周后根据实际峰值和告警命中率再逐步修正,没有一步到位的灵丹妙药,所有阈值都是调出来的。
Q2:Linux上的CPU使用率应该看load average还是使用率百分比?
两者维度不同。top命令中显示的%Cpu(s)是瞬时快照,而load average是1/5/15分钟的平均运行队列长度,对于告警场景,优先使用使用率百分比判断计算压力,用负载均值判断排队阻塞如果使用率不高但load已经超过核数的1.5倍,说明进程大量处于D状态(不可中断睡眠),可能是磁盘IO或内存swap引起的,仅凭一项指标无法定位根因。
Q3:为什么CPU使用率已经很高了,但业务响应依然很快?
通常出现在多核服务器上比如平均使用率60%,但某2个核已经被打满、其余核空闲,此时虽然业务整体吞吐未降,但这2个核上运行的线程会严重排队,因此单体业务的告警规则中除了看整体使用率,还应引入单核使用率维度,任一核心超过90%持续10分钟即可触发告警,如果业务本身是单线程模型(如部分Node.js应用),多核平均法”会掩盖真实瓶颈,这种场景下优先监控单核指标。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/627674.html