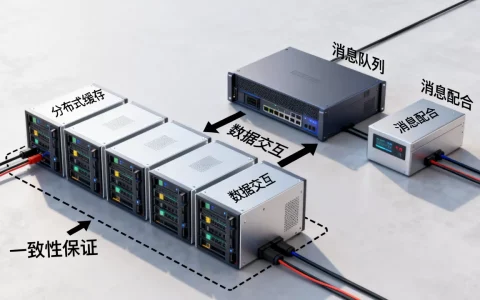
分布式缓存是通过将缓存数据分布在多台服务器上,旨在解决单机缓存容量不足、单点故障以及在海量并发请求下减轻数据库压力,从而提升系统整体响应速度和可用性的关键技术方案。
分布式缓存的核心作用与技术逻辑
在现代互联网架构中,数据库通常是系统的性能瓶颈,由于磁盘I/O速度远低于内存,当访问量激增时,数据库的查询响应时间会显著增加,甚至导致系统崩溃,分布式缓存的作用就在于在应用程序与数据库之间构建一个高速数据缓冲层。
降低数据库访问压力
业内专家指出,绝大多数互联网应用的读写比极高,这意味着大部分请求是重复的读取操作,分布式缓存通过将高频访问的数据存储在内存中,使得请求在到达数据库之前就被拦截并响应,这种机制将数据库从繁重的查询任务中解放出来,使其能够专注于处理关键的写操作和复杂事务。
提升系统响应速度
内存的读写速度比磁盘快几个数量级,分布式缓存将数据以键值对(Key-Value)的形式存储在RAM中,消除了复杂的SQL解析、索引扫描和磁盘寻道时间,对于用户而言,这意味着页面加载时间从秒级降低到毫秒级。
增强系统的横向扩展能力
单机缓存受限于单台服务器的内存上限,分布式缓存采用分片(Sharding)技术,将数据分布在不同的节点上,当数据量增加或并发量提升时,可以通过简单地增加服务器节点来线性扩容,而无需修改核心业务逻辑。
分布式缓存和本地缓存的区别是什么
在选择缓存方案时,开发者经常在本地缓存(如Guava Cache, Caffeine)与分布式缓存(如Redis, Memcached)之间权衡,两者的核心差异在于数据的一致性和存储规模。
存储维度与可见性
本地缓存存储在应用程序的JVM堆内存中,每个应用实例拥有独立的缓存副本,这意味着如果系统部署了10个实例,同一份数据会被存储10次,而分布式缓存是一个独立的中间件集群,所有应用实例共享同一份数据,确保了数据的全局唯一性。
数据一致性挑战
本地缓存最严重的问题是数据不一致,当某个实例更新了数据,其他实例的缓存依然是旧值,除非引入复杂的同步机制,分布式缓存则天然解决了这个问题,所有请求访问同一个缓存集群,更新一次,全局生效。
性能与网络开销
本地缓存无需网络传输,响应速度达到纳秒级;分布式缓存需要通过TCP/IP协议进行网络通信,存在毫秒级的网络延迟。
核心差异对比表
| 维度 | 本地缓存 | 分布式缓存 |
|---|---|---|
| 存储位置 | 应用进程内存 | 独立缓存服务器集群 |
| 访问速度 | 极快(无网络开销) | 快(有网络开销) |
| 数据一致性 | 难以保证(实例间不同步) | 强一致性/最终一致性 |
| 扩展性 | 随实例增加而增加,但冗余高 | 独立扩容,存储空间大 |
| 可用性 | 随应用重启而失效 | 独立运行,支持持久化 |
高并发场景下如何选择分布式缓存方案
面对不同规模的并发压力,缓存方案的选择不能一概而论,行业共识认为,方案的选择应基于数据的读写比、一致性要求以及预算成本。
读多写少的静态场景
对于配置信息、商品详情页等更新频率低但访问量巨大的场景,建议采用多级缓存架构:本地缓存 + 分布式缓存。
- 第一级(本地缓存):存储极高频的“热点”数据,过滤掉90%的请求。
- 第二级(分布式缓存):存储海量的中频数据,确保数据的一致性。
- 第三级(数据库):作为最终数据源。
读写均衡的动态场景
对于社交动态、实时库存等频繁更新的场景,应直接使用分布式缓存,并严格控制缓存失效时间(TTL),此时应重点关注缓存更新策略:
- Cache-Aside(旁路缓存):先读缓存,不命中则读数据库并回写缓存;更新时先删缓存,再更新数据库。
- Write-Through(写穿):更新缓存的同时同步更新数据库。
应对极端并发的特殊策略
在秒杀等极端场景下,为了防止分布式缓存成为新的瓶颈,需实施以下操作:
- 热点Key探测:通过监控实时发现访问量异常的Key,将其动态推送到各应用节点的本地缓存中。
- 缓存预热:在活动开始前,通过脚本将核心数据提前加载至分布式缓存,避免瞬间流量击穿数据库。
分布式缓存的实操部署与优化路径
以行业主流的Redis集群为例,实现一个高性能的分布式缓存系统需要经过精准的配置与调优。
集群部署基础步骤
- 环境准备:准备至少3台物理机或虚拟机,安装Redis服务端。
- 配置分片:编辑
redis.conf,开启cluster-enabled yes,配置cluster-config-file。 - 创建集群:执行命令
redis-cli --cluster create <ip1:port1> <ip2:port2> ... --cluster-replicas 1,此步骤将数据分布到16384个哈希槽中,并为每个主节点配置一个从节点以保证高可用。 - 客户端连接:使用支持集群模式的客户端(如Jedis, Lettuce),通过连接池管理连接,减少TCP握手开销。
关键性能优化参数
- 内存淘汰策略:当内存满时,建议设置
maxmemory-policy allkeys-lru(最近最少使用),确保高频数据被保留。 - 持久化权衡:在高并发场景下,建议关闭RDB快照或降低AOF同步频率(使用
appendfsync everysec),以减少磁盘I/O对响应时间的影响。 - 连接池调优:根据并发量设置
maxTotal(最大连接数)和maxIdle(最大空闲连接数),避免频繁创建销毁连接。
常见故障预防操作
- 防止缓存击穿:对于绝对不能缺失的Key,设置永不过期,或使用分布式锁(SETNX)确保只有一个请求去加载数据库。
- 防止缓存雪崩:在设置TTL时,给过期时间增加一个随机扰动值(如
TTL = 3600 + random(0, 300)),避免大量Key在同一时间集体失效。 - 防止缓存穿透:使用布隆过滤器(Bloom Filter),在请求进入缓存前,先通过布隆过滤器判断该Key是否存在于数据库中,不存在则直接返回空,拦截非法请求。
Redis分布式缓存部署成本分析
企业在引入分布式缓存时,必须考虑硬件成本与运维成本的平衡。
硬件成本构成
分布式缓存的核心成本在于内存,由于内存单价远高于磁盘,大规模部署时,内存容量将直接决定预算。
- 基础内存成本:根据数据量估算,若存储1TB数据,考虑到Redis的内存碎片和元数据开销,实际需要约1.2TB-1.5TB的物理内存。
- 计算资源:Redis是单线程模型(核心处理),对CPU主频要求较高,但对核心数要求较低。
运维成本分析
- 监控成本:需要部署Prometheus + Grafana等工具,实时监控内存命中率、CPU负载和网络带宽。
- 人力成本:集群的扩容、缩容以及数据迁移(Resharding)需要专业的运维人员操作,以避免在迁移过程中产生性能抖动。
投资回报率(ROI)评估
尽管内存成本较高,但通过分布式缓存降低的数据库硬件成本(如减少昂贵的企业级SSD或高端数据库授权)以及提升的用户留存率(响应速度提升),通常能使系统在半年内实现正向ROI。
分布式缓存的作用不仅在于简单的“加速”,更在于通过内存分层架构,为海量数据访问提供一个可扩展、高可用且低延迟的缓冲地带,它通过牺牲一定的空间一致性,换取了系统在极端负载下的生存能力。
分布式缓存作用相关问题 Q&A
分布式缓存的作用在电商大促中如何具体体现?
在电商大促(如双11)期间,商品详情页的访问量会瞬间提升数百倍,分布式缓存通过将商品价格、库存、描述等静态信息存储在内存中,使得99%的查询请求在缓存层被拦截,数据库仅处理下单时的库存扣减事务,这有效防止了数据库因连接数过多而宕机,保证了购物流程的流畅性。
如何解决分布式缓存与数据库的数据一致性问题?
业界最常用的方案是延迟双删策略,具体步骤为:先删除缓存 $\rightarrow$ 更新数据库 $\rightarrow$ 睡眠一小段时间(如500ms) $\rightarrow$ 再次删除缓存,这样可以确保在并发环境下,即便有读请求在更新期间将旧数据写回缓存,也能被第二次删除操作清除,从而保证最终一致性。
参考5分布式缓存是否可以完全替代数据库?
不能,分布式缓存基于内存,具有易失性,且不支持复杂的关联查询(Join)和事务处理,数据库提供的是数据的持久化存储和强一致性保证,而分布式缓存提供的是高性能访问,两者在架构中是互补关系,而非替代关系。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/493779.html