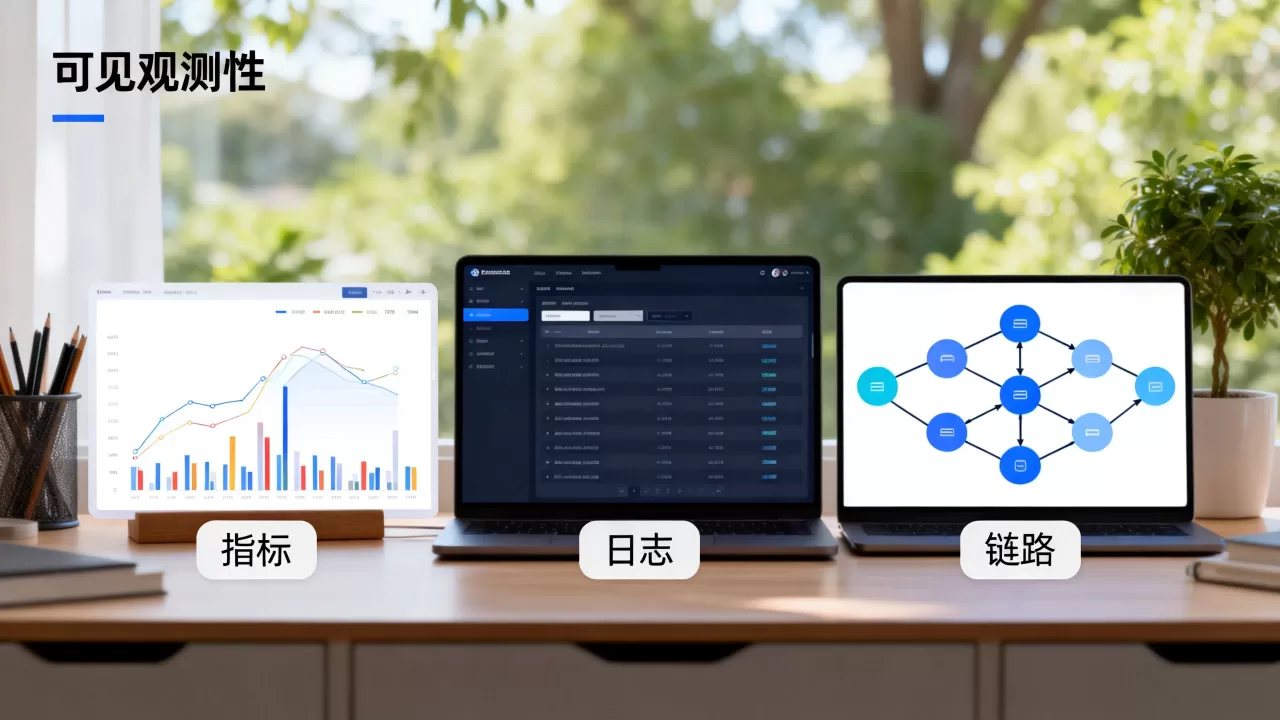
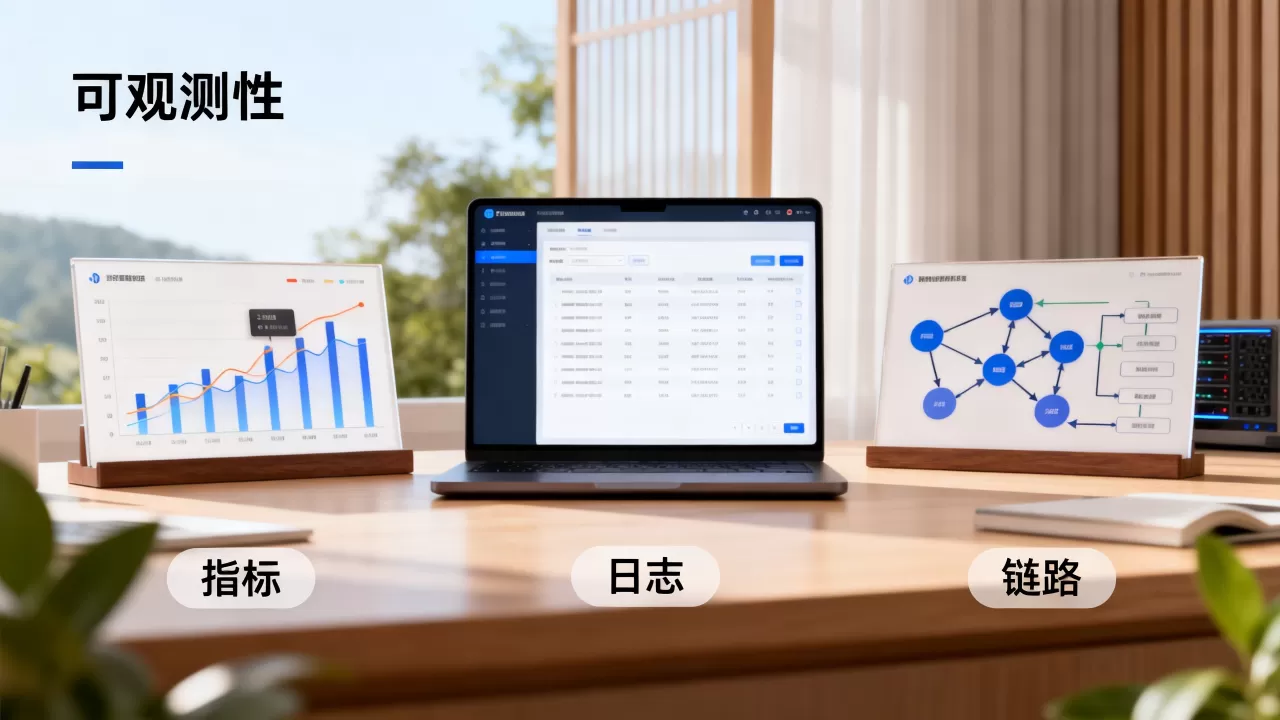
可观测性三大支柱是指日志、指标和链路追踪,三者分别回答“发生了什么”“出了什么问题”“问题出在哪里”,共同构成现代系统排障的完整拼图。
这就像一个人到医院体检:指标是体温、血压这类生命体征,日志是病人自述的详细症状,链路追踪则是医生开出的检查单,沿着一条路径找到病灶,缺了任何一块,诊断都容易误判。

可观测性三大支柱分别是什么
行业共识认为,三大支柱由分布式系统监控实践演化而来,分别承担不同维度的数据采集与语义表达。
指标:系统的“生命体征”
指标是数值型数据的聚合,例如CPU使用率、请求QPS、错误率、延迟分位数,它的特点是轻量、可聚合、适合长期存储,并且天生适合触发告警。
- 典型工具:Prometheus、Grafana、Zabbix、CloudWatch
- 核心价值:以秒级粒度发现异常,回答“系统当前是否健康”
- 常见采集方式:Exporter暴露端点,Prometheus定期拉取(Pull模型)
实际排障中,指标永远是第一步,当收到告警电话,先看仪表盘上哪个指标飘红,再决定下一步动作,而不是直接翻日志。
日志:事件的全量“口供”
日志记录系统运行过程中发生的离散事件,包含时间戳、上下文、堆栈信息,是排障时信息量最大的数据源。
- 典型工具:ELK(Elasticsearch + Logstash + Kibana)、Loki、Splunk
- 核心价值:回答“发生了什么”,提供不可替代的细节上下文
- 关键要求:结构化、集中采集、保留一定的上下文关联能力
比如一个支付接口偶发超时,指标只能告诉你“P99涨了”,日志却能告诉你那一秒里具体是哪个上游响应慢了、数据库连接池拿了多久。
链路追踪:请求的全路径“监控录像”
链路追踪(Tracing)为每一个外部请求分配全局唯一ID(TraceID),记录调用经过的每个服务、每个内部调用的耗时与状态。
- 典型工具:Jaeger、Zipkin、SkyWalking、OpenTelemetry
- 核心价值:回答“问题出在哪个环节”,打通服务间的调用关系
- 关键概念:Trace(全链路)、Span(单次调用片段)、TraceID(串联标识)
微服务架构下,一个请求可能跨五六个服务,没有链路追踪,就得靠人肉在多个服务日志里翻找同一个错误,效率极低,总链路耗时在哪里暴涨,链路追踪一眼可见。
| 支柱 | 语义 | 典型问题 | 代表工具 |
|---|---|---|---|
| 指标 | 数值聚合 | 系统健康吗 | Prometheus、Grafana |
| 日志 | 离散事件 | 发生了什么 | ELK、Loki |
| 链路追踪 | 调用路径 | 问题在哪一环 | Jaeger、SkyWalking |
日志指标链路追踪怎么配合排查线上故障
三者不是孤岛,而是层层递进的排障漏斗,以一次典型的订单服务超时为例,排查流程通常是:
- 指标告警触发,发现下单接口错误率抬升
- 打开链路追踪,定位到“库存服务”耗时异常,耗时占比超过80%
- 获取该TraceID,在日志系统中精确检索这一次请求的完整日志
- 日志显示数据库连接池等待超时,进而排查数据库负载,确认是慢SQL导致
如果没有链路追踪,第三步就无从下手,只能盲搜日志、靠时间戳猜关联;如果没有日志,定位到库存服务后也无法获知具体失败原因,三者协作,才能把“系统异常”一步步收敛到“某条SQL语句执行了3秒”。
关联三者的主流方式
- TraceID贯穿日志:业务日志中输出TraceID,日志平台支持按TraceID联动查询链路数据
- 统一打点规范:日志、链路Span都带上统一的业务标签(订单号、用户ID)
- 告警联动入口:每条告警通知里附上对应时间窗的看板链接和Trace查询入口
业内专家指出,成熟的可观测性平台(如开源组合OpenTelemetry + Prometheus + Loki + Tempo)已支持从指标直接跳转到关联日志与链路数据。
可观测性和APM有什么区别
APM(应用性能监控)侧重于应用层面的性能度量与拓扑发现,而可观测性强调通过三种数据自由探索未知问题,两者常被混为一谈,实则覆盖范围不同。
核心差异对比
| 维度 | 可观测性 | APM |
|---|---|---|
| 数据来源 | 日志、指标、链路(三类原始数据) | 侧重指标和调用链,覆盖日志较弱 |
| 问题定位 | 支撑未知问题的探索与根因分析 | 偏向已知指标的阈值告警 |
| 架构范围 | 基础设施、中间件、应用全栈 | 多聚焦应用服务层 |
| 工具生态 | 以OpenTelemetry为核心的开源体系 | 一般由商业厂商闭源提供 |
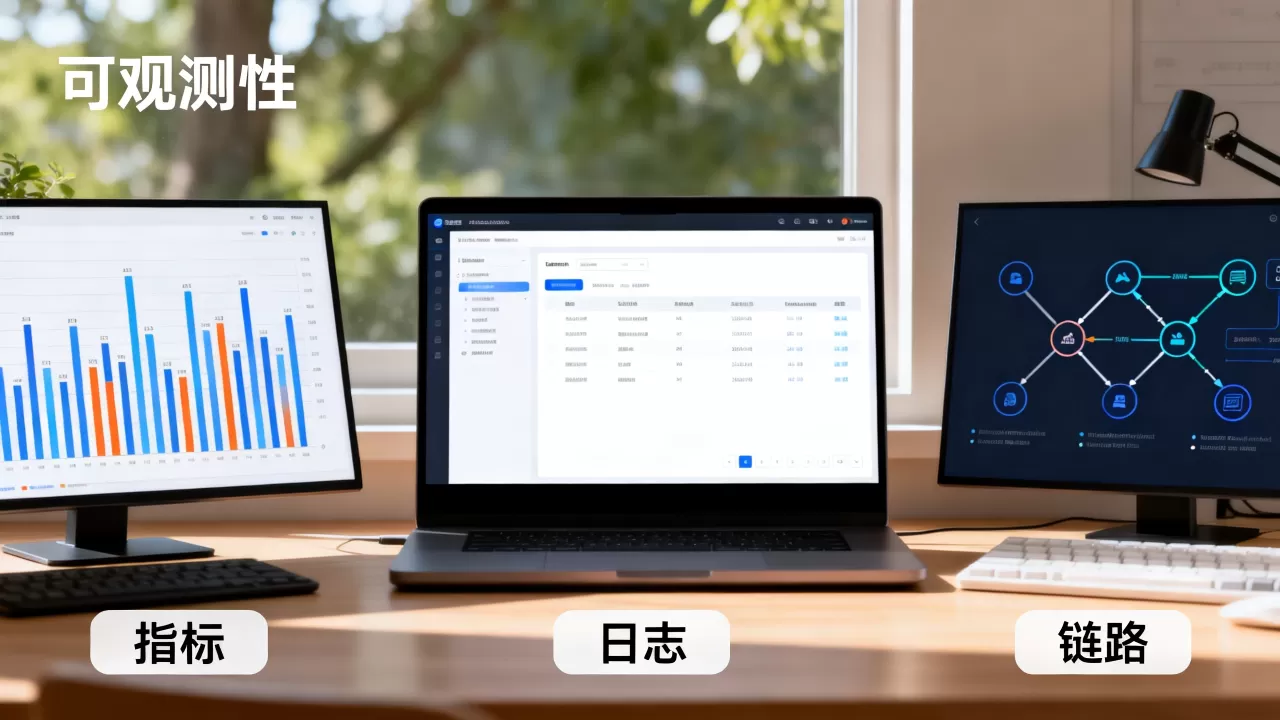
对于云原生环境(K8s、微服务、Serverless),系统不确定性大幅增加,单纯依赖APM的预定义指标很难覆盖新出现的故障模式。可观测性是APM的演进方向,APM是可观测性的一个子集,实操选型时,小团队可以先上APM(如SkyWalking、Pinpoint)快速获得应用视角,再逐步补充日志平台与基础设施指标。
云原生可观测性工具怎么选
选型不是追新,而是匹配团队规模与排查效率,不同规模团队的推荐路径如下:
- 小团队(10人以内):轻量组合,不建议自建ELK,可以使用托管型日志服务加Prometheus主机监控,链路部分优先选择接入式APM,减少运维负担
- 中大型团队(50人以上):自建或使用云厂商托管,落地OpenTelemetry统一埋点,日志、指标、链路三条管线分别管理,再做上层关联
- 已有商业APM成本较高的情况:可考虑性价比组合,用开源Loki替代Elasticsearch,日志存储成本能下降不少
具体接入步骤(以Kubernetes集群为例):
- 集群内部署OpenTelemetry Collector,作为所有可观测性数据的统一入口
- 应用SDK接入OpenTelemetry,自动上报Trace与Metric
- 部署Prometheus Operator采集集群节点与工作负载指标
- 日志采用Filebeat或Promtail采集,标准输出落盘,集中到Loki或Elasticsearch
- Grafana配置数据源,将Loki、Prometheus、Tempo(链路)接入同一面板
- 在Grafana中启用“logs to traces”“traces to logs”联动功能
nginx、MySQL等中间件的指标与日志同样可以纳入同一套采集链路,多数情况下,这套开源方案能覆盖七成以上业务需求,只有极少数需要海量日志检索的场景才需要引入商业日志平台。
落地时最容易踩的坑
日志没有结构化
纯文本日志无法被系统高效检索和聚合,采集前应规范字段,比如统一使用JSON格式输出,包含时间、级别、服务名、TraceID、关键业务字段。
指标告警覆盖不足或过载
告警过多会产生噪声疲劳,过少则漏掉关键故障,建议优先覆盖:服务的可用性(5xx比例)、饱和度(CPU、内存、连接数)、延迟(P99)。
链路追踪覆盖不全
只对核心入口服务接入了链路,内层服务没有接入,排查跨服务问题时链路就断了,应制定标准,覆盖所有内部服务间的同步与异步调用,包括消息队列。
数据量大导致成本失控
日志存储是主要成本来源,按日志的“热、温、冷”分层设置保留周期是常规做法:热日志保留7天,温日志保留30天,冷日志归档到对象存储,据行业共识,日志体量中约80%属于低频访问数据,分级存储能显著压缩成本。
关于可观测性三大支柱的常见问题
日志、指标、链路追踪可以只用其中一种吗?
可以,但排障效率会明显打折扣,只用指标只能知道异常发生,链路线索缺失时细节无从追溯;只用日志则难以发现趋势变化,排查一个秒级波动的高频问题,逐个翻日志几乎不现实,大多时候三者的信息彼此互补,缺一不可。
OpenTelemetry是什么,和三大支柱有什么关系?
OpenTelemetry是云原生计算基金会旗下的开源可观测性标准框架,统一了指标、日志、链路三类数据的采集与传输格式,它本身不是存储或展示平台,而是数据接入的事实标准,当前主流开源工具如Jaeger、Prometheus、Grafana都能直接接收OpenTelemetry格式的数据。
可观测性三大支柱和传统监控系统的最大区别是什么?
传统监控基于预定义指标和阈值,系统没被监测到的盲区出现问题时就看不见,三大支柱中,日志与链路追踪提供原始上下文,指标提供横向视图,三者结合能回答事先想不到的“新问题”,本质是从“已知的异常触发告警”走向“未知问题可被自由探查”。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/623285.html