在线分析的内存需求从来不是恒定的,它像一个弹性容器,查询结果集越大,容器就被撑得越大只要结果集还在变,内存占用就会持续波动,这是所有OLAP场景都绕不开的核心规律。
在线分析的内存需求为什么总跟着结果集走
很多人把内存问题简单归结为“数据量太大”,其实在线分析和离线批处理对内存的诉求完全是两回事,离线任务跑完就结束,内存峰值过了就释放;在线分析则要求查询在秒级内返回结果,内存的分配和释放始终围绕“结果集”这个中心在转。


结果集大小如何拽着内存走
一次查询从发起到返回结果,内存消耗并不是平均分布的,真正推高内存峰值的环节,集中在以下几个地方:
- 排序与聚合操作:数据库需要把中间结果放到内存里做排序或者分组,结果集越大,排序缓冲区越大,内存占用线性上涨
- Join操作的构建侧:无论是Hash Join还是Merge Join,构建侧的数据都要完整放进内存,右表再大,也要等左表构建完才能开始匹配
- 子查询和CTE的物化:查询里每写一个WITH子句,数据库就可能把中间结果物化成一份临时数据集,这份数据没跑完之前,不会被释放
- 结果集返回前的最终落地:客户端要拿的最终结果集,在发送之前必须完整存放在内存或临时文件中,几十万行数据的返回,瞬间能吃掉数GB内存
那些“你以为省内存其实吃内存”的操作
常见问题出在习惯性写法和查询模板上,以下三类操作对内存的消耗远超想象:
- SELECT 不加限制:把整张宽表所有列全部拉出来,每一行多出来的字段都在撑大结果集,内存和网络传输成本同步上升
- 大偏移量分页:用LIMIT 100000, 20做深分页时,数据库需要把前十万行先排序再丢弃,这十万行的中间结果始终占着内存
- 多层嵌套子查询:每一层子查询都可能触发一次完整的结果集物化,三层嵌套意味着三份完整结果集同时在内存里存在
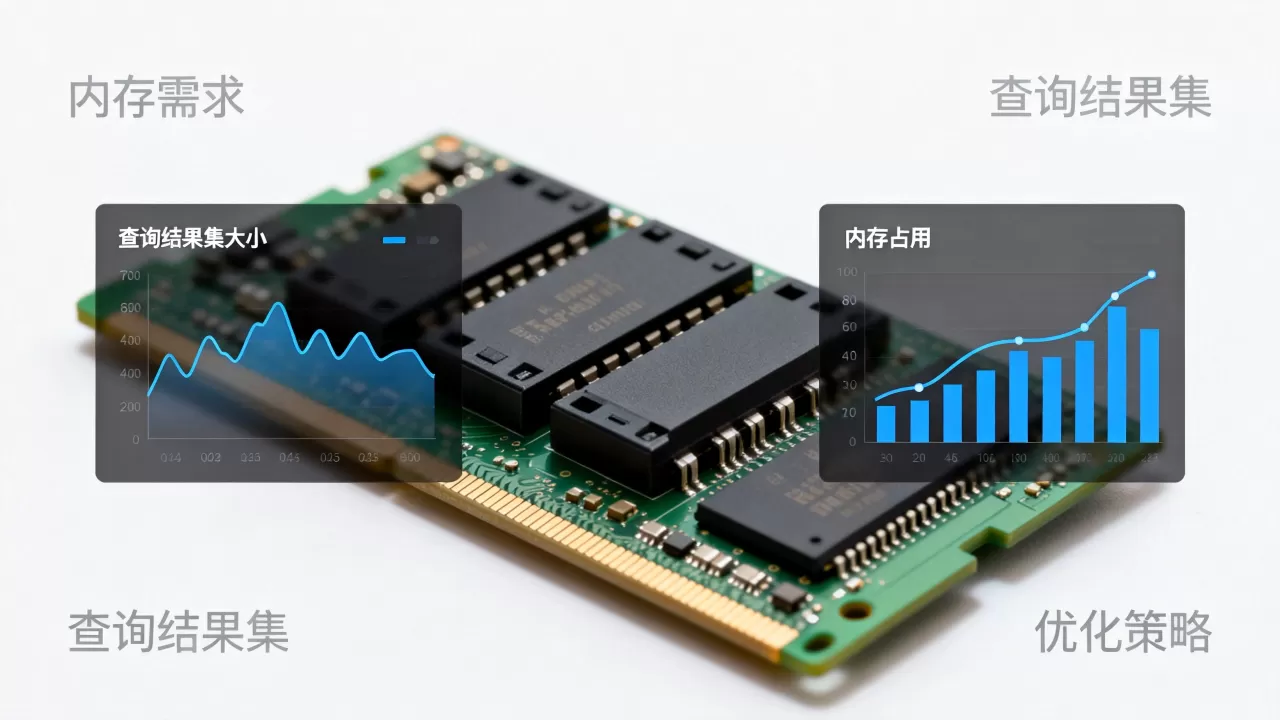
业内专家指出,多数在线分析系统的内存溢出问题,追根溯源都是“结果集膨胀”而非“底层存储过大”,数据量本身是静态的,结果集才是动态的罪魁祸首。
在线分析内存优化的三个实操层级
知道了内存波动和结果集的关系,优化就有章可循,从查询写法、参数调整、架构设计三层入手,能把内存占用压下来一半以上。
查询侧:给结果集“做减法”
最直接的优化是缩小结果集本身,假设一张订单表有两亿行,数据量摆在那里动不了,但一次查询到底返回多少行、多少列,完全由你的SQL说了算。
- 只查需要的列:把SELECT 改成显式列出字段名,窄表结果集对内存的友好程度远超预期
- 加合理的过滤条件:用时间分区、业务ID做裁剪,让引擎只扫描必要的分片
- 聚合而非明细:后台列表和看板场景,用GROUP BY把明细汇总成指标,结果集能从百万行降到几十行
- 避免深分页:用游标或者基于ID的翻页方式替代偏移量分页,能大幅减少排序缓冲区的压力
参数侧:给内存加上“护栏”
查询写得再规范,也挡不住用户随手敲的探索式分析,这时候需要从参数层面限制单条查询能用的内存上限,以目前主流的分析引擎为例:
- ClickHouse:通过
max_memory_usage参数控制单条查询的内存上限,建议设置为物理内存的50%到70%,超出后查询直接报错而不是拖垮整个节点 - Apache Doris:
exec_mem_limit参数限制单查询的算子内存使用,默认2GB,按结果集实际大小调整到4GB或8GB比较合理 - StarRocks:
query_mem_limit配合session_variables可以按会话粒度控制内存,比全局限制更灵活
很多DBA不想限制内存,怕查询跑不出来,设置明确的上限就像给洪水建了堤坝,冲垮的概率反而更低,一次查询内存超限,至少还能保住其他正在跑的查询。
架构侧:让结果集“复用”而不是“重建”
同一份结果集,每次查询都重新计算一遍,内存就被反复拉扯,架构层的优化思路,是把高频查询的结果集“缓存”起来。
- 物化视图:把常用的聚合结果预先计算并存储,查询直接读物化后的结果,内存只承担返回数据的那一小部分开销
- 结果集缓存:很多OLAP引擎自带查询缓存,相同的SQL在数据未变更时直接返回缓存结果,内存占用接近于零
- 预聚合层:在数据写入时做一层rollup,把核心指标提前计算好,日常90%以上的查询都不需要触碰明细数据
行业共识认为,三层优化叠加的效果通常在70%以上的查询上显著降低内存峰值,尤其对高频低延迟场景,架构层的收益远大于查询改写。
场景实录:一场电商报表分析的内存“过山车”
以深圳某跨境电商公司为例,他们用ClickHouse做在线数据分析平台,日常跑广告投放效果报表,早期的现象是:早高峰时段,只要运营同时打开七八个看板页面,ClickHouse节点内存就以肉眼可见的速度飙升,最多的时候一个节点被吃掉近40GB内存,OOM(OutOfMemory)几乎隔天就来一次。
排查后发现三个典型问题:
| 问题 | 表现 | 根因 |
|---|---|---|
| 看板SQL未加时间范围 | 一次拉取全年数据 | 结果集接近完整事实表 |
| 多表JOIN无过滤条件 | 关联扫描全量维度表 | Join构建侧过大 |
| 大促期间ad-hoc查询泛滥 | 分析师临时跑深分页统计 | 深分页导致排序缓冲区膨胀 |
改动方式很朴素:每个看板SQL统一封装时间控件,强制带上最近30天分区;Join前先聚合再关联;分析师入口的深分页查询全部替换为异步导出任务,三处调整后,同样早高峰场景下内存峰值降到了约12GB,OOM不再出现。结果集大小直接决定了内存水位,这句话在他们这儿成了座右铭。
在线分析内存配置的几个常见疑问
根据不同阶段使用者的反馈,内存相关的问题集中在以下几条,这里一并回答。
在线分析的内存配置是不是越大越好?
不是。内存配置的上限应该基于“最大合理结果集”来定,而不是物理机有多少内存就分给查询多少,内存配太大,单条查询会把系统资源吃干,其他查询全部排队,整体响应速度反而更差,合理的做法是:先统计历史查询的最大结果集行数和列数,估算出结果集大小,再乘以2到3倍的余量,作为单查询的内存上限,剩余内存留给系统缓存和并发查询。
ad-hoc查询的结果集不好预估,怎么控制内存?
ad-hoc查询是最难防的内存杀手,因为没人能预见用户会写什么SQL,控制思路是“粗粒度限额加白名单”:默认限制查询内存上限不超过物理内存的30%,给分析师账号单独配置更高的额度,但要求在SQL里强制带上分区过滤条件,再配合慢查询日志做回溯,定期把高频ad-hoc查询固化成报表,逐步收窄不可控的探索式分析范围。
离线任务和在线分析共用同一个集群时,内存怎么隔离?
这种情况建议直接拆分,不要让两种负载混跑在同一批节点上,离线任务的典型特征是占用大量磁盘IO和CPU做全量扫描,在线分析要求低延迟响应,两者混跑必然互相挤占资源。如果短期内无法物理拆集群,就用资源组或队列做软隔离,给在线分析划定独立的内存池和CPU配额,保证业务高峰期不会被离线任务冲垮,隔离的颗粒度越细,结果集波动对彼此的干扰就越小。
在线分析的内存管理,说到底就是和结果集赛跑,理解了内存需求随结果集波动的内在规律,再通过查询裁剪、参数限制、架构复用三层手段去控制它,数据平台就不会再被内存问题拖住后腿,判断一个OLAP系统是否健康,先去看它的结果集和内存配比是否匹配,比盲目扩容更有意义。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/638072.html