大规模集群里节点故障不是偶发意外,而是日常运行的一部分,容错冗余必须从一开始就设计进去,而不是等故障来了再补救。
为什么大规模集群节点故障是常态
数据中心里几千台甚至上万台服务器同时工作,硬盘、内存、网卡、电源、主板都在持续消耗,单台服务器年故障率听起来不高,但把基数放大到一万台,几乎每个月甚至每周都会遇到硬件报修。
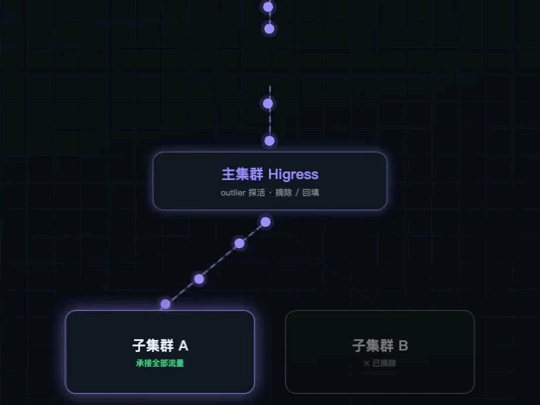

- 机械硬盘的磨损比固态硬盘更明显,坏道和读写超时经常出现
- 内存错误不一定让机器立刻宕机,但会造成计算结果随机偏差
- 网卡降速、交换机端口抖动会带来间歇性网络超时
- 电源和风扇老化后,机房温度波动会触发保护性关机
业内专家指出,节点故障应当被当作系统设计的基础假设,而不是极端场景,行业共识也认为,运维团队如果还在追求“零故障”,往往会忽视更重要的目标:故障发生时业务能不能继续跑。
大规模集群如何设计容错冗余
从单节点容错到机房级冗余都要考虑
容错不是买几台备用机器那么简单,不同层级需要不同策略。
| 层级 | 常见故障 | 容错思路 |
|---|---|---|
| 磁盘 | 坏道、读写失败 | 多副本、纠删码 |
| 节点 | 宕机、硬件损坏 | 任务重调度、心跳剔除 |
| 机架 | 交换机故障、断电 | 副本跨机架分布 |
| 机房 | 网络出口中断、电力故障 | 多机房流量切换 |
先保证单节点故障不影响数据安全,再保证机架级故障不中断服务,最后才考虑机房级容灾,顺序不能反,否则容易把预算花在低概率场景上。
副本和纠删码怎么选
小文件多副本更直接,三个副本分布在三个机架,任意一个节点或机架出问题,数据还能读能写,大文件用纠删码可以省存储空间,常见配比如EC 4+2、EC 8+3,通过计算冗余块来恢复丢失的数据。
- 在线业务优先用三副本,读取延迟低
- 冷数据备份优先用纠删码,存储成本低
- 混合场景按访问频率分层存储
故障检测要快,不能等用户投诉
节点故障后,如果靠人工巡检发现,中间可能已经过去几小时,自动健康检查必须覆盖三个维度:
- 心跳检测判断节点是否存活
- 磁盘SMART信息提前预警硬件劣化
- 任务执行超时判断节点是否变慢
主流集群调度系统都会在节点失联后自动把任务迁移到健康节点,迁移速度影响业务恢复时间,所以心跳间隔和超时阈值要结合业务容忍度调优。
常见故障场景及处理思路
磁盘故障的处理路径
磁盘是集群里故障率最高的部件之一,遇到读写错误,先不要立刻拔盘,按顺序处理:
- 确认副本健康状态,保证数据没有丢失
- 将故障磁盘标记为只读或下线
- 触发数据重建,把副本补到其他磁盘
- 更换硬件后重新加入集群
数据重建会占用网络和磁盘IO,如果一次坏盘太多,重建流量可能把正常业务拖慢,运维上要控制同时重建的并发数量。
节点宕机的自动恢复
节点突然断电或内核崩溃,调度器通常会在几十秒内发现,对于无状态服务,直接在其他节点拉起新的实例即可,对于有状态服务,需要先确认数据副本完整,再切换主从角色。
实际操作中,可以用以下命令查看节点状态:
kubectl get nodes
kubectl describe node <node-name>
主流容器平台会标记节点为NotReady,并按照Pod的调度策略进行驱逐和重建,关键点在于:节点的Pod是否配置了反亲和性,避免所有副本落在同一个机架。
网络抖动的判断和处理
网络抖动比彻底断网更难排查,表现为请求时快时慢、偶发超时、丢包率升高,处理时要先区分是单节点问题还是整个机架问题:
- 单节点网卡异常:查看网卡错误计数、协商速率
- 机架交换机异常:对比同机架其他节点的网络指标
- 上层汇聚异常:影响范围更大,通常伴随告警
网络层容错主要靠多路径和重试,业务客户端要设置合理的超时时间和重试上限,避免在抖动期间放大流量。
集群容错设计中的成本与可靠性平衡
冗余等级与成本的关系
多一份冗余就多一份成本,三副本的存储成本是单副本的三倍,但可靠性提升明显,两地三中心比单机房贵很多,但能扛住机房级故障。
- 核心业务:三副本起步,跨机架分布
- 一般业务:两副本加定期快照
- 归档数据:纠删码加离线备份
大规模集群节点故障是常态怎么设计容错冗余,往往不是要无限提高冗余,而是根据业务分级决定投入,把所有业务都做到最高等级,成本会高到不现实。
提前预留故障域容量
集群容量规划要留出故障域缓冲,比如一个100台节点的集群,日常水位控制在70%左右,剩下的30%用来承接故障迁移,如果日常水位已经跑到95%,坏两台节点就会引发资源挤兑。
- 计算资源预留:保证节点故障后任务有地方跑
- 存储资源预留:保证数据重建有空间写
- 网络带宽预留:保证迁移和重建流量不拥塞
实操层面的几个关键命令与配置
检查集群健康状态
以常见的Kubernetes集群为例,日常巡检可以关注以下命令:
kubectl get nodes -o wide
kubectl top nodes
kubectl describe pod <pod-name> | grep -A 5 Events
节点层面还可以查看内核日志中的硬件错误:
dmesg | grep -i error
journalctl -k | grep -i mce
配置反亲和性避免副本集中
在Pod或Deployment配置中,可以设置podAntiAffinity,让同一个服务的多个副本分布到不同节点,示例片段:
affinity:
  podAntiAffinity:
    requiredDuringSchedulingIgnoredDuringExecution:
    - labelSelector:
        matchExpressions:
        - key: app
          operator: In
          values:
          - nginx
      topologyKey: kubernetes.io/hostname
这个配置只保证同一主机不出现两个相同副本,如果要跨机架容错,可以把topologyKey改成机架标签。
设置优雅下线减少故障影响
节点维护或下线前,要先执行drain操作,把Pod平滑迁移到其他节点:
kubectl drain <node-name> --ignore-daemonsets --delete-emptydir-data这一步会触发Pod的终止通知,让应用有时间处理完当前请求再退出,直接关机或重启节点,可能造成请求中断和数据写入丢失。
磁盘故障后的数据重建监控
使用分布式存储时,磁盘故障会触发数据重建,可以通过存储系统的命令行查看重建进度,例如Ceph集群中可以使用:
ceph status
ceph osd tree
重点关注recovery状态和慢请求数量,如果重建导致业务延迟明显上升,需要调整恢复优先级参数。
集群容错冗余的常见误区
只做数据冗余,不做计算冗余
数据存了三份,但计算节点没有预留资源,节点故障后,数据虽然完好,新的计算实例却无法调度,服务照样不可用,计算冗余和存储冗余要同时规划。
监控告警只看节点活着不活着
节点能ping通不代表健康,磁盘慢、内存软错误、时钟漂移都可能让节点“活着但不好用”,监控指标要覆盖延迟、错误率、磁盘队列深度等维度。
故障演练只停留在纸面
没有验证过的容错方案都是假设,定期做混沌工程或故障演练,比如随机杀掉一个节点、拔掉一块磁盘、切断一个机架的网络,看看系统是否按预期恢复,实际演练中暴露的问题,比文档里写十页都有价值。
节点故障不是运维团队的敌人,而是设计者必须接受的前提,把故障当常态,才能在架构、容量、监控、演练每一个环节都留好退路,容错冗余的核心不是堆硬件,而是让系统在部分组件失效时,仍然能保持可用的服务能力。
大规模集群节点故障常见问题
大规模集群节点故障如何设计容错冗余方案
先从故障域划分开始,至少覆盖磁盘、节点、机架、机房四层,数据层用多副本或纠删码,计算层预留迁移容量,网络层配置多路径和自动重试,调度器要能自动发现失联节点并重新分配任务,容量水位控制在合理范围,避免故障后资源挤兑。
节点故障是常态的情况下,三副本和纠删码哪个更适合
在线业务对延迟敏感,三副本读取路径短,故障恢复简单,适合核心服务,冷数据和日志备份访问频率低,纠删码在相同可靠性下可以节省较多存储空间,适合归档类数据,实际生产环境多数会采用分层策略,热数据三副本,冷数据纠删码。
如何判断集群容错冗余是否真的有效
不能只看配置,要实际验证,定期执行故障演练,随机重启节点、拔掉磁盘、断开交换机,观察监控指标变化和业务恢复时间,如果每次演练都能在预期时间内自动恢复,容错设计才算落地,否则需要继续调整心跳超时、重建并发、资源预留等参数。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/638068.html