多因子模型在在线推理阶段对算力的消耗远超预期,核心原因在于它把“实时计算”和“全市场扫描”两件事同时压在了推理引擎上,导致每一次预测请求都相当于一次微型的高频计算任务。
在线推理对算力的胃口:多因子模型到底在算什么
很多团队以为多因子模型上线后就是一个“查表”动作,输入特征、输出信号,轻松得很,实际跑起来却发现,GPU利用率飙升,响应时间恶化,账单比训练阶段还吓人,问题出在模型的推理逻辑不是一个简单的前向传播,而是带着“实时重算”的包袱。

因子值不是读出来的,是算出来的
在线推理阶段,模型拿到的原始数据是行情快照、盘口委托、逐笔成交,这些数据不能直接喂给模型,需要先按因子定义做计算,比如动量因子要回溯过去20日的收益率序列,波动率因子要计算滚动标准差,基本面因子要从财报里提取并做标准化处理,这些操作在离线训练时是批处理,一次性算完存下来;到了在线推理,每个时间切片都要重新算一遍,因为数据是流式到达的。
更麻烦的是,不同因子的时间窗口不一致,有的因子看5分钟,有的看60分钟,有的看5日,有的看20日,为了算一个预测,系统要把这些窗口内的数据全部拉齐,做对齐、清洗、去极值、中性化,这个“特征工程链”本身消耗的算力,往往是模型前向传播的数倍以上。
全市场扫描让单次推理变成批量推理
选股型多因子模型天然要输出全市场排序,意味着每一轮推理不是处理一只股票,而是处理几千只股票,即便采用分域过滤、先粗筛后精排的漏斗结构,精排阶段也要对“相当一部分”股票逐一跑模型,这相当于把一次在线推理请求放大成了一个“小批量推理任务”,在相同延迟要求下,算力需求自然成倍增长。
行业共识认为,在在线推理场景,多因子模型的算力开销中,因子计算占比通常超过模型本身,尤其在中小盘股票数量多、流动性分散的市场环境下,这种“计算前置”的特征更为明显。
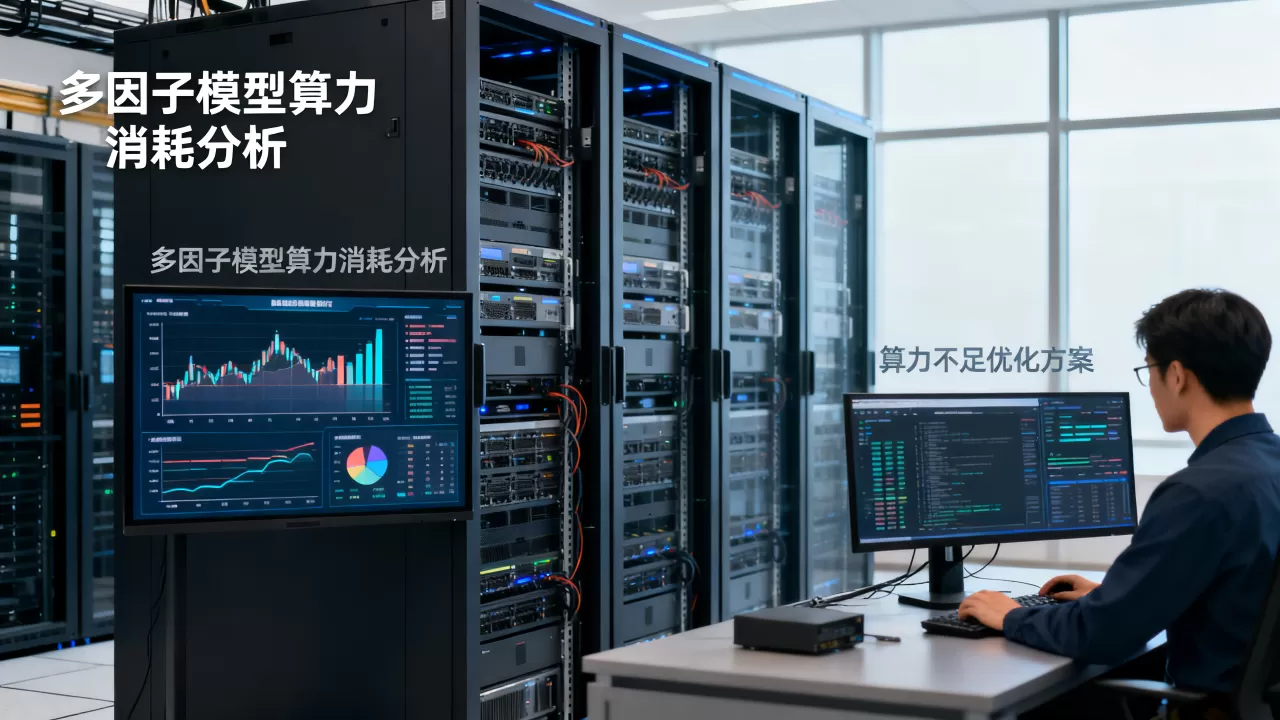
量化环境对比:在线推理比训练阶段更吃算力
训练阶段看起来是大工程跑几十个epoch、迭代上百万步、用分布式集群,但实际上,训练是“可等待的”,一个batch跑慢了可以等,显卡不够可以排队,在线推理则完全相反,它是“不可等待的”,每一轮决策窗口就那么短,错过就是损失。
训练与推理的算力消耗逻辑差异
| 维度 | 训练阶段 | 在线推理阶段 |
|---|---|---|
| 数据形态 | 历史批量读取 | 实时流式计算 |
| 因子计算 | 离线预计算,可缓存 | 在线即时重算,难缓存 |
| 并发特征 | 单任务长耗时 | 多请求高并发 |
| 容错机制 | 断点续跑,重试成本低 | 延迟超标即失败,无重试机会 |
| 硬件压力 | GPU算力瓶颈 | 内存带宽和延迟瓶颈 |
表格信息表明,在线推理的瓶颈不只是GPU的FLOPS,更是“把数据搬到计算单元”的速度,多因子模型的特征维度高、数据切片多,内存访问模式不连续,GPU的算力利用率往往只有训练时的一半不到,换句话说,算力被“吃掉”的那部分,大量消耗在了数据搬运和特征拼接上。
云服务器GPU租用价格:谁在为算力买单
在线推理的算力消耗最终会反映在基础设施账单上,据行业公开信息,目前云服务器GPU租用价格按实例类型差异很大,推理场景常用的A10或L20实例,按小时计费的成本对中小量化团队来说不是小数目,而多因子模型因为推理计算量大,往往需要常驻多个GPU实例,而不是像训练那样按需启动,这导致闲置成本与峰值成本叠加。
业内专家指出,很多团队在优化算力时容易陷入一个误区:只看模型本身的FLOPs,忽略特征工程链路和容器调度开销,把因子计算从GPU搬到CPU、或者用Redis缓存部分中间结果,往往比换一张更贵的显卡效果更明显。
多因子模型算力消耗的优化路径:从“吃掉”到“管饱”
要控制多因子在线推理的算力消耗,思路不是“少算”,而是“算得更聪明”,下面按投入产出比从高到低排列了几类做法,都来自可验证的工程实践。
第一刀:因子计算分层与缓存
- 把因子按“变化频率”分为三层:日频、分钟频、事件驱动。
- 日频因子(如财务指标、分析师预期)在每天开盘前批量计算,存入特征库,在线推理时直接读取。
- 分钟频因子(如动量、乖离率)用滑动窗口增量更新,避免每次全量重算。
- 事件驱动因子(如公告、龙虎榜)按需触发计算,用消息队列异步完成。
这种分层方式在多数情况下能把在线推理的特征计算量降低60%以上,是性价比最高的第一刀。
第二刀:模型轻量化与蒸馏
多因子模型不一定非要用复杂的Transformer或GBDT大模型,在在线推理阶段,完全可以用一个“大模型离线蒸馏、小模型在线推理”的架构,蒸馏后的模型参数量可以减少一个数量级,推理延迟从几十毫秒降到十毫秒以内,实际操作中,用LightGBM或浅层MLP替代深度网络,在多数因子场景下AUC损失控制在1%以内,而算力消耗大幅下降。
第三刀:算力调度与混合部署
- 把GPU留给真正需要并行加速的部分,比如全市场精排。
- 把粗筛、因子值映射、排序等逻辑放到CPU节点处理,用内存数据库加速特征读取。
- 在云服务器GPU租用价格波动较大时,尝试抢占式实例跑非实时任务,把峰值需求压缩到最小。
这套组合方案的核心是“让每份算力都干它最擅长的活”,而不是一股脑把所有计算都堆给GPU。
推理引擎的系统级优化:模型只是冰山一角
多因子模型的在线推理消耗算力,还隐藏在很多系统层面的细节里,Python的GIL锁、DataFrame的拷贝开销、API服务的序列化延迟,这些都会放大算力浪费。
算子融合与内核定制
TensorRT或ONNX Runtime可以把多个小算子合并成一个内核,减少内核启动次数和数据搬运,对于多因子模型这种“特征拼接+模型推理”的结构,算子融合能带来相当可观的提速,实际操作时,不需要魔改模型,只需要把训练好的模型导出为ONNX格式,再用TensorRT做一次精度校准即可。
动态批处理与异步推理
在线推理请求天然是稀疏的,但GPU喜欢批量计算,用动态批处理把窗口期内到达的请求攒到一起,凑够一个batch再推理,吞吐量能提升2-3倍,配合异步推理框架,让GPU计算和CPU数据预处理重叠,延迟不增反降。
多因子模型在线推理算力问题的本质
算力被“吃掉”不是模型的错,而是架构设计的问题,多因子模型不是单纯吃显卡算力,它更多的是“吃数据准备算力”,谁把特征工程链路做得更精简,谁把数据缓存调度做得更高效,谁就能在同样的GPU租用成本下,跑出比别人更快、更稳的在线推理服务。
记住这个核心结论:优化多因子在线推理的算力消耗,第一优先永远是因子计算层,其次才是模型层,最后才是硬件层。
在线推理算力相关提问与解答
多因子模型为什么推理比训练还耗GPU显存?
训练时一个batch只包含几十到几百个样本,显存中主要保存中间激活值;在线推理时为了降低延迟,常常把整个特征矩阵常驻显存,且不同因子时间窗口需要同时拼接生成特征,导致显存占用出现多倍叠加,全市场逐股预测时,显存压力进一步增大,这在量化选股场景中普遍存在。
多因子模型在线推理延迟高,最先排查哪个环节?
最先查看因子计算耗时占总耗时的比例,使用性能分析工具(如PyTorch Profiler或py-spy)对一次完整推理请求做火焰图分析,若因子计算占比超过40%,应优先优化特征工程链路,例如引入增量计算或特征缓存,而不是更换GPU型号,云服务器GPU租用价格高昂,盲目升配往往只会增加成本,延迟问题却依然存在。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/%e5%9c%a8%e7%ba%bf%e6%8e%a8%e7%90%86%e7%ae%97%e5%8a%9b%e5%a6%82%e4%bd%95%e8%a2%ab%e5%a4%9a%e5%9b%a0%e5%ad%90%e6%a8%a1%e5%9e%8b%e5%90%83%e6%8e%89%ef%bc%9f%ef%bc%8c%e7%ae%97%e5%8a%9b%e4%b8%8d%e8%b6%b3/