大模型为什么会答错?从业者揭秘背后真相

大模型“一本正经胡说八道”的现象,本质上并非单纯的“故障”,而是基于概率预测的技术原理与人类对“真理”的绝对追求之间存在天然鸿沟。核心结论是:大模型的错误是其生成机制决定的必然,而非偶然的Bug,解决之道在于构建“人机协同”的防御体系,而非单纯期待模型自我进化。作为行业从业者,关于大模型答错的问题,从业者说出大实话,这背后既有技术架构的局限,也有数据治理的难题,更有应用层面的认知偏差。

关于大模型答错的问题

技术原理层面:概率预测不等于逻辑推理

大模型之所以会犯错,首先要从其“大脑”构造说起,目前的通用大模型,其底层逻辑是“下一个词预测”,而非严谨的逻辑推演。

  1. 概率生成的必然随机性: 模型在生成内容时,是在巨大的词库中寻找概率最高的词语组合。这种机制决定了模型擅长“编造”通顺的句子,却不擅长验证事实的真伪。 当模型遇到知识盲区,为了满足“生成”的指令,它会基于概率拼接看似合理实则错误的信息,这就是著名的“幻觉”现象。
  2. 知识压缩的有损性: 大模型将海量互联网数据压缩在参数中,这个过程类似于将有损压缩的图片还原。细节的丢失和语义的模糊,导致模型在面对精细问题时,往往只能给出一个“大概齐”的答案,而非精确解。
  3. 对齐税与能力阉割: 为了让模型安全、合规,厂商会对模型进行RLHF(人类反馈强化学习)训练,这个过程虽然降低了有害内容的输出,但也可能导致模型在某些专业领域的知识被“阉割”或产生过度拒答,间接增加了答错或答非所问的概率。

数据治理层面:垃圾进,垃圾出

模型的表现上限由训练数据决定,从业者深知,即便模型架构再完美,低质量的数据也会导致灾难性的后果。

  1. 训练数据的时效性滞后: 大模型的知识截止日期是其硬伤。模型无法预知训练截止日期之后发生的事情, 如果用户询问最新的新闻或技术,模型只能基于旧知识进行推断,极易产生事实性错误。
  2. 互联网数据的噪声污染: 训练数据主要来源于公开互联网,其中充斥着偏见、谣言和低质内容。模型不具备分辨真伪的能力,它会平等地学习正确知识和网络谣言。 当用户提问时,模型可能复述了训练集中的错误信息。
  3. 专业领域数据的稀缺: 通用模型在金融、医疗、法律等垂直领域表现不佳,核心原因是高质量的专业数据往往封闭在机构内部,未进入训练集。缺乏专业数据的支撑,模型在专业领域的回答往往流于表面,甚至出现原则性错误。

应用落地层面:用户期待与能力的错位

关于大模型答错的问题

很多时候,模型答错并非模型“蠢”,而是用户用错了方法。

  1. 提示词工程的缺失: 同一个问题,不同的问法会得到截然不同的答案。用户往往期望模型像真人一样“懂我”,使用模糊、隐晦的指令,导致模型理解偏差。 简单问“写个方案”,模型可能输出泛泛而谈的内容;若加上角色设定、背景约束,效果会大幅提升。
  2. 过度依赖单次对话: 大模型具有强大的上下文学习能力,但很多用户习惯“一问一答”就结束。通过多轮对话纠正模型的错误,引导其逐步逼近真相,才是正确的使用姿势。 拒绝迭代修正,就等于放弃了模型自我纠错的机会。
  3. 盲目信任与缺乏验证: 许多用户将大模型视为搜索引擎的替代品,盲目采信其输出的数据。从业者的大实话是:大模型更像是“副驾驶”,而非“驾驶员”。 在关键决策上,必须引入人工审核机制,尤其是在代码生成、医疗建议等高风险场景。

解决方案:构建可信的AI应用闭环

面对大模型答错的问题,我们不能因噎废食,而应建立系统性的解决方案。

  1. 引入RAG(检索增强生成)技术: 这是目前解决幻觉问题最有效的手段。通过外挂知识库,让模型在回答前先检索相关事实,再基于事实生成答案。 这不仅解决了知识时效性问题,还大幅降低了胡说八道的概率,让回答有据可查。
  2. 建立人机协同(HITL)机制: 在关键业务流程中,必须保留人工审核环节。模型负责生成初稿或提供选项,人类负责最终把关。 这种模式既利用了AI的效率,又规避了其准确性风险。
  3. 优化提示词策略: 企业和个人用户都应掌握基本的提示词技巧。通过“思维链”引导模型展示推理过程,或要求模型“如果不知道请回答不知道”, 可以有效抑制模型的幻觉倾向,迫使其在不确定时保持诚实。
  4. 微调垂直领域模型: 针对特定行业,不应直接使用通用大模型。利用行业私有数据对模型进行微调,注入专业知识, 能够显著提升模型在特定场景下的准确率和专业度。

相关问答

为什么大模型有时候会非常自信地给出错误答案?

关于大模型答错的问题

这主要源于模型训练中的“过度自信”问题,在训练过程中,模型倾向于最大化预测概率,即便是在它不确定的情况下。由于缺乏对“不确定性”的显式建模,模型无法像人类一样表达“我猜”或“可能”。 训练数据中可能存在错误但表述流畅的内容,模型学习后便会产生自信的错误输出,解决这一问题需要引入不确定性量化技术,或在训练数据中增加更多反例和纠错数据。

大模型的“幻觉”问题未来能被彻底解决吗?

彻底解决“幻觉”在目前的技术路径下极难实现,因为生成式AI的本质就是创造而非检索。但随着RAG技术、事实核查模块以及更先进的推理架构的应用,幻觉的比例可以被控制在极低水平。 未来的大模型可能不再是单一的生成器,而是集成了检索、计算、逻辑验证的智能体系统,从而在实用层面“消除”幻觉的影响。

您在使用大模型的过程中遇到过哪些离谱的错误?欢迎在评论区分享您的经历和看法。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://idctop.com/article/119169.html

赞 (0)
安装公司管理软件哪个好?管理软件中心推荐高效工具
上一篇 2026年3月23日 19:55
大模型写综述框架难吗?大模型综述怎么写
下一篇 2026年3月23日 19:56

相关推荐

  • 国外cdn亚洲节点延迟高,国外cdn亚洲节点哪个好用

    2026年访问国外CDN亚洲节点,首选Cloudflare、AWS CloudFront或阿里云国际版,其中Cloudflare在东南亚延迟表现最优,AWS在北美至亚洲链路稳定性最高,具体选择需依据业务目标用户的地域分布及合规需求,海外CDN亚洲节点布局现状与核心优势随着全球化业务的深入,跨国数据传输的延迟与稳……

    2026年7月5日
    12310
  • 构建湖仓一体数据仓库打折,湖仓一体数据仓库打折吗

    构建湖仓一体数据仓库并非简单的技术堆砌,而是通过统一存储与计算分离架构,解决传统数仓扩展性差与数据湖数据质量低的双重痛点,目前主流云厂商提供的折扣方案通常能降低30%-50%的综合IT成本,在2026年的企业数字化转型深水区,数据架构的演进已经从“有没有”转向“好不好用”和“贵不贵”,过去,企业往往需要在关系型……

    2026年5月24日
    4700
  • 机械设计大模型怎么样?机械设计大模型好用吗?

    机械设计大模型作为工业软件领域的革新力量,其核心价值在于显著提升了设计效率与创新能力,但目前的成熟度仍处于“可用但需打磨”的阶段,消费者评价呈现出“效率提升明显,但专业深度不足”的两极分化特征,对于追求标准化、快速出图的企业而言,它是降本增效的利器;而对于涉及复杂工况、非标设计的场景,它目前更多扮演辅助角色,核……

    2026年3月20日
    11500
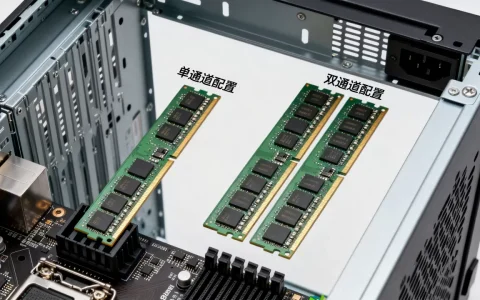
  • 服务器单通道性能到底怎么样,值得升级双通道吗?

    服务器单通道是指内存仅通过一条64位数据通道与CPU控制器通信,读写带宽天然减半,对性能敏感型业务会产生明显瓶颈,下面咱们把单通道的来龙去脉、适用场景、升级路径一次说清楚,服务器单通道和双通道的区别到底在哪内存通道是CPU访问内存的物理路径,说白了就是一条“数据马路”,单通道只有一条路,数据得排队走;双通道是两……

    2026年8月8日
    1600
  • olama大模型本地部署难吗?从业者说出大实话

    Ollama大模型本地部署并非简单的“一键安装”游戏,其实质是在硬件瓶颈、模型量化与实际业务需求之间寻找平衡点,对于绝大多数个人开发者和中小企业而言,盲目追求大参数模型本地化是严重的资源浪费,选对模型、选对量化策略,才是本地部署成功的关键, 硬件门槛的“大实话”:显存是绝对的王道很多教程避重就轻,只谈软件安装……

    2026年3月28日
    12600
  • cdn推流是什么意思,cdn推流技术怎么配置和使用

    CDN推流是2026年直播与视频分发的基础设施,通过边缘节点实现低延迟、高并发的流媒体传输,是保证用户体验的关键技术,理解CDN推流:从技术原理到行业价值什么是CDN推流CDN推流指将视频源站内容通过内容分发网络推送到边缘节点,再由节点就近分发给终端用户,与传统的源站直推相比,CDN推流利用分布式服务器集群,有……

    2026年7月19日
    2300
  • cdn部署实现,cdn部署实现步骤

    CDN部署的核心在于通过边缘节点缓存静态资源并智能调度流量,实现毫秒级响应与高可用性,建议根据业务场景选择“自建+公有云混合”或“全托管”方案,2026年主流趋势是结合AI预测的动态路由优化,CDN部署的核心逻辑与技术架构分发网络(CDN)并非简单的服务器集群,而是基于“就近接入、边缘计算”理念的基础设施,在2……

    2026年6月5日
    9700
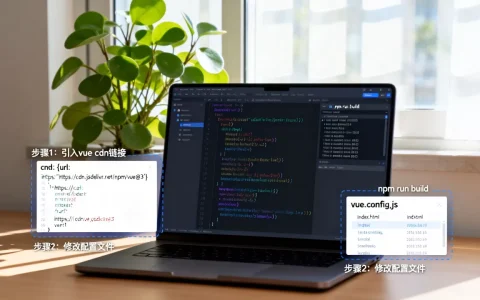
  • vue项目使用cdn怎么配置?vue引入cdn加速优化

    Vue项目使用CDN的核心优势在于显著减少首屏加载时间并降低服务器带宽成本,通过外部资源托管实现前后端分离部署,是提升用户体验的高性价比方案,在大型Web应用开发中,构建产物体积膨胀是普遍痛点,当你的Vue项目包含大量第三方库时,本地打包不仅耗时,还会导致主包体积过大,将Vue核心库及常用插件通过CDN引入,能……

    2026年6月13日
    2400
  • 服务器在香港的网站,为何访问速度不稳定?

    是的,存在大量将服务器部署在中国香港的网站,这种选择是众多企业、组织乃至个人网站运营者出于特定业务需求、法规考量、性能优化或战略布局而做出的常见决策,香港作为亚太地区重要的信息枢纽,其独特地位使其成为服务器托管的理想地点之一,为什么选择将服务器放在中国香港?选择香港作为服务器所在地,并非偶然,而是基于其一系列显……

    2026年2月5日
    17430
  • 边缘节点磁盘IO会限制时序写入吞吐吗,如何提升性能?

    边缘节点时序写入的吞吐瓶颈,多数情况不在CPU或网络带宽,而是磁盘IO;解决顺序是先改写入策略,再谈换硬件,顺序反了容易白花钱,边缘节点磁盘IO限制时序写入吞吐怎么办——先看三点定位瓶颈时序数据写入有个特点:高频、小包、持续不断,边缘节点的设备每几秒上报一次数据,单次可能只有几十字节,但对磁盘来说每次都是一次真……

    2026年10月8日
    100

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注