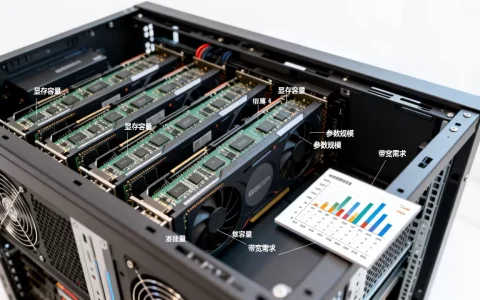
大模型分布式训练中的张量并行(Tensor Parallelism)通过将单个层的计算切分到多张显卡上,显著降低了显存占用并提升了推理与训练吞吐量,是目前突破单卡显存瓶颈的核心技术路径。
随着大语言模型参数规模突破千亿甚至万亿大关,单机单卡的显存容量已无法容纳完整的模型权重,传统的模型并行或数据并行策略在面对超大规模模型时显得力不从心,张量并行作为一种细粒度的并行策略,成为了解决这一痛点的关键方案,业内专家指出,合理配置张量并行可以使得模型在有限的硬件资源下实现线性加速,这对于追求极致效率的企业级应用至关重要。
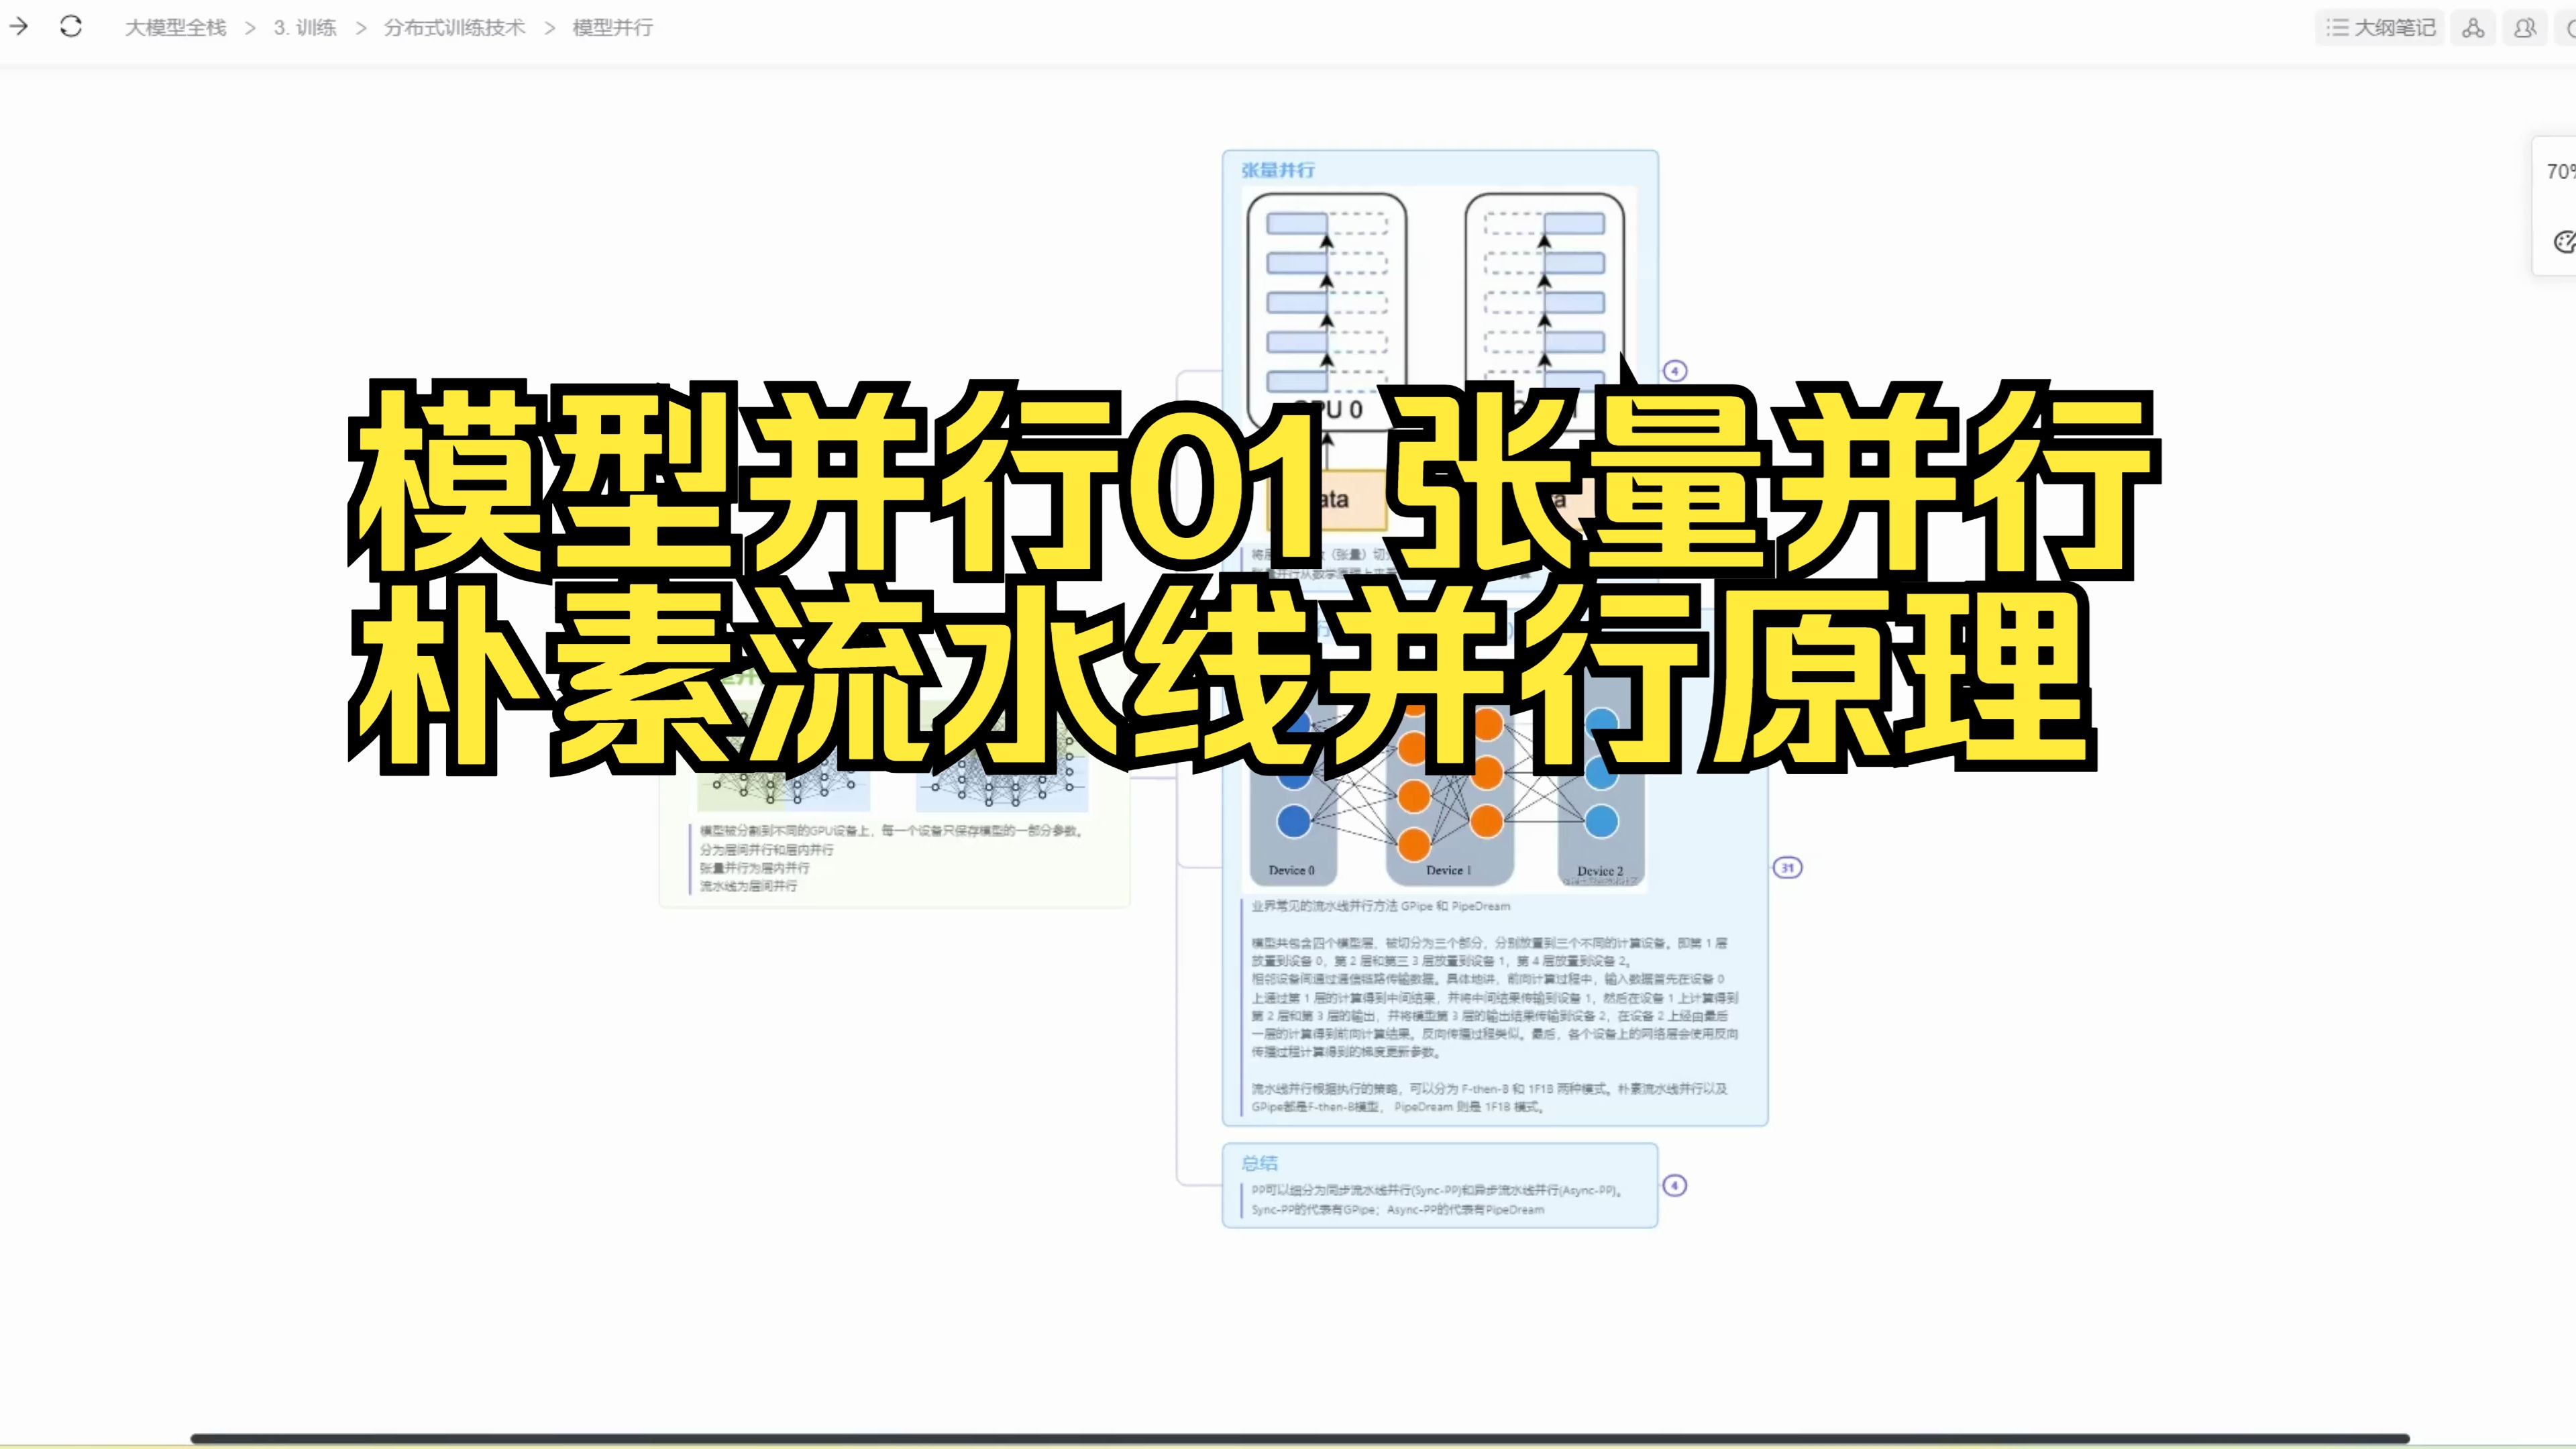

张量并行的核心原理与适用场景
张量并行并非简单地复制模型,而是对模型内部的矩阵运算进行拆分,以Transformer架构中的注意力机制和前馈神经网络(FFN)为例,这些模块包含大量的矩阵乘法操作,张量并行将这些大矩阵沿行或列方向切分,分别由不同的GPU处理,最后通过All-Reduce通信集合操作合并结果。
为什么选择张量并行而非其他并行方式?
在构建大模型分布式训练张量并行教程时,理解其与其他并行策略的区别是第一步,数据并行(Data Parallelism)复制整个模型到每张卡,仅对输入数据切片,显存消耗随模型大小线性增长,无法解决显存溢出问题,模型并行(Model Parallelism)将不同层分布在不同卡上,通信开销较大且负载不均衡。
张量并行的优势在于它能在单层内部实现并行,极大地减少了单卡显存压力,据行业共识认为,在参数量超过百亿且显存受限的场景下,张量并行是提升硬件利用率的最佳选择,它特别适合那些对延迟敏感、需要高吞吐量的在线推理服务,以及需要快速迭代训练的大规模预训练任务。
典型应用场景分析
- 千亿参数模型微调:当使用LoRA等高效微调技术时,虽然参数更新量小,但激活值和优化器状态仍占用大量显存,张量并行可以释放这部分空间,允许更大的Batch Size。
- 高并发推理服务:在API服务中,请求并发量大,张量并行能充分利用多卡算力,降低单个请求的响应时间。
- 超大规模预训练:对于从头训练万亿参数模型,张量并行结合流水线并行是唯一的可行方案,确保训练过程不中断。

实战配置:从零搭建张量并行环境
配置张量并行涉及硬件准备、框架选择和代码实现三个关键环节,目前主流的大模型训练框架如Megatron-LM、DeepSpeed均原生支持张量并行,以下以基于PyTorch和Megatron-LM风格的实现逻辑为例,展示具体操作路径。
硬件与环境准备
确保集群中所有GPU通过NVLink或高速InfiniBand网络连接,带宽越高,All-Reduce通信开销越低,建议使用A100或H100等支持FP8或BF16高精度计算的显卡,安装CUDA、cuDNN以及对应版本的PyTorch。
代码实现核心步骤
在代码层面,实现张量并行主要涉及自定义Linear层和Attention层的切分逻辑,以下是关键代码结构的示意:
- 初始化分布式环境:使用
torch.distributed.init_process_group初始化后端,设置world_size为GPU总数,rank为当前进程ID。 - 定义TensorParallelLinear:重写
nn.Linear,将权重矩阵W沿列切分,前向传播时,输入向量也相应切分,计算局部矩阵乘法,最后使用torch.distributed.all_reduce求和得到最终输出。 - 修改Attention机制:将Q、K、V投影层和Output投影层均替换为张量并行版本,确保多头注意力(Multi-Head Attention)中的头数能被并行度整除。
具体操作命令示例
启动训练时,需指定并行度参数,使用4张卡进行2维张量并行:
torchrun --nproc_per_node=4 --nnodes=1 --node_rank=0
    --master_addr="127.0.0.1" --master_port=29500
    train.py
    --tensor_parallel_size 2
    --pipeline_parallel_size 2
    --model_path /path/to/model

在此命令中,--tensor_parallel_size 2表示每个流水线阶段内部分为2个张量并行组,这种配置方式灵活,可根据集群拓扑动态调整。
性能优化与常见问题排查
张量并行虽然强大,但若配置不当,通信开销可能抵消计算加速带来的收益,优化重点在于减少GPU间的数据传输频率和体积。
通信开销优化策略
- 重叠通信与计算:现代框架如DeepSpeed支持通信计算重叠技术,即在等待数据同步的同时进行下一阶段的计算,这能隐藏大部分通信延迟。
- 优化All-Reduce算法:选择适合集群拓扑的集合通信算法,对于NVLink互联的卡,使用Ring All-Reduce效率最高;对于跨节点训练,需结合NCCL库优化路径。
- 混合精度训练:启用FP16或BF16混合精度训练,不仅减少显存占用,还能加速矩阵乘法运算,间接降低通信数据量。
常见报错与解决方案
- 显存溢出(OOM):即使使用了张量并行,若Batch Size过大或序列长度过长,仍可能OOM,解决方案是进一步减小Batch Size,或引入激活值重计算(Activation Checkpointing)。
- 通信超时:在大规模集群中,网络抖动可能导致NCCL超时,建议增加
timeout参数,并检查网卡驱动和交换机配置。 - 精度下降:张量并行涉及浮点数累加,可能导致精度损失,建议使用FP32主权重,FP16/BF16进行计算,并在All-Reduce后进行缩放恢复。
张量并行与其他技术组合的最佳实践
单一并行策略往往难以应对极端规模,组合使用才是王道,业内专家指出,将张量并行与流水线并行(Pipeline Parallelism)和数据并行(Data Parallelism)结合,即3D并行,是当前最成熟的方案。
3D并行架构解析
- 数据并行:复制多个模型副本,处理不同批次的数据,增加吞吐量。
- 流水线并行

:将模型层切分,不同GPU处理不同层,隐藏计算延迟。
- 张量并行:在流水线中的每个阶段内部,对层进行细粒度切分,解决显存瓶颈。

这种组合方式使得集群利用率最大化,在一个128卡的集群中,可以设置为数据并行度8,流水线并行度4,张量并行度4,这种配置既保证了显存充足,又实现了高并发和高吞吐。
如何选择并行度组合?
选择并行度需考虑硬件限制和业务需求,若显存极度紧张,优先增加张量并行度;若计算瓶颈明显,优先增加数据并行度;若层间依赖导致负载不均,调整流水线并行度,据统计,多数情况下,张量并行度不宜超过8,否则通信开销将急剧上升,导致加速比下降。
大模型分布式训练张量并行教程Q&A
大模型分布式训练张量并行教程中常见的性能瓶颈是什么?
张量并行的主要瓶颈在于GPU间的通信开销,当模型层较薄或并行度较高时,All-Reduce通信时间可能超过计算时间,解决此问题需优化网络拓扑,使用高速互联技术,并采用通信计算重叠策略,显存碎片化也是常见问题,需合理分配内存池。
张量并行对模型精度的影响有多大?
理论上,张量并行不会改变数学计算结果,但由于浮点数累加顺序的变化,可能会引入微小的数值误差,在FP16/BF16混合精度训练下,这种误差可能被放大,实践中,多数情况下精度损失在可接受范围内,通常低于0.1%,若对精度要求极高,建议使用FP32进行主权重更新,并在关键层禁用张量并行。
如何评估张量并行的加速效果?
评估加速效果需关注两个指标:吞吐量(Tokens per Second)和显存利用率,通过对比相同模型在不同并行度下的训练速度,可计算加速比,理想情况下,张量并行应接近线性加速,但受通信开销限制,通常只能达到80%-90%的线性效率,显存利用率应保持在85%以上,若过低说明并行度配置过高,需降低张量并行度以增加Batch Size。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/391350.html