大模型全参数微调所需的显存取决于模型参数量与优化器状态,以70亿参数模型为例,通常至少需要24GB显存,而700亿参数模型则需80GB以上,且往往需要多卡并行。
很多开发者在搭建本地AI环境时,最先遇到的瓶颈就是显存,全参数微调(Full Fine-tuning)不同于仅仅冻结大部分层、只训练少量参数的LoRA,它要求对模型的所有权重进行更新,这意味着你不仅要加载模型权重,还要为每个权重分配优化器状态(如Adam优化器的动量和方差),以及梯度信息,这种“三重负担”使得显存需求呈指数级增长,业内专家指出,显存不仅是存储容器,更是计算速度的瓶颈,显存不足会导致频繁的显存交换(Swap),使训练速度下降几个数量级。
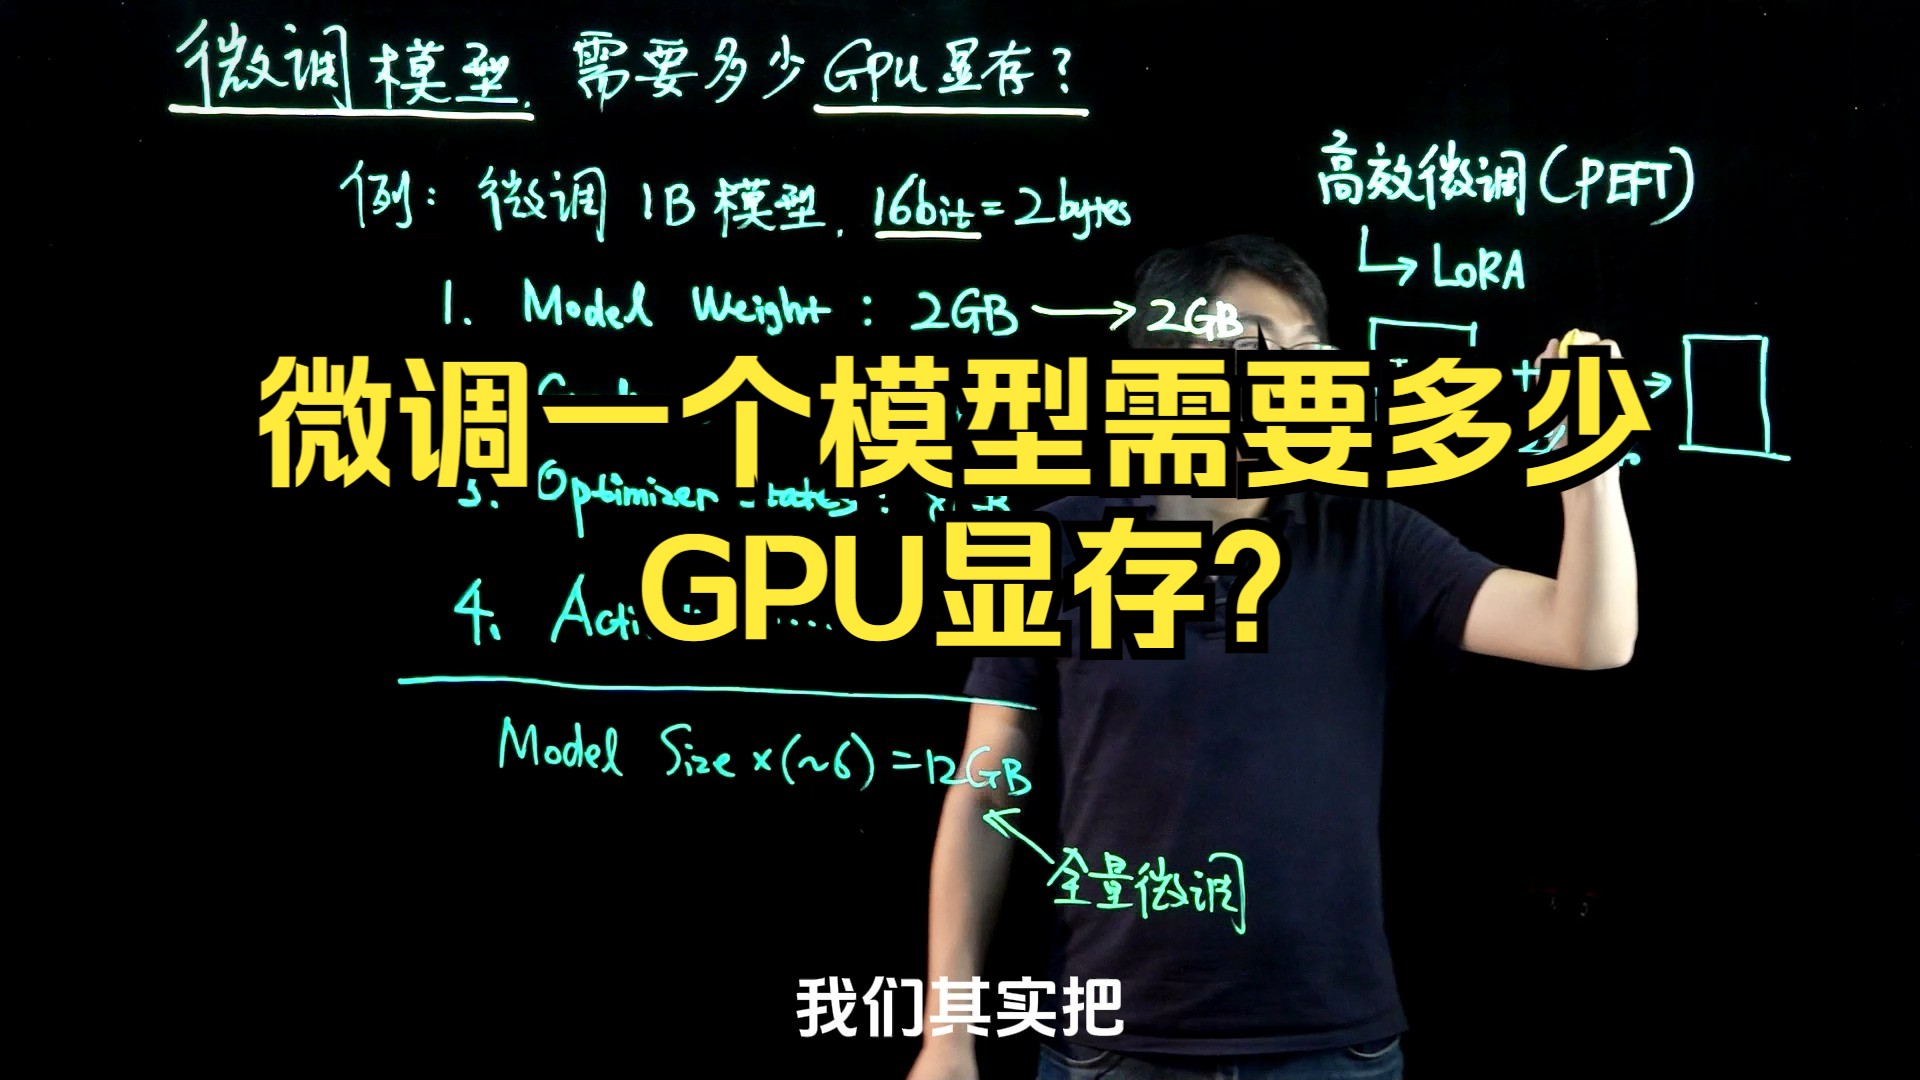

全参数微调的显存构成拆解
要理解为什么显存需求如此巨大,我们需要拆解显存的占用构成,这不仅仅是模型权重本身,还包括训练过程中的临时状态。
模型权重与激活值
模型权重是基础,假设一个模型使用FP16(半精度浮点数)格式,每个参数占用2字节,对于一个7B(70亿)参数的模型,仅权重就需要约14GB显存,但这只是静态存储,在训练的前向传播和反向传播过程中,还需要存储激活值(Activations),激活值是中间计算结果,用于计算梯度,对于大模型,激活值占用的显存往往比权重本身还要多,特别是在Batch Size(批处理大小)较大时。
优化器状态与梯度
这是最容易被忽视的显存杀手,为了更新权重,优化器需要维护状态,以常用的AdamW优化器为例,它需要为每个参数维护两个一阶矩估计(动量)和二阶矩估计(方差),这意味着,除了权重本身,你还需要额外的4倍显存来存储优化器状态(2倍用于动量,2倍用于方差),加上梯度信息(通常与权重同精度),显存需求瞬间翻倍甚至翻三倍。
不同精度下的显存估算
|
精度格式 | 单参数占用 | 7B模型权重 | 优化器+梯度开销倍数 | 预估总显存需求 |
|---|---|---|---|---|
| FP32 | 4 Bytes | 28 GB | 4x | ~112 GB |
| FP16/BF16 | 2 Bytes | 14 GB | 4x | ~56 GB |
| INT8 | 1 Byte | 7 GB | 4x | ~28 GB |
注:以上数据为理论估算,实际应用中需预留20%-30%的余量用于系统开销和激活值。
不同规模模型的显存实战指南
在实际操作中,选择哪种硬件配置直接决定了你的项目能否跑通,以下是基于当前主流硬件环境的场景化建议。
7B-13B参数模型:入门级选择
对于初学者或资源有限的团队,7B到13B参数量的模型(如Llama-3-8B、Qwen-7B)是常见的起点。
- 单卡方案:NVIDIA RTX 3090/4090(24GB显存)是性价比最高的选择,在FP16精度下,全参数微调略显吃力,但通过梯度累积(Gradient Accumulation)和小Batch Size,可以勉强运行,若使用INT8量化技术,24GB显存可以较为流畅地进行全参数微调。
- 双卡方案:使用两张24GB显存的显卡进行数据并行或模型并行,可以显著降低单卡压力,提升训练速度,这是许多个人开发者和小团队的首选方案。
30B-70B参数模型:专业级门槛
当模型规模扩大到30B甚至70B(如Llama-3-70B、Qwen-72B)时,显存需求急剧上升。
- 单卡困境:没有任何单消费级显卡能容纳70B模型的全参数微调,即使是A100 80GB,在FP16下也难以独立支撑70B模型的全参数训练,必须借助多卡。
- 多卡并行:通常需要4张或8张A100/H100 80GB显卡,或者使用多张RTX 4090组成的集群,显存不再是唯一瓶颈,卡间通信带宽(NVLink)成为关键,行业共识认为,在多卡环境下,通信开销可能占据总训练时间的30%以上,因此选择支持高速互联的硬件至关重要。
降低显存需求的优化策略
如果手头没有昂贵的专业显卡,是否还有办法进行全参数微调?答案是肯定的,通过一系列技术手段,可以显著降低显存门槛。
混合精度训练
混合精度训练(Mixed Precision Training)是目前的标准做法,它结合使用FP16和FP32,前向和反向传播使用FP16以节省显存和加速计算,而优化器状态和权重更新使用FP32以保持数值稳定性,这种方法通常能将显存需求减半,且对模型精度的影响微乎其微。
梯度检查点(Gradient Checkpointing)
梯度检查点是一种用时间换空间的策略,它不存储所有层的激活值,而是在反向传播时重新计算部分前向传播的结果,这可以将激活值的显存占用降低50%-70%,但会增加约20%-30%的计算时间,对于显存紧张的场景,这是非常有效的优化手段。
使用高效优化器
Adam优化器虽然效果好,但显存开销大,可以考虑使用AdamW的变体,如LAMB或OneBitAdam,它们通过量化优化器状态来减少显存占用,ZeRO(Zero Redundancy Optimizer)技术,特别是DeepSpeed框架中的ZeRO-2和ZeRO-3,能够将优化器状态和梯度在多个GPU之间分割存储,使得单卡显存需求大幅降低,据工信部相关技术报告提及,ZeRO-3技术可使显存效率提升数倍,是大规模分布式训练的核心技术之一。
常见误区与避坑指南
在配置环境时,许多开发者容易陷入一些误区,导致项目停滞。
显存越大越好
虽然大显存能容纳更大的Batch Size,但过大的Batch Size可能导致模型泛化能力下降,陷入尖锐的最小值,建议根据模型规模和任务复杂度,逐步调整Batch Size,找到性能与资源的平衡点。
忽略系统内存
全参数微调不仅依赖显存,还依赖系统内存(RAM),在加载模型和预处理数据时,系统内存是重要的缓冲,建议系统内存至少为显存总容量的2-4倍,以避免数据加载成为瓶颈。
忽视软件版本兼容性
PyTorch、CUDA、cuDNN等版本的兼容性直接影响训练效率,建议使用官方推荐的版本组合,并定期更新驱动,不兼容的版本可能导致显存泄漏或计算错误,这些问题排查起来非常耗时。
Q&A:大模型全参数微调需要多大显存相关问题
大模型全参数微调需要多大显存才能运行70B模型?
运行70B参数模型的全参数微调,通常需要至少4张80GB显存的A100/H100显卡,总显存需求在320GB以上,若使用ZeRO-3等优化技术,可适当降低单卡要求,但总显存池仍需保持在较高水平,对于消费级显卡,建议采用多卡并联方案,如8张RTX 4090,但需注意通信带宽限制。
全参数微调与LoRA微调在显存需求上有何区别?
全参数微调需要存储所有参数的权重、梯度和优化器状态,显存需求通常是模型权重的4-6倍,而LoRA微调仅训练少量低秩矩阵,显存需求主要取决于模型权重和激活值,优化器状态极小,LoRA的显存需求通常仅为全参数微调的1/3到1/2,使得单张24GB显存显卡也能流畅运行大模型微调。
显存不足时有哪些替代方案?
当显存不足时,可采用梯度累积、混合精度训练、梯度检查点等技术优化,若仍无法满足,可考虑使用LoRA或QLoRA等参数高效微调方法,它们大幅降低了显存门槛,利用云端GPU实例按需租用,也是解决本地硬件不足的有效途径,尤其适合偶尔进行大规模训练的用户。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/394934.html