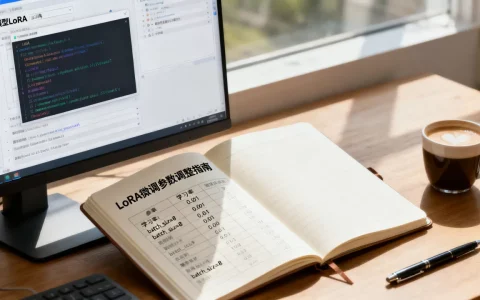
解决大模型LoRA微调显存不足的核心思路是:通过梯度检查点、混合精度训练、参数冻结及量化技术组合拳,在保留模型核心能力的同时,将显存占用降低至消费级显卡可承受的范围。
当你在本地部署LLaMA、Qwen或ChatGLM等大模型并尝试进行LoRA微调时,显存溢出(OOM)是新手最常遇到的“拦路虎”,这并非硬件绝对不行,而是显存管理策略不够精细,业内专家指出,合理的显存优化方案能让原本需要A100才能跑的任务,在RTX 3090甚至2080Ti上流畅运行,我们需要从数据加载、模型加载、训练过程三个维度进行拆解,找到那个让显存“瘦身”的关键杠杆。

理解显存占用的三大黑洞
在动手优化之前,必须清楚显存到底被谁吃掉了,大模型微调的显存占用主要由三部分组成:模型参数本身、优化器状态(Optimizer States)以及激活值(Activations)。
模型参数与优化器状态
这是最直观的部分,如果你加载一个7B参数的模型,即使使用FP16(半精度),也需要约14GB显存,而LoRA虽然只训练少量参数,但为了反向传播,主流框架如PEFT(Parameter-Efficient Fine-Tuning)通常需要加载完整的模型权重到显存中,以便计算梯度,更可怕的是优化器状态,AdamW优化器需要为每个参数维护均值和方差两个统计量,这意味着优化器状态占用的显存通常是模型参数本身的2-4倍。
激活值的隐形消耗
激活值是指前向传播过程中,每一层网络输出的中间结果,在反向传播计算梯度时,这些中间结果必须保留在显存中,对于长文本序列,激活值的显存占用呈线性甚至超线性增长,当你尝试微调10k或更长上下文长度的模型时,激活值往往会成为压垮显存的最后一根稻草。

LoRA微调显存不够怎么办:实战优化策略
针对上述三大黑洞,我们可以采取一系列经过验证的技术手段,以下方案按效果从显著到温和排序,建议组合使用。
启用梯度检查点(Gradient Checkpointing)
这是解决激活值占用过高的最有效手段,梯度检查点的核心思想是“以时间换空间”:在前向传播时不保存所有中间激活值,而是在反向传播时重新计算必要的中间层输出。
- 操作路径:在Hugging Face Transformers库中,只需在加载模型时添加
gradient_checkpointing=True参数。 - 代码示例:
model.gradient_checkpointing_enable()
- 效果评估:此举可将激活值显存占用降低50%-70%,代价是训练速度会有轻微下降(约10%-15%),但在显存瓶颈场景下,这是性价比最高的选择。
混合精度训练与量化技术
单纯使用FP16往往不够,结合更细粒度的量化技术能大幅释放显存。
BF16与FP16的选择
对于支持BFloat16的显卡(如Ampere架构及以后的NVIDIA GPU,包括RTX 30系列、40系列及A100),强烈建议使用BF16而非FP16,BF16拥有与FP32相同的动态范围,避免了FP16在梯度爆炸时容易出现的下溢问题,且显存占用相同。
使用bitsandbytes进行4-bit量化
如果显存依然紧张,可以将模型权重量化为4-bit(NF4格式),这能将模型权重占用从14GB(7B模型FP16)压缩至约4GB。
- 操作路径:安装
bitsandbytes库,并在加载模型时设置load_in_4bit=True。 - 注意事项:4-bit量化会轻微损失模型精度,但对于大多数指令微调任务,效果差异极小,行业共识认为,在显存受限场景下,4-bit量化是首选方案。

数据加载与批次大小的动态调整
显存不足往往不是因为模型太大,而是因为“一口吃得太撑”。
梯度累积(Gradient Accumulation)
当你的Batch Size(批次大小)设为1时,如果显存仍有富余,可以尝试增大Batch Size,但如果显存已满,无法增大Batch Size,则应使用梯度累积。
- 原理:将一个大Batch拆分为多个小Step,每个Step只前向/反向传播一次,但不立即更新权重,待累积了N个Step的梯度后,再统一更新一次模型参数。
- 等效效果:这等效于使用了N倍大的Batch Size,从而稳定梯度,同时保持单次显存占用极低。
- 实操建议:根据显存剩余情况,将
gradient_accumulation_steps设置为2、4或8。
动态填充与截断
在处理长文本时,避免使用固定长度的Padding,使用DataCollatorForLanguageModeling或类似的动态填充器,确保每个Batch中样本长度接近,减少无效Padding带来的显存浪费,合理设置max_length,对于不需要长上下文的任务,将输入截断至2048或4096以内,能显著降低激活值占用。
常见误区与避坑指南
在优化过程中,许多开发者容易陷入一些误区,导致优化效果不佳或训练失败。
盲目增大Batch Size
许多初学者认为增大Batch Size能加速收敛,但在显存不足时,强行增大Batch Size只会导致OOM,正确的做法是先启用梯度检查点和量化,再根据剩余显存调整Batch Size和梯度累积步数。
忽略LoRA Rank和Alpha的平衡
LoRA的Rank(r)和Alpha(α)参数直接影响可训练参数量,虽然LoRA本身不增加主模型显存占用,但Rank过大可能导致优化器状态占用略微增加,建议从较小的Rank(如8或16)开始,根据任务复杂度逐步调整。

未释放无用变量
在Jupyter Notebook或交互式环境中,未正确删除旧模型或数据变量会导致显存泄漏,务必在切换模型或结束训练前,使用del model、torch.cuda.empty_cache()等命令清理显存。
LoRA微调显存不够怎么办:Q&A模块
LoRA微调显存不够怎么办,RTX 3090能跑7B模型吗?
RTX 3090拥有24GB显存,完全有能力微调7B参数的大模型,建议配置如下:使用BF16混合精度,加载NF4量化模型(占用约4-5GB),启用梯度检查点,设置Batch Size为1-2,梯度累积步数为4-8,此配置下,显存占用可控制在12-16GB之间,留有充足余量用于激活值和优化器状态,训练稳定且速度较快。
LoRA微调显存不够怎么办,如何判断是显存瓶颈还是计算瓶颈?
通过监控显存使用率和GPU利用率判断,如果显存占用接近100%但GPU利用率较低(如低于50%),说明是显存瓶颈,需优化数据加载、启用梯度检查点或量化模型,如果显存占用不高但GPU利用率持续满载,说明是计算瓶颈,可尝试增大Batch Size或使用更快的硬件。
LoRA微调显存不够怎么办,4-bit量化会影响模型效果吗?
4-bit量化会对模型精度产生轻微影响,主要体现在复杂推理和长文本生成上,但对于大多数指令微调(Instruction Tuning)任务,如对话、分类,效果损失通常在可接受范围内( perplexity 增加<1%),若对精度要求极高,可尝试8-bit量化作为折中方案,或在微调后使用全精度模型进行推理。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/394546.html