大模型MoE(混合专家)架构的核心原理是通过“路由机制”将不同任务分配给特定的子模型(专家)处理,仅在推理时激活部分参数,从而在保持模型总参数量巨大的同时,显著降低计算成本和推理延迟。
想象一下,你面对一个拥有千亿参数的超级大脑,如果每次回答简单问题都要调动整个大脑的所有神经元,那不仅耗电惊人,速度也会慢得像蜗牛,MoE架构就像是一个高效的“公司化管理”模式,把庞大的模型拆分成多个专业的“部门”(专家),每个部门只负责自己擅长的领域,当问题进来时,有一个聪明的“调度员”(路由器)快速判断该找哪个部门,只唤醒相关的专家来工作,其他专家则在一旁休息,这种“按需分配”的机制,让大模型在追求极致性能的同时,不再被算力成本死死卡住脖子。
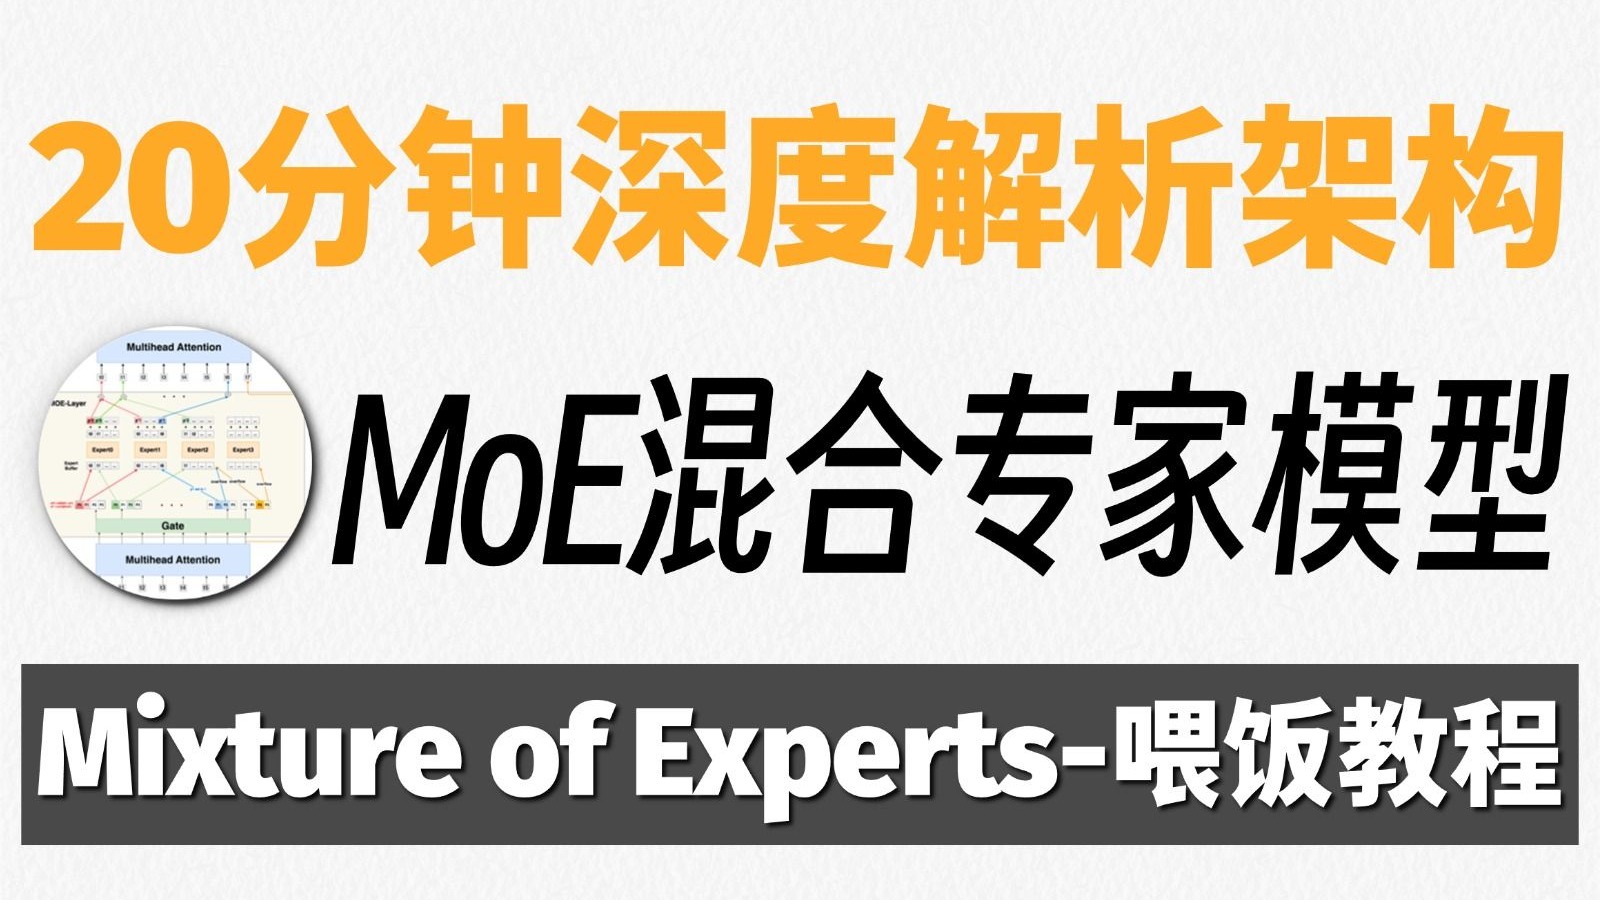

MoE混合专家架构是什么原理及核心运作机制
要理解MoE,不能只看静态的参数,必须看动态的流程,传统的稠密模型(Dense Model)像是一个全能通才,无论问什么,所有参数都参与运算,而MoE模型更像是一个专家团队,内部包含多个“专家网络”(Expert Networks)。
路由机制:精准的任务分发
MoE的灵魂在于“门控网络”(Gating Network),也就是我们常说的路由器,它的作用是根据输入Token的特征,计算每个专家被激活的概率。
- Top-K选择策略:这是目前最主流的实现方式,路由器不会让所有专家都干活,而是选出概率最高的K个专家(通常K=1或2)。
- 稀疏激活:假设一个MoE模型有64个专家,但每次推理只激活2个,这意味着,虽然模型总参数量很大,但实际参与计算的参数量只有原来的1/32甚至更低。
- 负载均衡:为了防止某些热门专家累死,而冷门专家闲死,业内专家指出,优秀的MoE架构会引入负载均衡损失函数,强制路由器将任务均匀分散给不同的专家。

专家网络:垂直领域的深度专精
每个专家本质上是一个小型的前馈神经网络(FFN),在训练过程中,这些专家会自发地形成“专长”。
- 语法专家:可能专门处理复杂的句子结构和标点符号。
- 事实专家:可能更擅长记忆历史事件、科学数据等硬性知识。
- 逻辑专家:可能在数学推理或代码生成上表现突出。
这种分工使得模型在处理复杂任务时,能够组合不同专家的优势,产生“1+1>2”的效果。
MoE与稠密模型Dense对比:性能与成本的博弈
在讨论MoE时,绕不开与主流稠密模型的对比,很多开发者在选型时,最关心的就是“MoE混合专家架构对比传统模型到底强在哪”。
算力效率的质变
这是MoE最直观的优势,在相同的计算预算下,MoE模型可以拥有比稠密模型多几倍甚至几十倍的参数量。
- 推理速度:由于只激活部分参数,MoE在相同硬件上的推理吞吐量通常更高。
- 显存占用:虽然模型总权重很大,但加载到显存中的活跃参数较少,使得在有限显存下运行超大模型成为可能。
训练难度的挑战
虽然推理爽了,但训练MoE却是个苦差事。
- 路由不稳定:早期MoE模型常出现“路由崩溃”,即所有任务都涌向同一个专家,导致其他专家无法更新梯度,变成“僵尸专家”。
- 通信开销:在分布式训练中,数据需要在不同GPU间频繁传输以汇聚专家的计算结果,这对网络带宽提出了极高要求,据统计,多数情况下,MoE的训练稳定性比稠密模型低,需要更精细的工程调优。

MoE架构的实际应用场景与落地路径
MoE并非万能药,它在特定场景下优势明显,对于寻求“MoE大模型应用场景”的开发者来说,以下领域是最佳切入点。
长文本与复杂推理
在处理超长文档或需要多步推理的任务时,MoE的表现往往优于同等规模的稠密模型,因为不同的推理步骤可以调用不同的专家,避免了单一专家过载。
多语言与多模态处理
MoE天然适合多任务学习,你可以让不同的专家分别精通中文、英文、代码或图像描述,当输入中文时,中文专家被激活;输入代码时,代码专家被激活,这种隔离性减少了任务间的干扰(Negative Transfer)。
边缘设备与私有化部署
对于资源受限的场景,MoE提供了一种“用小算力跑大模型”的可能,通过量化和剪枝,结合MoE的稀疏性,可以在消费级显卡上运行原本需要A100才能跑的千亿参数模型。
实操建议:如何评估MoE模型
在选型时,不要只看参数量,建议关注以下指标:
- 激活参数比:查看模型文档中提到的Active Parameters,这直接决定推理成本。
- 路由算法:了解其使用的是Top-K还是Softmax,以及是否有负载均衡机制。
- 专家数量:专家数量过多会导致路由开销增加,过少则无法体现稀疏性优势,通常64-128个专家是平衡点。
MoE混合专家架构未来发展趋势与Q&A

随着硬件算力的提升和算法的成熟,MoE架构正在从“研究热点”走向“工业标配”,未来的趋势是更细粒度的专家划分,以及更智能的动态路由算法。
常见问题解答
MoE混合专家架构相比传统稠密模型有什么具体优势?
MoE的主要优势在于计算效率,它允许模型拥有巨大的总参数量以提升知识容量和表达能力,但在每次推理时只激活一小部分参数,这意味着在相同的硬件资源下,MoE模型可以比稠密模型处理更复杂的任务,或者在相同的任务下运行得更快、成本更低,其核心在于“稀疏激活”,即按需调用算力,避免了全参数计算的浪费。
为什么MoE模型在训练时容易出现不稳定?
MoE训练不稳定的核心原因是“路由不平衡”和“梯度消失”,由于每次只激活少数专家,未被激活的专家无法获得梯度更新,长期处于休眠状态,如果路由器倾向于将大部分样本分配给少数几个专家,这些专家会迅速过拟合,而其他专家则无法学习,解决这一问题通常需要引入额外的负载均衡损失函数,并采用更复杂的路由策略,如辅助损失或噪声注入,来强制分散任务。
MoE架构是否适用于所有类型的大模型任务?
MoE并非适用于所有场景,对于简单、低延迟要求的任务,稠密模型可能更具优势,因为MoE的路由机制本身会带来额外的计算开销,MoE在需要高度一致性和稳定性的领域(如金融高频交易决策)需谨慎使用,因为其动态激活特性可能导致输出结果的微小波动,MoE更适用于对知识广度、推理深度和长文本处理能力要求较高的场景,如通用对话、代码生成和复杂逻辑推理。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/%e5%a4%a7%e6%a8%a1%e5%9e%8bmoe%e6%b7%b7%e5%90%88%e4%b8%93%e5%ae%b6%e6%9e%b6%e6%9e%84%e6%98%af%e4%bb%80%e4%b9%88%e5%8e%9f%e7%90%86/