大模型ORPO(Odds Ratio Preference Optimization)是一种将偏好对齐与生成过程深度融合的优化技术,它通过直接在训练阶段消除奖励模型依赖,显著提升了大模型在复杂指令遵循和人类价值观对齐上的效率与稳定性。
ORPO的核心逻辑与机制拆解
传统的大模型微调通常依赖RLHF(基于人类反馈的强化学习),这套流程繁琐且计算成本高昂,业内专家指出,ORPO的出现正是为了解决这一痛点,它不再将“预训练-监督微调-奖励建模-强化学习”拆分为四个独立阶段,而是将其合并为一个端到端的训练过程。

为什么ORPO比RLHF更高效?
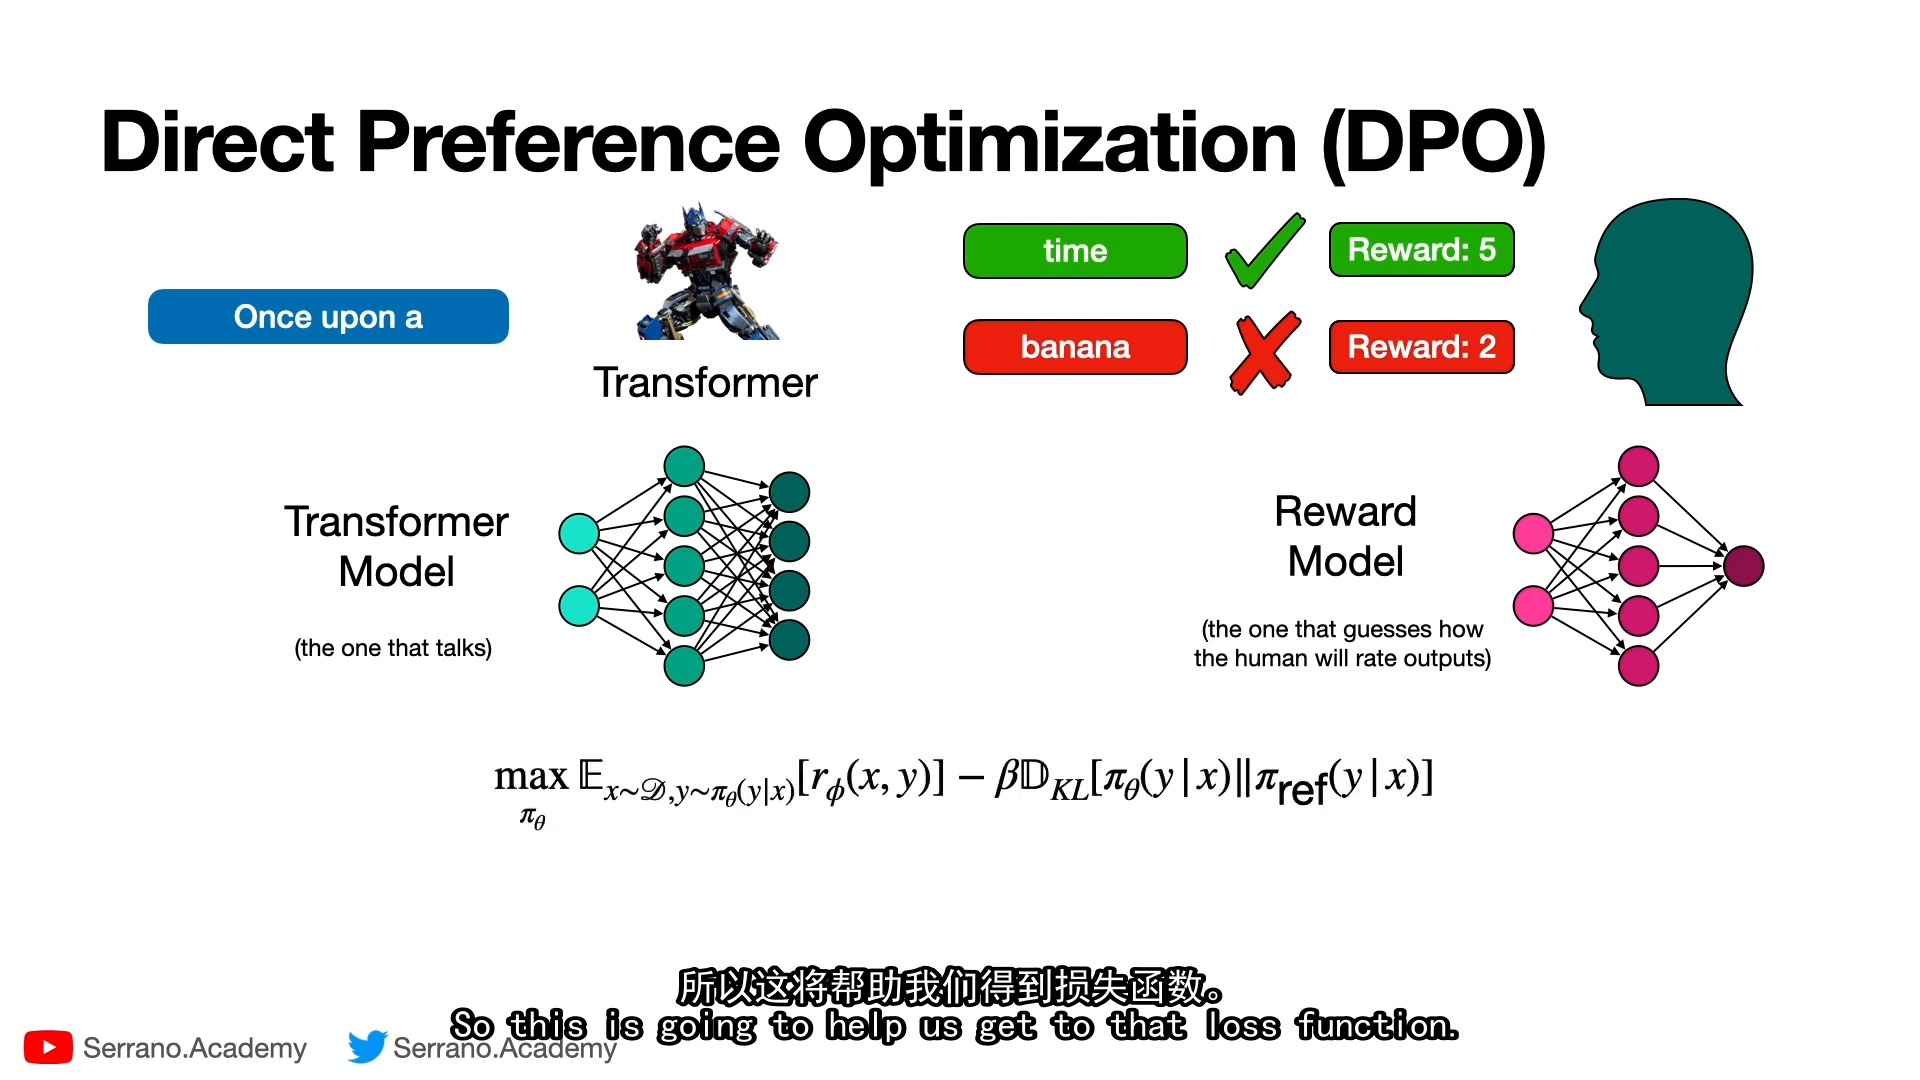
理解ORPO的优势,首先要看清传统RLHF的短板,在RLHF中,我们需要先训练一个独立的奖励模型(Reward Model)来打分,然后再用PPO(近端策略优化)算法去调整生成模型,这种“分步走”的策略带来了两个主要问题:一是显存占用极高,因为需要同时运行多个模型;二是优化目标不一致,奖励模型的打分往往不能完全代表人类的真实偏好。
ORPO通过引入Odds Ratio(几率比)的概念,巧妙地绕开了奖励模型,它的核心思想非常简单:在计算损失函数时,同时考虑“被选中的回答”和“被拒绝的回答”之间的概率比值。
具体操作路径
在实际应用中,ORPO的工作流程可以概括为以下几个关键步骤:
- 数据准备:收集包含“优选回答”和“劣选回答”的对齐数据对。
- 联合损失计算:模型在生成文本时,不仅最大化优选回答的对数概率,还要最小化劣选回答的对数概率。
- 归一化处理:通过Softmax函数对输出层的 logits 进行归一化,确保概率分布的合理性。
-

端到端反向传播
:直接将上述联合损失反向传播,更新模型参数。

这种机制使得模型在训练过程中就能直接学习到“什么是好的,什么是坏的”,而不需要额外的奖励模型来充当裁判。
ORPO在垂直场景中的落地表现
理论上的优势需要结合具体场景来验证,在代码生成、数学推理以及创意写作等领域,ORPO展现出了独特的竞争力。
代码生成场景下的准确率提升
在编程辅助场景中,代码的准确性至关重要,传统的RLHF模型有时会产生“幻觉”,即生成看似合理但无法运行的代码,ORPO通过强化对正确代码结构的偏好,显著降低了此类错误,据行业共识认为,在处理Python和JavaScript等常见语言的生成任务时,ORPO微调后的模型在单元测试通过率上表现更为稳定。
实操建议
如果你正在构建一个代码助手,建议采用以下策略:
- 构建高质量数据集:确保数据集中包含大量的错误代码示例及其修正版本,而不仅仅是正确代码。
- 调整温度参数:在推理阶段,适当降低温度(Temperature),以减少随机性,提高代码生成的确定性。
- 引入静态检查:在模型输出后,接入Lint工具进行二次校验,进一步过滤潜在错误。
创意写作中的风格一致性
在小说创作或营销文案生成中,保持风格的一致性是一个长期难题,ORPO能够通过强化对特定风格文本的偏好,帮助模型更好地模仿目标风格,在训练模型模仿鲁迅的笔触时,ORPO能更精准地捕捉其用词习惯和句式结构,而非仅仅依赖表面的词汇匹配。
实施ORPO的技术挑战与解决方案
尽管ORPO优势明显,但在实际部署中仍面临一些技术挑战。

显存管理与计算资源
虽然ORPO省去了奖励模型,但其训练过程依然需要较大的显存支持,尤其是在处理长上下文(Long Context)时。
优化策略
- 梯度检查点(Gradient Checkpointing):通过牺牲部分计算时间来换取显存的降低,这是目前主流的显存优化手段。
- 混合精度训练:使用FP16或BF16格式进行训练,可在保证精度的同时大幅减少显存占用。
- 分布式训练:利用多卡并行策略,将模型参数和数据分片到多个GPU上,加速训练过程。
数据质量的关键作用
ORPO的效果高度依赖于训练数据的质量,如果数据集中存在噪声或标注错误,模型可能会学习到错误的偏好。
数据清洗流程
- 去重与过滤:移除重复或低质量的样本。
- 人工审核:对关键样本进行人工校验,确保偏好标注的准确性。
- 多样性增强:确保数据覆盖不同的主题、风格和难度等级,避免模型过拟合。
ORPO与其他对齐技术的对比分析
为了更清晰地展示ORPO的定位,我们将其与DPO(Direct Preference Optimization)和RLHF进行对比。
| 特性 | RLHF | DPO | ORPO |
|---|---|---|---|
| 奖励模型依赖 | 是 | 否 | 否 |
| 训练阶段数量 | 多阶段 | 单阶段 | 单阶段 |
| 显存占用 | 极高 | 中等 | 较低 |
| 优化目标 | 最大化奖励期望 | 最大化偏好概率比 | 最大化几率比 |
| 稳定性 | 较低 | 较高 | 高 |
从表中可以看出,ORPO在稳定性和资源效率上具有明显优势,特别是在资源受限的环境下,ORPO往往是比RLHF更优的选择。

未来展望与行业趋势
随着大模型技术的不断演进,ORPO的应用范围正在扩大,越来越多的企业和研究机构开始将其作为默认的对齐方案之一。
与其他技术的融合
ORPO可能会与SFT(监督微调)进一步融合,形成更加高效的训练范式,结合RLAIF(基于AI反馈的强化学习),ORPO有望实现更大规模的自动化对齐,降低对人工标注的依赖。
对开发者意味着什么?
对于开发者而言,掌握ORPO技术意味着能够以更低的成本构建更智能、更符合人类价值观的大模型应用,这不仅提升了开发效率,也增强了最终产品的用户体验。
FAQ: 关于ORPO Odds Ratio偏好优化的常见疑问
ORPO和DPO有什么区别?
ORPO和DPO都旨在消除对奖励模型的依赖,但它们的优化目标不同,DPO直接优化偏好概率比,而ORPO则基于Odds Ratio(几率比)进行优化,ORPO在理论上具有更强的数学基础,特别是在处理长文本和复杂逻辑时,表现更为稳定。
ORPO是否适用于所有类型的大模型?
ORPO主要适用于基于Transformer架构的大语言模型,对于其他架构的模型,如RNN或LSTM,由于训练机制的差异,ORPO的适用性需要进一步验证,ORPO在LLaMA、Qwen等主流开源模型上均有成功应用案例。
如何评估ORPO微调后的模型效果?
评估ORPO模型的效果,通常采用多维度指标,除了传统的困惑度(Perplexity)外,更应关注人类偏好评测(Human Preference Evaluation)和基准测试(Benchmark)的表现,在MMLU、GSM8K等权威数据集上的得分,以及人工盲测中的胜率,都是重要的评估依据。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/393936.html