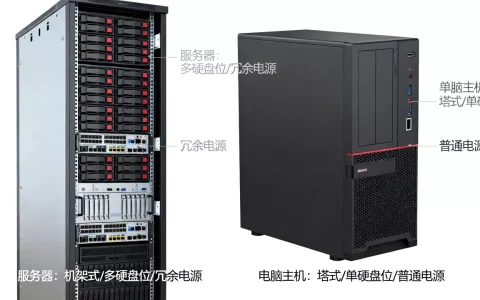
在容器化与虚拟化混合的资源池里,节点规格不是越大越省,也不是越小越灵活,决定成败的是单 Pod 规格分布与节点可分配余量之间的匹配度。 大规格节点把采购单价压下来,同时把碎片从”零钱”变成”整钞作废”;小规格节点把碎片切碎,代价是调度次数、运维对象数量和系统预留开销的成倍增加。
碎片化不是小块浪费,而是大规格节点切出了无法使用的缝隙
从一次扩容失败说起
一个 32 核 128G 的节点,看起来还能装下不少东西,运维在监控上看到 CPU 分配率只有六成出头,觉得余量充足,真到业务高峰触发 HPA 扩容时,新起的 8 核 Pod 卡在 Pending,事件里写着 Insufficient cpu,原因很朴素:剩下的空闲核数虽然是 12 核,但散落在多个 NUMA 节点和多个已分配 Pod 的间隙里,凑不出连续可用的 8 核配额。
这就是大规格节点最典型的碎片形态不是资源不够,而是资源不连续,小规格节点上,同样的 8 核 Pod 根本不会被调度上去,系统会直接给它开一台新机器,反而不会出现”看起来有、实际用不了”的错觉。
碎片从哪里来:三个可观测的切口
- 请求与限制的差值:requests 设 2 核、实际跑 0.6 核的 Pod 越多,节点账面上的”已分配”就越虚高,真实可用空间被账面数字吃掉。
- 调度粒度的整数倍约束:CPU 按毫核计、内存按 MiB 计,但大 Pod 需要的是连续配额,节点剩余量再大,凑不齐单 Pod 需求就是零。
- DaemonSet 与系统预留的固定开销:日志采集、监控探针、网络插件在每个节点上都要占一份,节点越大,这部分开销的绝对值越大,可分配给业务的”有效容量”反而被摊薄。
查这三件事不需要复杂工具,两条命令就能看个大概:
kubectl describe node <node-name> | grep -A 8 "Allocated resources"
kubectl get pods -A -o wide --field-selector spec.nodeName=<node-name>
前者看账面分配率,后者看真实 Pod 规格分布,两者一对比,碎片的大致规模就出来了。
大规格节点和小规格节点哪个好:把账单摊开算
问”大规格节点和小规格节点哪个好”,本质是在问哪一端的浪费更可接受,用一张表把差异摆平:
| 维度 | 大规格节点(如 32C128G) | 小规格节点(如 4C16G) |
|---|---|---|
| 单节点承载 Pod 数 | 多 | 少 |
| 剩余碎片绝对值 | 大 | 小 |
| 扩容粒度 | 粗,一次跳一大格 | 细,可按需小幅加 |
| 故障影响范围 | 大,一台影响多个业务 | 小,单台影响面有限 |
| 调度成功率 | 受大规格 Pod 拖累明显 | 受节点数量与调度频次影响 |
| 运维对象数量 | 少 | 多,节点与系统组件成倍增加 |
| 系统预留开销占比 | 相对低 | 相对高 |
行业共识认为,节点规格的选择没有普适最优解,只有与业务 Pod 规格分布匹配度最高的解,业内专家指出,多数集群的资源浪费并非来自采购过剩,而是来自”大节点 + 小 Pod”这种错配组合。
大规格节点的隐性成本清单
- 扩容时的 Pending 等待,直接体现为业务侧的扩容延迟。
- 为凑够连续配额而预留的”安全余量”,等于变相降低装箱率。
- 单节点故障时的迁移风暴,一次挂掉可能触发几十个 Pod 同时重建。
- 缩容不彻底:节点上只要还剩一个小 Pod,整台大机器就下不掉。
小规格节点的显性成本清单
- 节点数量上升,kubelet、容器运行时、网络插件的常驻开销按节点数线性累加。
- 调度器压力变大,大规模集群下调度延迟和调度失败率都会抬头。
- 节点池、标签、污点、亲和性规则的维护成本成倍增长。
- 单机资源少,稍大一点的 Pod 就得独占一台,装箱率同样上不去。
容器集群节点规格怎么选:一套可执行的判断路径
第一步,算清有效可分配容量
不要看实例标称规格,看 kubelet 上报的 Allocatable,再扣掉 DaemonSet 常驻占用,剩下的才是业务能用的部分,用下面的路径逐台核对:
kubectl get node <node> -o jsonpath='{.status.allocatable}'
kubectl get pods -A -o wide | grep <node> | grep -v Running
把 Allocatable 减去所有 DaemonSet 的 requests 总和,得到”有效可分配”,这个数除以实例标称核数,就是这台节点真实的可用比例。
第二步,统计业务 Pod 的规格分布
按 CPU requests 分桶:小于 1 核、1 到 4 核、4 到 8 核、8 核以上,看各桶占比,8 核以上的 Pod 占相当一部分,大规格节点才有存在意义;如果绝大多数 Pod 都在 2 核以下,把节点开到 32 核基本等于主动制造碎片。
第三步,用节点池混部对冲两端缺陷
单一规格的节点池必然在某一端吃亏,可行做法是同时维护两个池子:
- 小规格池承接无状态、可水平扩展的微服务,扩缩容灵敏。
- 大规格池用污点和容忍度隔离,专门承接大内存、大 CPU 或 GPU 类负载。
kubectl taint nodes <large-node> workload=large:NoSchedule配合 topologySpreadConstraints 控制同一业务在不同节点上的分布,避免一个大节点挂掉带走整个服务。
华东地域容器集群部署时,节点规格怎么选
地域因素常被忽略,但它实实在在影响选型,华东地域的可用区之间,实例规格的库存情况并不一致,某些大规格机型在热门可用区经常需要排队申请,选型时的实操顺序是:
- 先确定集群要落在哪几个可用区,跨可用区部署能提升容灾等级。
- 在目标可用区逐一核对候选规格的库存与可售状态,而不是在控制台默认地域里看。
- 大规格节点优先保证同规格可批量交付,避免扩容时因库存不足被迫混用不同规格,进而打乱调度假设。
- 跨可用区带宽与延迟也要纳入考虑,大节点之间的数据同步流量往往比小节点更高。
不同地域的实例价格和库存策略存在差异,同一个规格在华东与华北的实际可用性可能完全不同,选型阶段就把地域锁死,比上线后再迁移代价小得多。
大规格节点价格便宜,为什么总成本反而可能更高
单看按小时计费的实例单价,大规格机型的单位核价通常更低,这也是很多人倾向大节点的直接原因,但真实成本要按有效单价算:
有效单价 = 节点单价 ÷(有效可分配资源 × 实际平均利用率)
大节点的分母里,可分配资源被系统预留和碎片吃掉一块,利用率又因为调度凑不齐而长期偏低,最终除出来的有效单价未必比小节点便宜,小节点单价高,但装箱率高、缩容快、闲置时间短,反过来可能更划算。
算这笔账时,要按业务波峰波谷拉一条时间轴,而不是取某个瞬时快照,闲时能缩掉多少台,比忙时单价低多少更影响月度账单。
关于大规格节点与小规格的碎片化权衡:三个高频问题
大规格节点资源碎片化怎么解决?
三条路径按优先级排列:一是把大规格节点单独成池,只跑大 Pod,避免小 Pod 提前占位;二是收紧 requests,让账面分配贴近真实用量,减少虚高占用;三是启用缩容策略,把长期低负载的大节点整个下掉,而不是让它带着一堆碎 Pod 苟活,缩容阈值不宜设得过激,否则会引发频繁的反复扩缩。
大规格节点和小规格节点哪个好,有统一答案吗?
没有,判断依据是业务 Pod 的规格分布:大 Pod 占比高就偏大规格,小 Pod 为主就偏小规格,混合负载就走双池隔离,任何脱离负载特征的规格建议都缺少可执行性。
容器集群节点规格调整需要停机吗?
不需要整体停机,标准做法是新建目标规格的节点池,通过节点封锁和驱逐把旧节点上的 Pod 迁走,再下线旧池:
kubectl cordon <old-node>
kubectl drain <old-node> --ignore-daemonsets --delete-emptydir-data
迁移期间要预留足够的空余容量承接被驱逐的 Pod,否则驱逐会卡住,整个过程中业务 Pod 会被重建,但不影响集群整体可用性。
节点规格的选择,说到底是在”买得便宜”和”用得干净”之间找平衡点,先量出业务 Pod 的真实规格分布,再倒推节点规格和池子划分,比凭经验拍一个数字要可靠得多。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/776448.html