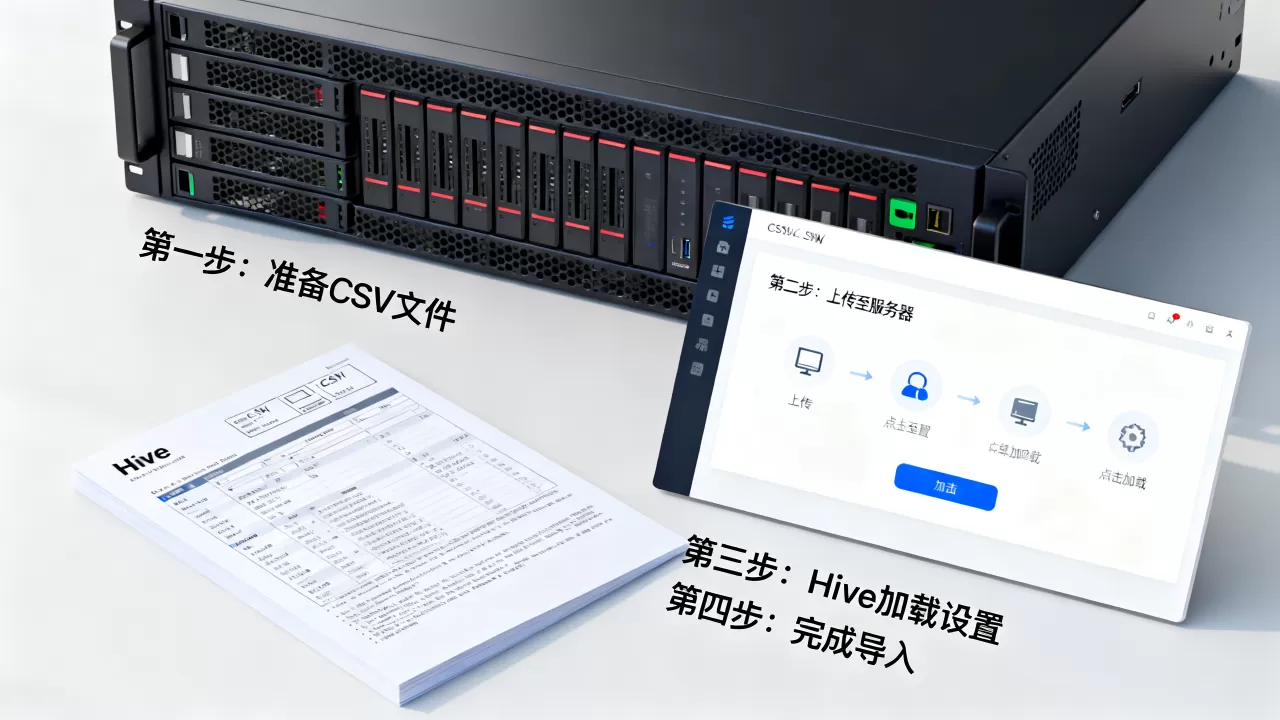
把服务器上的CSV文件放进Hive里,最直接的办法是先上传到HDFS,再用LOAD DATA INPATH命令加载,或者直接建外部表指向文件路径,不用挪数据。下面把这套流程拆开,从环境准备到常见问题一步步说清楚。
Hive导入CSV文件的两种主流方式
在实际工作中,向Hive导入CSV文件主要分两条路:一条是加载命令,另一条是外部表映射,两者的底层逻辑不同,适用场景也有明显差异。

使用LOAD DATA命令加载CSV到Hive表
LOAD DATA是Hive内置的数据加载语句,它做的事情本质上是把文件从某个位置“移动”到Hive表的存储目录下,操作流程分三步走:
- 建表,用
CREATE TABLE命令,CSV文件里的字段顺序和表字段顺序必须对齐,字段名可以不同,但类型要能转换。 - 执行加载命令,核心语句是:
LOAD DATA INPATH '/user/hive/csv/xxx.csv' INTO TABLE 表名;
这条命令会把HDFS上的文件移动进表目录,原路径下不再保留文件。
- 验证结果,用
SELECT COUNT() FROM 表名;看行数,再SELECT FROM 表名 LIMIT 10;抽查几条内容,确认字段没错位。
使用外部表直接映射CSV文件
如果CSV文件不需要移动位置,或者你希望Hive表删了文件还在,那就用外部表,建表语法稍微加几个关键字:
CREATE EXTERNAL TABLE 表名 (
  字段1 STRING,
  字段2 INT
)
ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.OpenCSVSerde'
WITH SERDEPROPERTIES (
  "separatorChar" = ",",
  "quoteChar" = """
)
STORED AS TEXTFILE
LOCATION '/data/csv文件所在目录';
这里有个关键细节:LOCATION指向的是目录,不是单个文件,Hive会读取该目录下所有匹配格式的文件,如果你的CSV文件名带特殊符号或日期后缀,只要在同一目录下就都能被识别。
Hive导入CSV前检查服务器文件格式
服务器上的CSV文件质量参差不齐,直接导入经常报错,根据过往经验,下面这几类问题出现频率较高。
分隔符与编码问题
CSV文件的分隔符不一定都是逗号,有的系统导出用制表符(t),有的用分号(),还有的是管道符(),解决办法是在建表时指定分隔符:
ROW FORMAT DELIMITED FIELDS TERMINATED BY 't';
编码方面,如果文件是GBK编码,Hive默认按UTF-8解析,中文会变成乱码,处理方案有两个:一是先用iconv -f GBK -t UTF-8 原文件.csv > 新文件.csv转码,二是建表时加TBLPROPERTIES ("hive.exec.character.encoding"="GBK")
,但后者兼容性差,不推荐在生产环境用。
表头与字段类型不匹配
多数CSV文件第一行是标题,比如id,name,age,导入时Hive不会自动跳过表头,它会把这行当成普通数据,最省事的做法是用sed -i '1d' 文件名.csv删掉第一行再上传,如果不想动原始文件,建表时把第一个字段类型设为STRING,导入后跑一条DELETE FROM 表名 WHERE 字段1='id';把表头行清掉,但更建议前期就把文件处理好。
Hive加载本地CSV文件与HDFS路径的差异
很多人在导入时报错Unable to move source file,原因就是把本地路径和HDFS路径搞混了。
本地文件系统与HDFS路径的区分
LOAD DATA命令里有一个LOCAL关键字,就是用来区分来源路径的:
- 写
LOCAL:代表文件在服务器本地磁盘,比如/home/user/data/xxx.csv,Hive会先把文件上传到HDFS临时目录,再移动进表目录。 - 不写
LOCAL:代表文件已经存在HDFS上,路径是hdfs://namenode:8020/user/xxx.csv这种格式,Hive直接把文件挪进表目录。
判断该不该加LOCAL很简单:如果你在服务器上能直接ls到文件,就加LOCAL;如果要用hdfs dfs -ls才能看到,就不加。
数据落盘与副本机制的影响
本地文件加载到Hive后,数据实际存储在HDFS上,默认有三份副本,如果服务器磁盘空间紧张,建议加载完成后检查一下HDFS使用情况,必要时清理源文件,行业共识认为,HDFS的副本策略是保证数据可靠性的基础,不建议为了省空间随意调低副本数。
Hive表结构与CSV文件的字段映射技巧
CSV文件字段和Hive表字段的对应关系,决定了数据能否被正确解析,重点盯住下面几个环节。
字段顺序、分隔符与复杂类型的处理
字段顺序必须严格一致,如果CSV里第2列是日期,Hive表的第2个字段也要建为日期类型或STRING,错位会导致整行数据变成NULL,复杂类型如数组、Map在CSV里不好表示,通常做法是先以STRING导入,再用split()函数在查询时解析。
使用OpenCSVSerde处理带引号的字段
如果CSV的值本身包含逗号,比如"北京市,朝阳区",标准CSV会用双引号把整个字段包起来。默认的LazySimpleSerDe无法识别这种格式,必须改用OpenCSVSerde,上面建表语句里已经写了OpenCSVSerde的配置,这里补充说明:quoteChar指定引号字符,escapeChar指定转义字符,多数情况下用默认值即可。
大数据量CSV导入Hive时的性能优化
处理几百MB的CSV文件,按默认参数走就行,但当文件达到几个GB甚至几十GB,就需要调整策略。
文件大小与并行度的权衡
Hive导入的瓶颈通常在于文件个数而不是文件大小,一个1GB的文件拆成100个10MB的小文件,导入速度不一定更快,反而产生大量小文件,拖慢后续查询,多数情况下,把文件控制在128MB到256MB之间比较合理,可以使用hdfs dfs -getmerge先把多个小CSV合并成一个,再上传导入。
由于Hive自带数据倾斜问题,导入时如果某些字段值分布极不均衡,会拖慢后续GROUP BY查询,解决方案是建表时用CLUSTERED BY(某字段) INTO 20 BUCKETS做分桶,但分桶数量要根据数据量和集群规模灵活调整。
分区表导入减少全表扫描
业务场景下,日志类CSV文件通常带上日期字段,建表时建议做成分区表:
CREATE TABLE 日志表 (
  user_id STRING,
  action STRING
)
PARTITIONED BY (dt STRING);
导入时手动指定分区:
LOAD DATA INPATH '/data/xxx.csv' INTO TABLE 日志表 PARTITION (dt='2026-03-01');
这样后续查询按dt过滤时,Hive只扫描对应分区,速度提升明显,业内专家指出,分区设计是Hive性能优化的第一优先级,比调整各种参数更有效。
服务器CSV导入Hive常见的报错排错
下面几个报错信息大家在日常维护中常会遇到,处理思路基本固定。
字段数量不一致导致数据丢失
报错日志显示HiveIgnoreKeyTextOutputFormat或某行只有前几个字段有值、后面全是NULL,通常是CSV文件里有空行或某行数据少了几列,处理办法:用awk -F',' 'NF!=期望列数{print NR}' 文件名找出问题行,修复后再导入。
文件格式与SerDe不匹配
报错Expected: 5, Found: 3这种提示,说明Hive按指定分隔符解析时,某行切分出的列数和表字段数不一致,此时检查两点:是否混用了分隔符,是否字段值里包含分隔符但没加引号。
权限不足导致LOAD DATA失败
Permission denied错误,需要确认Hive服务的运行用户对源文件所在目录有读写权限,对目标表目录有写权限,可以用hdfs dfs -chmod -R 777 /data/csv路径临时放开权限,但生产环境建议按最小权限原则配置。
Hive导入CSV与不同工具的对比
除了原生命令,业界经常用Sqoop、DataX、Spark SQL来导入CSV,下面从使用场景和难度做个直观对比。
| 工具 | 适用场景 | 操作难度 | 性能表现 |
|---|---|---|---|
| Hive LOAD DATA | 文件已在HDFS或服务器本地 | 低,走SQL即可 | 中,受限于文件移动速度 |
| 外部表 | 文件频繁更新、需保留原路径 | 极低,建表即用 | 高,查询实时读文件 |
| Spark SQL | 复杂ETL清洗后导入 | 较高,需写代码 | 高,分布式内存计算 |
| DataX | 异构数据源同步 | 中,写JSON配置 | 高,走并发通道 |
结论很直接:如果只是导入CSV后做简单分析,用Hive原生方式最省事,如果CSV需要清洗、关联其他表再导入,Spark SQL是主流选择。
服务器CSV文件导入Hive的基础操作流程总结
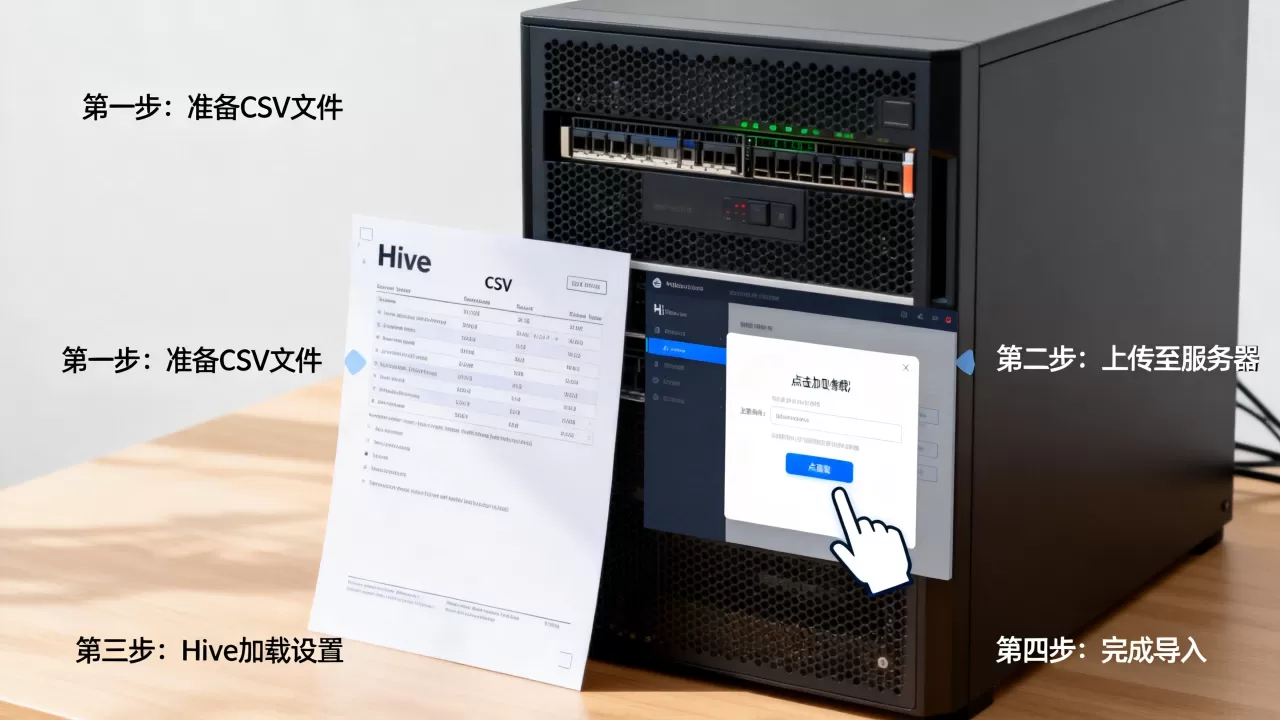
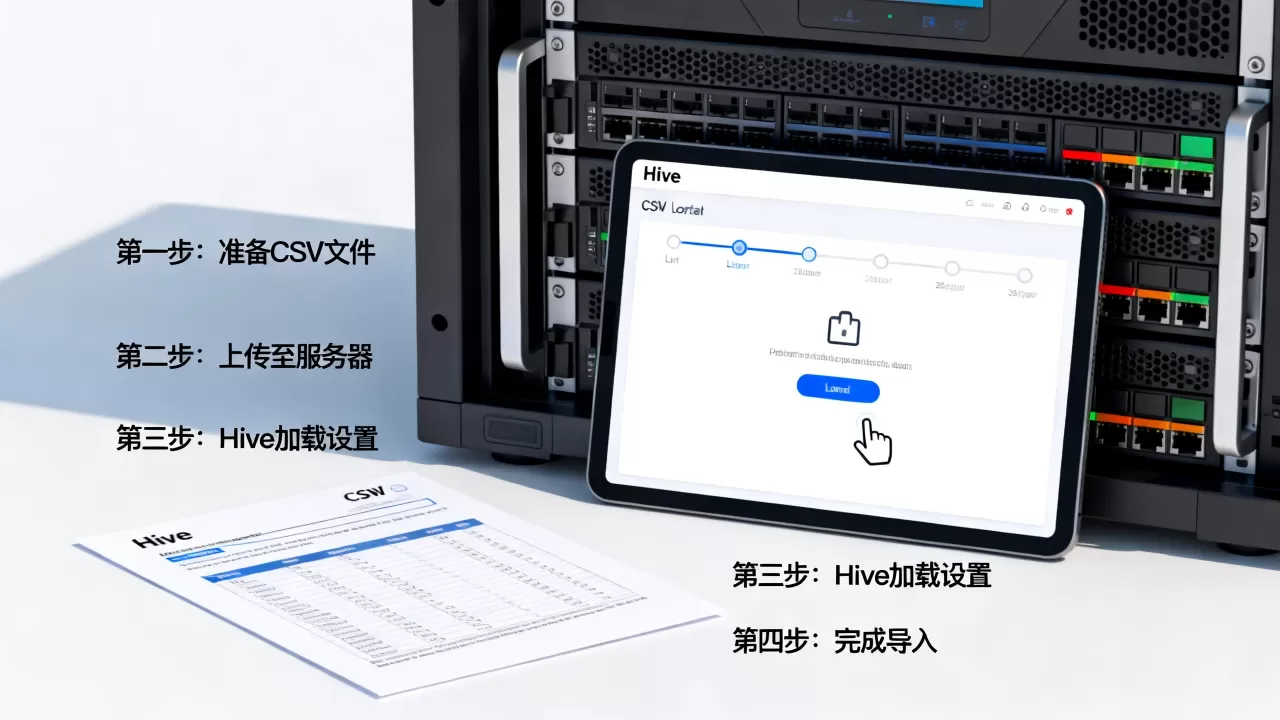
整体操作链路可以归纳为五步:
- 检查CSV文件:确认分隔符(或
t)、编码(UTF-8或转码)、表头行。 - 上传文件到目标位置:本地加载直接指向服务器路径,HDFS加载先执行
hdfs dfs -put 本地文件 /目标目录。 - 创建Hive表:字段类型对应CSV列,指定
ROW FORMAT SERDE或ROW FORMAT DELIMITED。 - 执行LOAD DATA语句:本地文件加
LOCAL,HDFS文件不加,需要追加数据用追加模式。 - 校验数据:比对行数、抽样字段、确认无NULL异常。
追加数据需要注意:LOAD DATA默认是追加模式,如果表里已有数据,新导入的文件追加到末尾,要覆盖旧数据,先TRUNCATE TABLE 表名;再导入。
常见问题解答
Hive导入CSV文件乱码怎么解决?
先确认CSV文件本身的编码格式,服务器上用file 文件名查看得到编码信息,如果是GBK,用iconv -f GBK -t UTF-8转码后再导入,如果已经是UTF-8还乱码,检查Hive是否设置了--hiveconf hive.exec.default.charset=UTF-8,以及客户端连接工具的字符集是否一致。
为什么LOAD DATA导入很慢?
常见原因有:文件并发写入产生大量小文件,HDFS NameNode处理元数据压力大;集群节点数过少或资源队列繁忙,先把文件合并成少量大文件,再错峰导入,如果还不够快,考虑用Spark SQL的write.mode("append").csv()方式替代LOAD DATA,并行度可控且速度更快。
如何在现有CSV数据上增加新数据而不是覆盖?
直接用LOAD DATA追加即可,表请勿使用OVERWRITE关键字,如果源CSV文件结构和目标表完全兼容,执行LOAD DATA就会自动追加,若是不想保留历史数据,才考虑INSERT OVERWRITE TABLE 表名 SELECT FROM ...这种覆盖方式,追加后建议立即执行ANALYZE TABLE 表名 COMPUTE STATISTICS更新表的统计信息,让优化器有准确的数据分布做执行计划。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/%e5%a6%82%e4%bd%95%e5%b0%86%e6%9c%8d%e5%8a%a1%e5%99%a8csv%e5%af%bc%e5%85%a5hive%ef%bc%8chive%e5%8a%a0%e8%bd%bdcsv%e6%96%87%e4%bb%b6%e6%ad%a5%e9%aa%a4%ef%bc%9f/