使用Docker部署Ollama是目前最稳定且隔离性最好的本地大模型运行方案,它通过容器化技术解决了环境依赖冲突问题,让非技术用户也能在Linux或Windows上快速跑通LLM。
在本地搭建大语言模型时,开发者往往会被繁琐的环境配置劝退,Python版本冲突、CUDA驱动不匹配、系统库缺失,这些坑足以让项目停滞数天,Docker的出现彻底改变了这一局面,它将Ollama及其运行依赖打包成一个独立的镜像,无论宿主机是什么环境,只要安装了Docker引擎,就能获得一致的运行体验,这种“一次构建,到处运行”的特性,不仅降低了入门门槛,更提升了生产环境下的稳定性,对于寻求Ollama docker部署教程掌握这一流程意味着拥有了随时切换模型、快速回滚版本的主动权。
Docker环境准备与基础配置
在开始部署之前,确保你的服务器或本地机器已经就绪是至关重要的第一步,很多新手忽略这一步,导致后续拉取镜像或启动容器时出现各种玄学错误,业内专家指出,稳定的网络环境和正确的权限管理是成功部署的前提。
安装Docker引擎
不同操作系统安装Docker的方式略有差异,但核心逻辑一致,对于Ubuntu或Debian用户,官方提供的脚本最为便捷,你需要打开终端,执行以下命令来安装Docker CE(社区版)。
sudo apt-get update
sudo apt-get install ca-certificates curl gnupg
sudo install -m 0755 -d /etc/apt/keyrings
curl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo gpg --dearmor -o /etc/apt/keyrings/docker.gpg
echo "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/keyrings/docker.gpg] https://download.docker.com/linux/ubuntu $(. /etc/os-release && echo "$VERSION_CODENAME") stable" | sudo tee /etc/apt/sources.list.d/docker.list > /dev/null
sudo apt-get update
sudo apt-get install docker-ce docker-ce-cli containerd.io docker-buildx-plugin docker-compose-plugin
安装完成后,务必验证安装是否成功,运行docker --version和docker compose version,如果返回了版本号,说明环境已就绪,对于Windows或macOS用户,直接下载Docker Desktop安装包即可,它内置了Linux内核支持,无需额外配置WSL2底层逻辑,这对
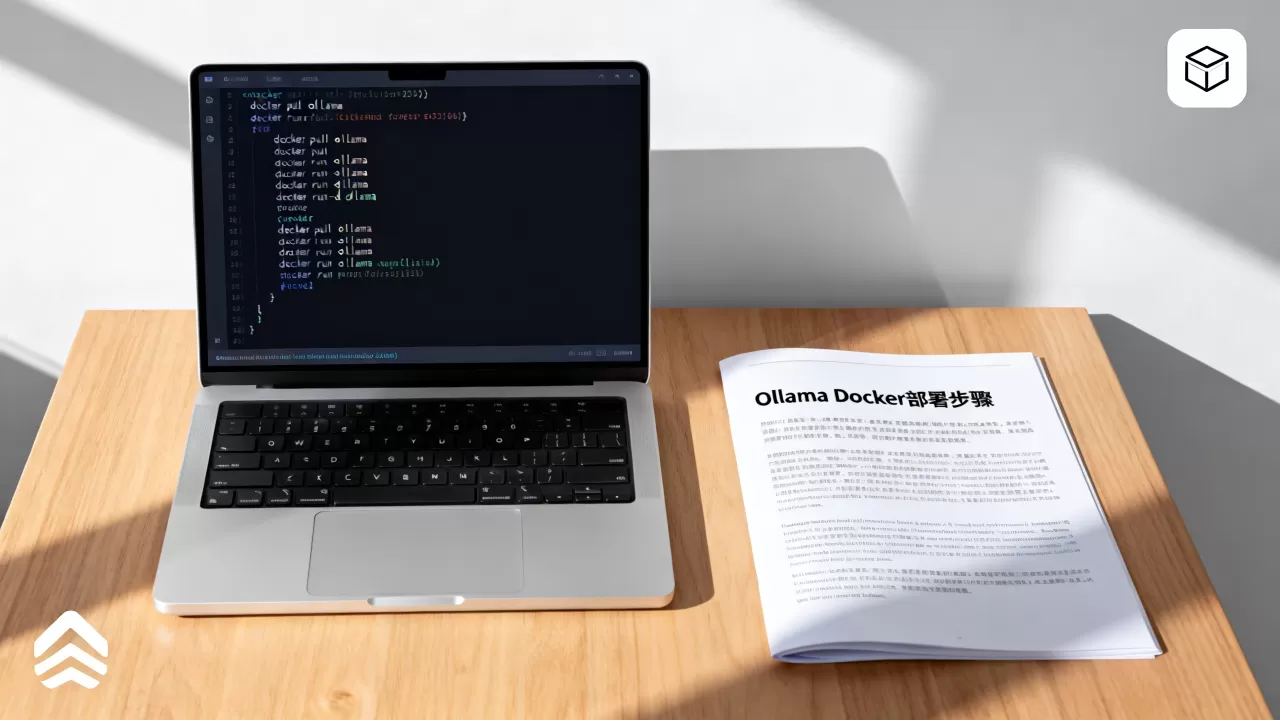
Ollama在Windows下怎么运行提供了极大便利。
配置NVIDIA GPU支持
Ollama的核心优势在于利用GPU加速推理,如果你的机器配备NVIDIA显卡,必须安装NVIDIA Container Toolkit,否则容器无法访问GPU硬件,这是许多用户遇到“模型加载极慢”或“显存无法识别”的根本原因。
在Linux系统上,执行以下命令安装驱动支持:
distribution=$(. /etc/os-release;echo $ID$VERSION_ID)
curl -fsSL https://nvidia.github.io/libnvidia-container/gpgkey | sudo gpg --dearmor -o /usr/share/keyrings/nvidia-container-toolkit-keyring.gpg
curl -s -L https://nvidia.github.io/libnvidia-container/$distribution/libnvidia-container.list | sed 's#deb https://#deb [signed-by=/usr/share/keyrings/nvidia-container-toolkit-keyring.gpg] https://#g' | sudo tee /etc/apt/sources.list.d/nvidia-container-toolkit.list
sudo apt-get update
sudo apt-get install -y nvidia-container-toolkit
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker
重启Docker服务后,运行docker run --rm --gpus all nvidia/cuda:12.2.0-base-ubuntu22.04 nvidia-smi,如果能看到显卡信息列表,说明GPU直通配置成功,这一步至关重要,它决定了你的Ollama是仅靠CPU“硬算”,还是调用GPU“加速跑”。
核心部署步骤与模型拉取
环境准备好后,真正的部署过程其实非常简洁,Ollama官方提供了现成的Docker镜像,你不需要自己编写Dockerfile,只需一条命令即可启动服务,这种极简主义设计符合现代DevOps的最佳实践。
启动Ollama容器
推荐使用docker run命令直接启动容器,为了持久化保存下载的模型,你需要将宿主机的目录挂载到容器内的/root/.ollama路径,这样,即使容器被删除或重建,你下载的Llama 3、Mistral等模型也不会丢失。
假设你将模型存储路径设为/home/user/ollama,执行以下命令:
docker run -d -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollama
这里有几个关键参数需要解析:
-d:后台运行容器,释放终端。-v ollama:/root/.ollama:使用Docker Volume挂载数据卷,实现数据持久化。-p 11434:11434:将宿主机的11434端口映射到容器的11434端口,这是Ollama默认API端口。--gpus all:如果你需要GPU加速,必须加上此参数,否则容器将忽略显卡资源。
启动后,使用docker ps查看容器状态,如果状态为Up,说明服务已正常运行,你可以在浏览器访问http://localhost:11434,虽然页面可能为空,但API接口已就绪。
模型管理与交互
容器启动后,你可以通过docker exec命令进入容器内部,或者直接在宿主机通过API进行交互,对于普通用户,直接在宿主机终端使用ollama命令是最直观的方式,但请注意,如果Ollama是以Docker形式运行,你需要确保环境变量OLLAMA_HOST指向容器IP,或者直接使用curl命令调用API。
拉取并运行Llama 3模型:
# 进入容器内部执行(推荐,环境一致)
docker exec -it ollama ollama run llama3
# 或者在宿主机通过API调用
curl http://localhost:11434/api/generate -d '{
  "model": "llama3",
  "prompt": "为什么天空是蓝色的?",
  "stream": false
}'
模型文件默认存储在挂载的数据卷中,你可以通过docker volume ls查看卷信息,并使用docker volume inspect ollama查看具体路径,这种分离存储的方式,使得模型管理变得极其灵活,你可以轻松备份整个模型库,或者在不同服务器间迁移模型。
性能优化与常见问题排查
部署成功只是开始,如何让它跑得更快、更稳,才是体现技术水平的地方,许多用户反馈部署后模型加载慢或响应延迟,这通常与资源分配和配置有关。
资源限制与并发控制
Ollama在Docker中运行默认会占用较多内存,为了防止容器耗尽主机内存导致系统崩溃,建议在启动时添加资源限制参数,限制最大内存使用量为8GB:
docker run -d -v ollama:/root/.ollama -p 11434:11434 --gpus all --memory=8g --name ollama ollama/ollama
Ollama支持多模型并发加载,你可以通过设置环境变量OLLAMA_NUM_PARALLEL来调整并发请求数,默认值为1,对于多用户场景,建议设置为2或4,以提升吞吐量。
常见错误与解决方案
在实际操作中,你可能会遇到一些典型问题,以下是基于大量用户反馈总结的排查指南:
-
错误:Connection refused
- 原因:容器未启动或端口未映射。
- 解决:检查
docker ps,确保容器状态为Up,并确认防火墙未拦截11434端口。
-
错误:Out of Memory (OOM)
- 原因:模型过大,显存或内存不足。
- 解决:尝试使用量化版本较小的模型(如Q4_K_M),或增加容器内存限制,对于显存不足,确保NVIDIA驱动和Container Toolkit正确安装。
-
错误:模型下载失败
- 原因:网络问题或DNS解析失败。
- 解决:检查网络连通性,或配置Docker代理,在国内环境下,使用镜像源加速下载是常见做法。
总结与最佳实践建议
通过Docker部署Ollama,不仅解决了环境依赖的痛点,更为后续的模型迭代和维护提供了标准化基础,它让本地大模型的应用从“极客玩具”变成了“可用工具”。
对于企业用户或高级开发者,建议将Ollama容器纳入Kubernetes集群管理,实现自动扩缩容和高可用部署,对于个人用户,保持Docker镜像更新,定期备份模型数据卷,是保障服务稳定性的关键。
随着大模型技术的普及,Ollama docker部署教程的需求将持续增长,掌握这一技能,意味着你拥有了在本地构建私有AI助手、开发智能应用的基础能力,无需担心环境差异,无需纠结依赖冲突,只需一条命令,即可开启你的本地AI之旅,这种简洁、高效、可控的部署方式,正是Ollama能够迅速在开发者社区中流行起来的核心原因。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/%e5%a6%82%e4%bd%95%e7%94%a8docker%e9%83%a8%e7%bd%b2ollama%ef%bc%9follama-docker%e9%83%a8%e7%bd%b2%e6%95%99%e7%a8%8b/