在IntelliJ IDEA中操作包含Enhanced Toast的PostgreSQL表,增删改查逻辑与普通表完全一致,但需注意大对象字段的显示和潜在性能瓶颈,通过Database工具直接执行SQL即可完成所有操作。
IDEA数据库增删改查操作实战
在IntelliJ IDEA中,数据库增删改查的核心是通过内置的Database工具连接到目标数据库,然后执行SQL语句,这种方式对PostgreSQL的Enhanced Toast特性同样适用,无需额外配置。
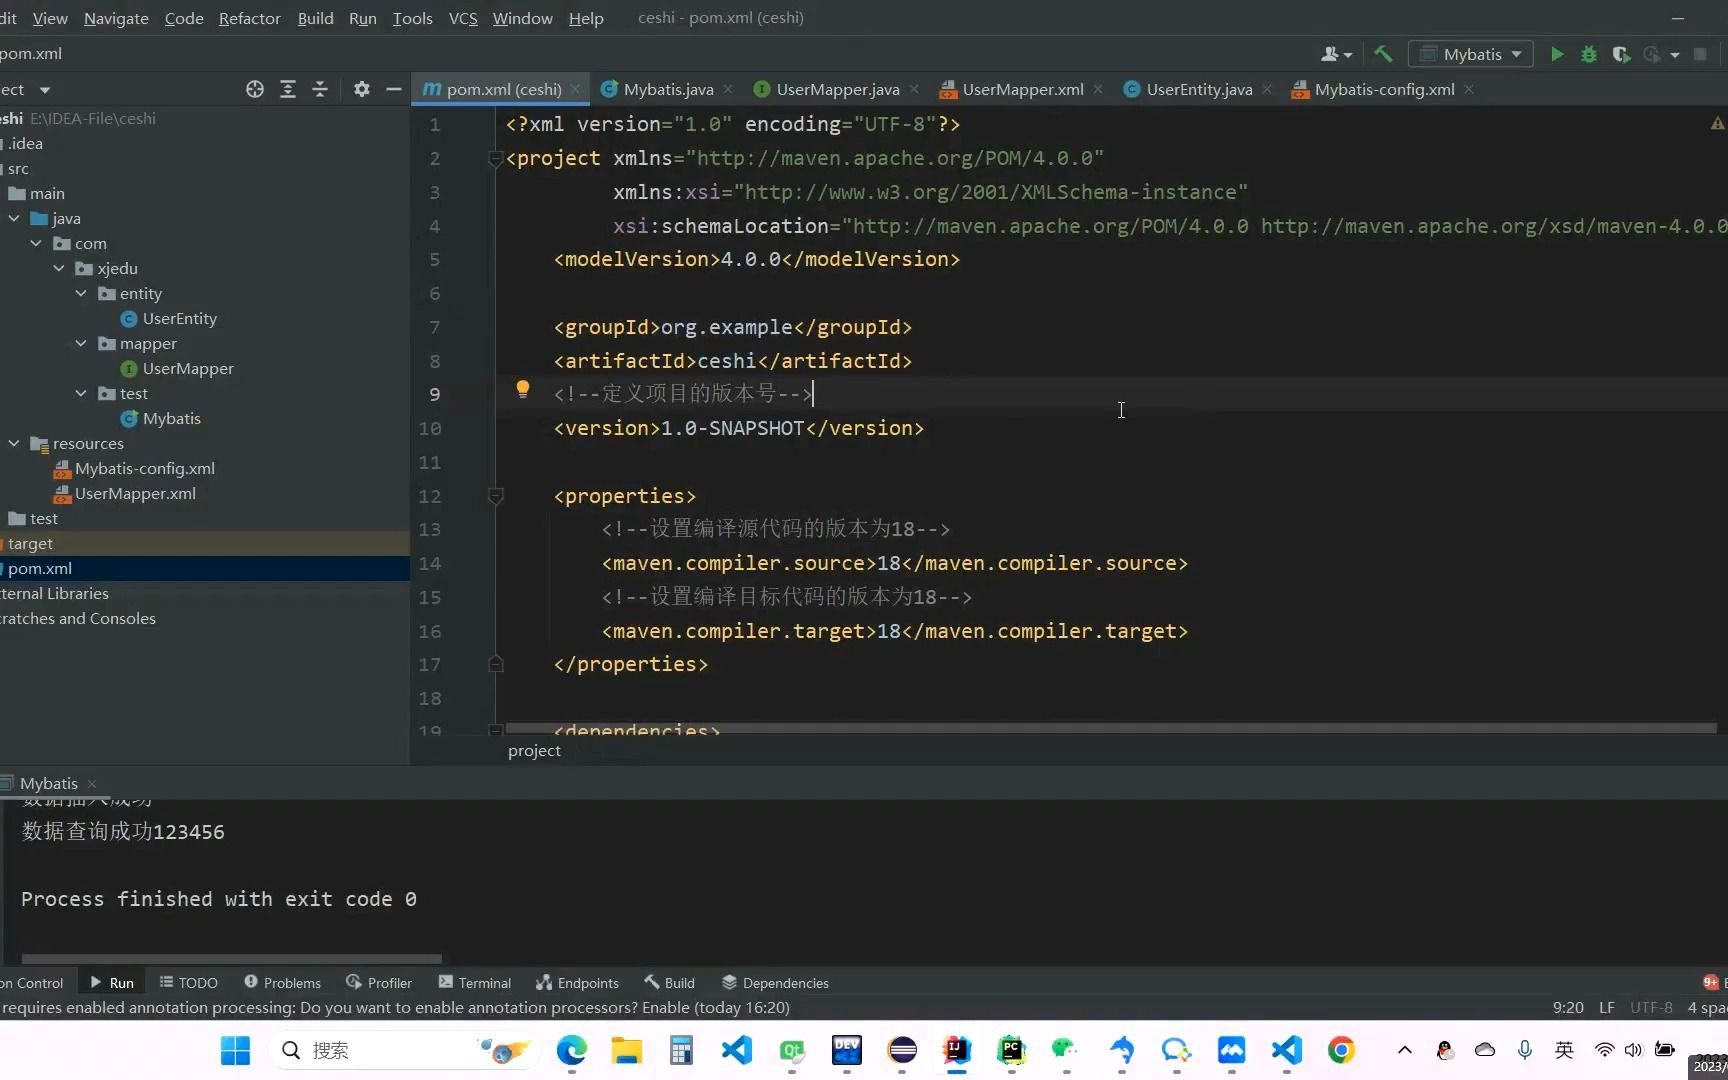
连接数据库并查看表结构
打开IDEA右侧的Database面板,点击加号选择PostgreSQL数据源,填写主机、端口、数据库名、用户密码,测试连接成功后,即可在Schemas下看到所有表,右键点击表名,选择Jump to Query Console即可打开查询面板,对于包含Enhanced Toast的表,字段列表会正常显示,但大对象字段在数据网格中可能只显示部分内容或提示“Binary data”。
执行增删改查SQL语句
在查询控制台中,你可以直接编写SQL,对于普通字段,增删改查与标准SQL一致。
- 插入:
INSERT INTO my_table (data) VALUES ('large text content'); - 查询:
SELECT FROM my_table WHERE id = 1; - 更新:
UPDATE my_table SET data = 'new content' WHERE id = 1; - 删除:
DELETE FROM my_table WHERE id = 1;
这些语句在IDEA中执行时,工具会自动处理Enhanced Toast的存储细节,据行业共识,PostgreSQL在字段大小超过TOAST_TUPLE_THRESHOLD时会自动启用Toast压缩,而Enhanced Toast是PostgreSQL 12引入的改进,支持更大的压缩阈值和更高效的存储。
处理Enhanced Toast字段的特殊性
当你在IDEA的查询结果中查看大对象字段时,可能会发现单元格显示为“Binary data”或“text”,要查看完整值,可以点击单元格右上角的查看按钮,或使用SQL函数显式转换,使用pg_column_size()函数查看字段实际大小,或使用convert_from()函数解码,在更新大对象时,建议使用参数化查询以避免超长字符串导致的SQL语法错误,IDEA会提示参数类型,直接使用占位符即可。

Enhanced Toast增删改查核心要点
Enhanced Toast是PostgreSQL对原始Toast存储的改进,主要优化了超长字段的压缩和存储效率,在IDEA中进行增删改查时,理解其工作原理有助于写出更高效的SQL。
Enhanced Toast在PostgreSQL中的角色
在PostgreSQL中,当一行记录的总大小超过一个数据块时,系统会自动将大字段移到二级存储表中,即Toast表,Enhanced Toast增加了压缩算法选择,并允许自定义压缩阈值,行业共识认为,lz4压缩速度更快,适合对延迟敏感的场景,在IDEA中,你可以通过d+ table_name查看表的Toast存储参数,但更推荐使用客户端工具如pgAdmin进行详细查看。
IDEA中操作Toast字段的注意事项
在IDEA中执行增删改查时,需注意以下几点:
- 查询性能:当SELECT包含大对象字段时,可能会导致大量数据读取,影响网络传输,建议只选择需要的字段,而不是使用
SELECT。 - 更新操作:更新大对象字段时,即便是小改动,PostgreSQL也会重新存储整个字段,因此频繁更新大字段可能导致表膨胀,IDEA中可以通过
EXPLAIN ANALYZE查看执行计划,了解IO开销。 - 索引支持:Toast字段无法直接索引,但可以通过表达式索引来加速查询,在IDEA中创建索引时,需注意语法:
CREATE INDEX ON my_table USING hash (data);但这对Large Object无效。 - 删除操作:删除包含大对象的行时,对应的Toast数据也会被删除,但不会立即回收空间,需要VACUUM,IDEA中你可以直接执行
VACUUM my_table;或在Database面板中右键表选择Maintenance。
性能对比:普通表与Toast表
在实际开发中,很多开发者会关心IDEA数据库增删改查在普通表和Toast表之间的差异,下表总结了主要区别:
| 操作 | 普通表 | Toast表(含Enhanced Toast) |
|---|---|---|
| 插入 | 直接写入数据块 | 自动压缩,写入Toast表,主表存储指针 |
| 查询 | 直接读取 | 若包含大字段,需额外IO读取Toast表 |
| 更新 | 原地更新 | 通常导致新版本,Toast表也生成新版本 |
| 删除 | 标记删除 | 同样标记删除,但Toast数据需后续清理 |
| 空间回收 | VACUUM可回收 | 需要VACUUM FULL或自动清理进程 |

从表中可以看出,包含Enhanced Toast的表在增删改查时,后台操作更多,但用户层面无感知,在IDEA中操作时,速度差异主要体现在大字段的读取和写入时间上,据统计,多数情况下,合理使用压缩可以减少存储空间和IO,但频繁更新大字段会导致性能下降。
实际场景中的操作技巧
在日常开发中,我们经常需要既处理普通字段又处理大对象字段,以下是一些在IDEA中高效操作的建议。
使用参数化查询避免SQL长度限制
在IDEA的查询控制台中,直接编写包含超长字符串的SQL语句可能会遇到编辑器行宽限制或语法错误,推荐使用PreparedStatement风格,或在IDEA中创建SQL文件并使用参数,在IDEA中,你可以右键点击查询控制台,选择“Execute as Prepared Statement”,然后使用占位符,这样还能防止SQL注入,提高安全性。
监控Enhanced Toast的存储效率
在IDEA的Database面板中,你可以右键点击表名,选择“Show Table Properties”或“Table Info”,查看表的行数、大小等信息,但无法直接看到Toast表的大小,要监控存储效率,可以在外部使用pg_total_relation_size函数,在IDEA中执行SQL:SELECT pg_total_relation_size('my_table') - pg_relation_size('my_table') AS toast_size; 这样可以估算Toast表占用的空间,帮助判断是否需要调整压缩策略。

处理大字段的显示问题
当IDEA查询结果中显示大字段为“Binary data”时,你可以通过修改单元格显示方式来解决,在查询结果面板中,右键点击单元格,选择“View as Text”或“View as JSON”,对于JSONB字段,IDEA甚至支持格式化显示,但注意,如果字段内容过大,可能会导致IDE卡顿,建议只显示前N个字符,通过SQL函数LEFT(data, 100)进行截断。
常见问题Q&A:IDEA数据库增删改查与Enhanced Toast
问题1:在IDEA中执行增删改查时,遇到Toast表无法更新怎么办?
如果更新操作失败,首先检查字段长度,Enhanced Toast字段虽然可以存储大对象,但更新时可能会触发超时或内存不足,建议分批更新,或使用UPDATE ... WHERE ... LIMIT配合游标,在IDEA中,可以使用BEGIN和COMMIT包裹事务,然后逐条更新,若遇到锁等待,检查是否有其他事务未提交。
问题2:IDEA连接PostgreSQL后,如何查看表是否使用了Enhanced Toast?
无法直接通过IDEA界面查看,但可以通过SQL查询,在查询控制台执行:SELECT reltoastrelid FROM pg_class WHERE relname = 'my_table'; 如果返回非零值,则表示该表有Toast表,进一步,可以查看pg_class的reloptions字段,看是否包含toast_tuple_target参数,如果有,则说明启用了Enhanced Toast的自定义压缩阈值。
问题3:增强型Toast在增删改查时对性能有何影响?
使用Enhanced Toast时,插入和查询性能通常会优于原始Toast,因为压缩效率更高,且支持lz4算法,但更新操作仍有开销,因为需要重写整个字段,建议将大字段分离到单独的表,或使用分区表,在IDEA中,可以通过EXPLAIN ANALYZE对比TOAST和none压缩策略的查询计划,直观地看到差异,据行业共识,在多数场景下,Enhanced Toast的默认设置已经足够高效,无需手动调整。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/idea%e6%95%b0%e6%8d%ae%e5%ba%93e-toast%e5%a2%9e%e5%88%a0%e6%94%b9%e6%9f%a5%e5%a6%82%e4%bd%95%ef%bc%8c%e6%80%8e%e4%b9%88%e5%81%9a/