存储与计算分离架构在训练场景的落地,核心结论是:训练阶段越靠近“数据准备”和“模型保存”,存储与计算分离的价值越大;越靠近“微批次计算”,本地缓存越必要,主流做法是构建“远端大容量共享存储+近端高速缓存”的混合架构。
这套架构不是非此即彼的选择题,训练任务的数据流存在明显的冷热分层:热数据是当前迭代正在读取的样本,要求极低延迟;温数据是当前Epoch需要遍历的数据集,要求高吞吐;冷数据是历史检查点、日志和归档数据集,要求大容量和高可靠,用一套存储打天下,要么GPU等数据,要么存储资源严重浪费。


存储与计算分离和存储计算一体,训练场景怎么选
这个问题在社区里争论了很长时间,存储计算一体听起来很美好,数据本地读,不经过网络,延迟最短,但真实训练场景里,一体架构会遇到两个绕不开的坎。
数据局部性与GPU利用率打架
一体架构下,训练样本按批次分发到各节点的本地磁盘,看起来每个节点只读自己的盘,但数据集的规模增长往往比节点扩容更快,当某个GPU节点因为故障或调度原因掉出集群,它本地那部分数据就变成孤儿,要么等节点恢复,要么重新洗牌分发,行业共识认为,大规模训练集群的季度故障率在2%到4%区间,这种数据迁移的代价相当可观,更常见的场景是多个实验并行跑,每个实验都要遍历完整数据集,一体架构下数据集要复制N份,存储利用率直线下降。
分离架构的本质是数据管道解耦
存储与计算分离把“数据住在哪”和“算力跑在哪”彻底拆开,训练节点不再挂载超大容量本地盘,只保留系统盘和少量SSD做缓存,数据统一从远端存储拉取。这种架构的收益不是单次读取变快,而是让存储和计算可以独立扩缩容,数据量暴涨时,只扩存储节点;算力紧张时,只加GPU节点,谁也不用迁就谁。
性能对比的真相
| 维度 | 存储计算一体 | 存储计算分离(含缓存) |
|---|---|---|
| 单次读取延迟 | 低(本地盘) | 中(网络+缓存命中) |
| 大规模数据扩展性 | 差(需复制分发) | 好(共享存储) |
| 多任务并发 | 冲突严重(抢本地IO) | 顺滑(共享带宽池) |
| 资源利用率 | 波动大 | 相对平稳 |
| 运维复杂度 | 低(但扩容难受) | 中(多一层网络调优) |
这里的对比有一个前提:分离架构必须搭配近端缓存,裸奔式的读远端存储,小文件场景会把你逼疯,业内专家指出,没有缓存层的纯分离架构,在随机小文件读取场景下,性能可能比本地盘慢一个数量级。
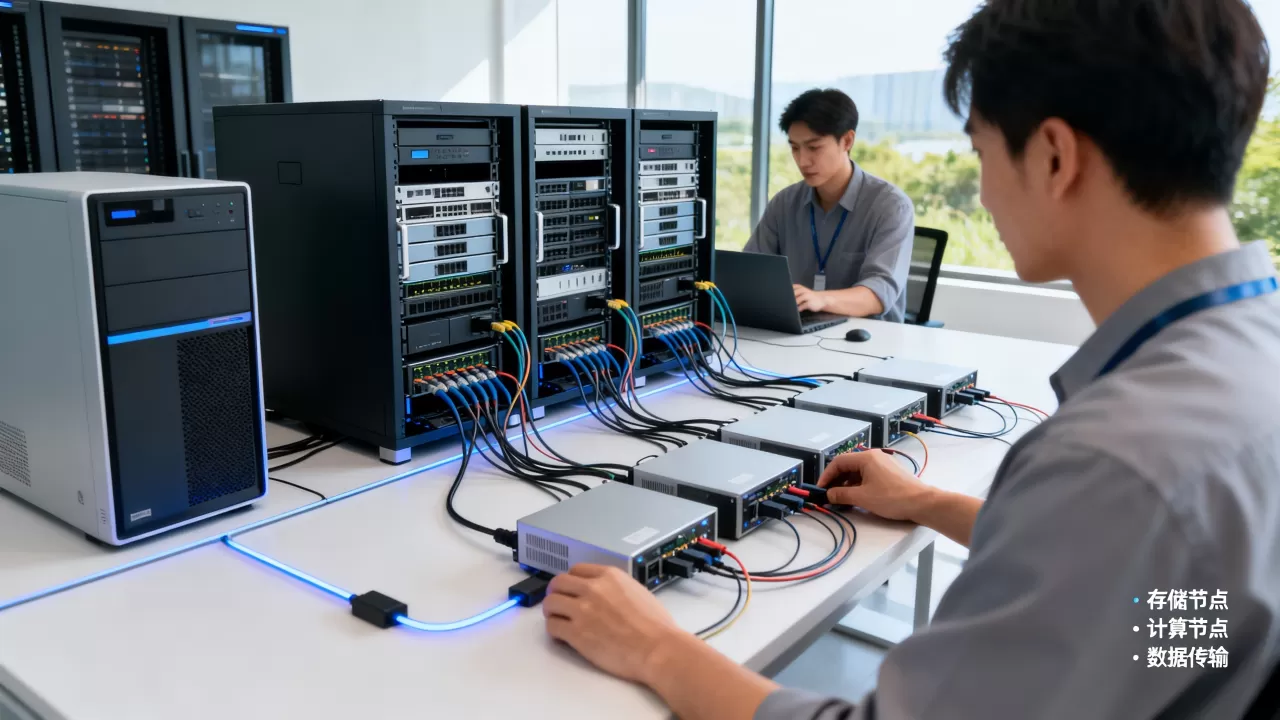
训练场景中存储与计算分离架构如何落地
落地不是买一套分布式存储挂上去就完事,结合真实踩坑经验,完整路径包含五个阶段。
第一步:梳理数据访问画像
在动手前,先用监控工具摸清训练任务的数据访问规律,需要关注三个指标:文件平均大小、顺序读占比、重复读频率,如果你的数据集以几MB到几百MB的大文件为主,且每个Epoch都要完整读一遍,分离架构会很顺手,如果数据是几KB的小文件,且随机读占比高,你得先做文件合并的预处理。
第二步:选定共享存储方案
训练场景的共享存储基本在以下三条路线里选:
- 分布式文件存储:如Lustre、GPFS、CephFS,适合超大规模集群,带宽和元数据性能都要单独调优
- 对象存储挂载:如MinIO、Ceph RGW,靠FUSE或S3客户端桥接,成本低但延迟偏高,适合冷数据
- 并行文件系统:如BeeGFS、GlusterFS,部署轻量,中等规模集群的热门选择
选择标准不是“哪个好”,而是“你的训练任务吃带宽还是吃IOPS”,吃带宽的大文件场景,对象存储挂载就能扛;吃IOPS的小文件场景,老老实实上并行文件系统。
第三步:打造近端缓存层
这是落地成败的分水岭,没有缓存的分离架构,在训练任务里几乎不可能跑出好性能,缓存层有两种主流形态:
- 节点级本地缓存:每个GPU节点挂几块NVMe SSD,通过缓存组件(如JuiceFS的本地缓存、Alluxio的worker)自动管理,读过的数据块留在本地
- 分布式缓存集群:单独部署一组带大容量SSD的缓存节点,所有训练节点共享,适合数据集收敛到几十TB级别的场景
实操建议:先用节点级缓存跑通流程,当缓存命中率稳定在80%以上后,再考虑是否升级为分布式缓存集群,多数场景下,节点级缓存加上足够的数据预取(Prefetch),已经能把存储延迟对GPU利用率的影响压制到很小。
第四步:改造数据加载管道
存储层解决的是“数据能不能快速拿到”,但“拿到后怎么喂给GPU”是另一个坑,训练框架的DataLoader需要针对远端存储做专门调优:
- 调大prefetch因子,让数据加载管线保持“永远有货”的状态
- 开启多进程读取,用CPU核数换IO吞吐
- 使用缓存友好的数据格式(如TFRecord、WebDataset、Mosaic),避免训练过程中碎片化读文件
- 设置合理的超时和重试机制,远端存储的网络闪断必须被消化在加载层
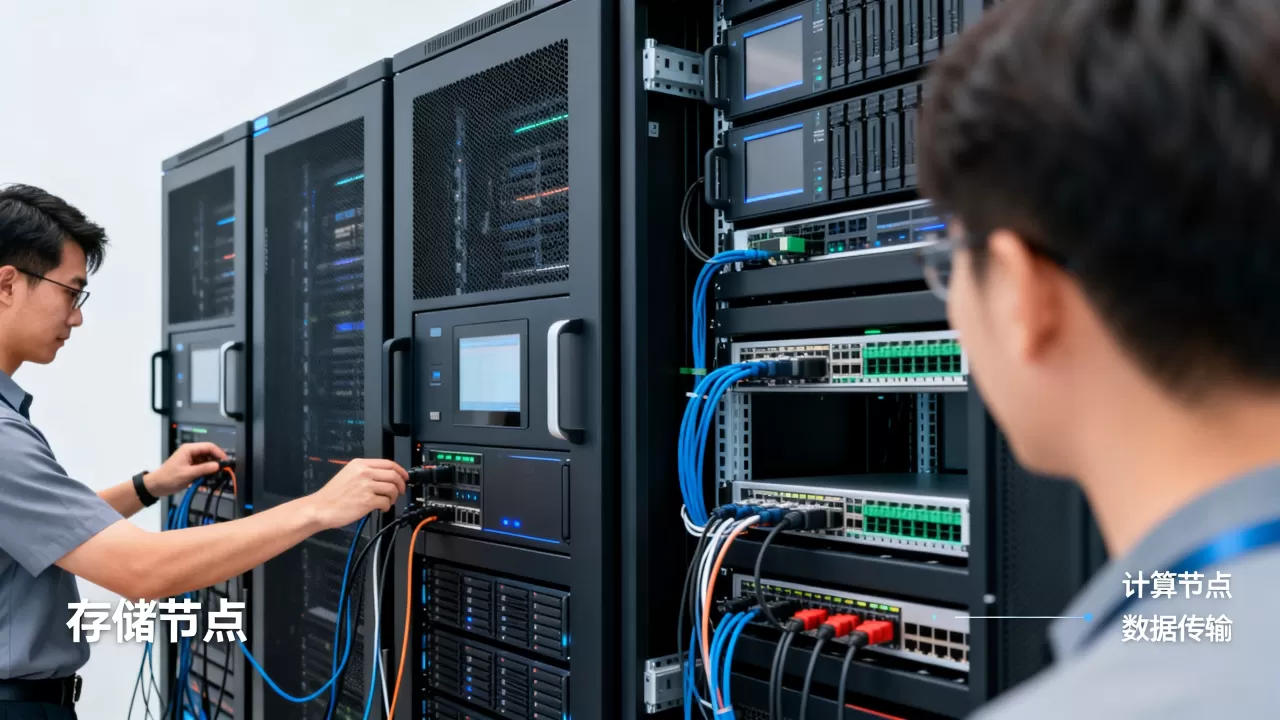
第五步:检查点与恢复机制改造
训练检查点的写入和读取,是存储计算分离架构里最容易被低估的环节,模型参数从单卡几GB到多卡几百GB不等,每N步存一次,写得不合理会直接拖垮训练进度,落地方案:
- 检查点写入先落本地临时盘,异步转储到远端共享存储
- 恢复时支持“懒加载”模式,先拉起训练进程,后台流式拉取权重
- 多卡并行保存时,按张量分片写入,避免所有卡同时写一个大文件造成带宽争抢
深度学习训练存储性能优化的真实瓶颈排查
即便架构搭好了,日常训练中还是会遇到莫名其妙的慢,以下排查路径按优先级排序,遇到“GPU利用率上不去”或“训练速度波动大”时依次检查。
看数据加载时长占比
训练日志里加上一个埋点:统计每个step的总耗时,拆出“CPU准备数据耗时”和“GPU计算耗时”。如果数据准备占比超过20%,存储或数据管道大概率有瓶颈,正常状态下,这个占比应该控制在个位数。
盯住缓存命中率曲线
缓存命中率不是恒定值,数据集大、Epoch轮次少,每次都是冷读,命中率自然低,合理预期是:前几个Epoch命中率爬坡,后续稳定在高位,如果命中率长期低于60%,要么缓存容量配小了,要么数据预处理逻辑有缺陷导致每次读的Key都不同。
实测真实带宽而非标称值
不要相信存储厂商给的顺序读带宽数字,那是用大块连续IO跑出来的“实验室数据”,模拟训练负载打一下,比如用fio跑4K随机读和1MB顺序读的混合场景,看看实际延迟和吞吐。
排查网络拓扑热点
分离架构下,网络是命脉,常见问题是多个计算节点同时读取同一存储节点的数据,形成热点,检查存储节点的网卡流量、交换机端口拥塞情况,存储和计算的网络最好独立规划,别跟参数同步的RDMA网络混在一起抢带宽。
存储与计算分离部署成本与常见误区
成本算不清、误区踩不完,是这架构落地时最常见的两个问题。
成本不只算存储单价
一个常见误区是拿“存储每TB单价”和本地盘比价,分离架构的真实成本构成包括:共享存储本身的费用、网络带宽费用(跨交换机流量费)、缓存设备的采购,存储的运维人力、扩容规划和技术支持也要折算进去,在训练任务自身的硬件支出面前,存储通常只占
10%到15%,多花这一部分钱换取GPU利用率提升,多数时候是划算的。
存储越分布式越好
有些人喜欢把存储节点堆到几十个,觉得“分布式嘛,节点多肯定快”,事实上元数据服务器的压力、网络拓扑的复杂度、数据均衡的成本都会随节点数上升。先算清训练任务的带宽峰值,按需定节点数,比无脑堆节点有效得多。
缓存容量越大越好
缓存容量和命中率不是线性关系,数据集是百TB级,你上几十TB缓存也没用,命中率同样上不去,合理的做法是缓存容量对齐“一个Epoch内频繁访问的热数据子集大小”,比如一个训练Session里反复使用的那部分增强后的数据。
全链路SSD就是最优解
SSD快,但贵,混合分层更实际:热数据落在NVMe SSD缓存,温数据放在SATA SSD或HDD组成的并行文件系统里,冷数据丢到对象存储,这套层级的组合,兼顾了性能和总体拥有成本。
存储与计算分离在训练场景里是标准答案,但前提是设计好缓存层和网络规划。 先把数据访问特征摸透,选合适的共享存储,再把缓存命中和数据预取做扎实,最后用监控数据说话。
存储与计算分离架构训练集群性能问题解答
存储与计算分离后,训练速度还是慢,该从哪入手?
先拉开层次看:数据从远端到节点缓存的命中率是多少,缓存到GPU的读取带宽跑满没有,命中率低就检查数据局部性和缓存策略,命中率高但带宽不足就检查网络和存储节点IO,如果这些都没问题,看看数据预处理(解码、增强)是不是占了太多CPU时间,导致GPU在等CPU。
存储与计算分离和存储计算一体,哪个适合中小团队?
主要看数据集规模和算力规模,几块GPU、数据集在几TB以内,存储计算一体(本地盘)反而省事,性能也足够,几十块GPU以上,数据集几十TB起步,且多个实验并行,分离架构的弹性和共享优势就能体现出来,中小团队可以先从“本地盘加对象存储冷备”做起,等到带宽瓶颈明显时再引入共享存储。
训练检查点频繁写入慢,很多时候存储计算分离是被这一环拖垮的,怎么破?
检查点写入慢的根因是大量小文件或单文件过大导致存储端IO队列堆积,破法有几个:屏蔽训练框架默认的整模型保存,改为按优化器状态和模型参数分片异步保存;检查点直写本地NVMe盘,后台线程再同步到远端共享存储;远端存储开启写入聚合,把小块写入合并成大块,实践下来,这三板斧能把检查点耗时压缩到原来的三分之一以内。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/%e5%ad%98%e5%82%a8%e4%b8%8e%e8%ae%a1%e7%ae%97%e5%88%86%e7%a6%bb%e6%9e%b6%e6%9e%84%e5%9c%a8%e8%ae%ad%e7%bb%83%e4%b8%ad%e7%9a%84%e8%90%bd%e5%9c%b0/