容器平台监控指标一般要覆盖基础设施资源、容器运行时、编排控制平面、应用服务与安全合规五类关键数据,缺了任何一类,排障时都会出现“看得到报警、找不到根因”的尴尬局面。
容器平台监控指标有哪些:先分清谁在消耗什么
很多团队把容器监控简单理解成“看CPU和内存”,这在虚拟机时代勉强够用,放到Kubernetes环境里就会漏掉真正的故障源头,容器平台监控指标有哪些?按责任边界可以拆成四层。

节点资源层:容器的物理底座
节点没扛住,上面的Pod再好也没用,这一层要看:
- 节点CPU使用率、用户态与内核态占比
- 内存可用量、缓冲区与缓存占用
- 磁盘读写吞吐、IOPS、磁盘空间剩余量
- 网络接口每秒收发字节数、错误包数量
- 节点负载、上下文切换次数
常用指标包括node_cpu_seconds_total、node_memory_MemAvailable_bytes、node_filesystem_avail_bytes,在服务器上执行kubectl top nodes能快速看到资源水位,但只能算最粗的检查。
容器运行时层:单个容器的真实开销
容器跑在cgroup限制里,主机看到的使用率不能直接等同于容器体验,重点指标有:
container_cpu_usage_seconds_total:按容器累计CPU使用时间container_memory_working_set_bytes:比container_memory_usage_bytes更贴近真实内存占用,因为排除了可回收缓存- 容器重启次数、是否出现OOMKilled
- 容器文件系统读写速率
执行crictl stats或docker stats可以查看单容器实时数据,但在大规模场景里还是要靠Prometheus这类系统做聚合。
编排控制平面层:Kubernetes自己的健康度
控制平面一旦变慢,新建Pod、调度、服务发现都会受影响,关键指标包括:
- API Server请求延迟与错误率,指标
apiserver_request_duration_seconds - etcd是否有主节点、写磁盘同步延迟,指标
etcd_server_has_leader - Scheduler中待调度Pod数量与调度延迟
- Controller Manager工作队列深度,指标
workqueue_depth
这类指标在测试环境往往不突出,生产环境容器监控方案必须单独设置面板,否则API调用排队时业务层会先感知到,监控侧还看不到资源打满。
生产环境容器监控方案里最容易被忽略的三类数据
CPU和内存报警能告诉你“资源不够”,但很多生产事故的根因不在这。
事件与状态变更:Pod为什么被驱逐
Pod从Pending变成CrashLoopBackOff,状态变化本身比资源曲线更直接,要采集:
kube_pod_status_phasekube_pod_status_reason- Pod被驱逐的原因、镜像拉取失败次数
- 节点NotReady前的污点变化
执行kubectl describe pod查看Events是最快的排障方式,但监控系统如果不保存事件,Pod重启后可能连原因都抓不到。
网络与服务发现:IP漂移后的连通性
容器IP变化极快,传统以IP为对象的监控会失效,需要覆盖:
- CoreDNS解析延迟与失败数
- Service后端Endpoint健康比例
- kubelet PLEG重列延迟,指标
kubelet_pleg_relist_duration_seconds - CNI插件分配IP失败次数
这一层很多团队等到服务调用超时才去查,其实指标早已出现在网络插件和kubelet的暴露数据里。
存储卷与持久化:PVC容量和延迟
容器重启不丢数据,但PVC写满或底层存储抖动照样拖垮应用,关注:
kubelet_volume_stats_available_bytes:卷剩余空间kubelet_volume_stats_capacity_bytes:卷总容量- 存储CSI驱动的挂载延迟、IO队列长度
磁盘使用率告警在节点层只反映整块盘,PVC层的剩余空间才算业务真实可用空间。
Kubernetes监控指标怎么选:别把实验室清单直接搬上生产
“指标越多越好”只会制造告警风暴,Kubernetes监控指标怎么选,核心是先定义故障场景,再反向推导需要哪些信号。
从三个典型场景反推指标
- Pod频繁重启,要看的不是平均CPU,而是重启次数、退出码、OOMKilled标记、内存工作集是否接近limit。
- API调用变慢,要拆成应用自身延迟、Service后端连接数、CoreDNS解析延迟、节点网络丢包四段。
- 节点经常NotReady,要查kubelet心跳、PLEG重列时间、节点磁盘压力、内存压力,节点压力指标如
node_memory_MemAvailable_bytes比总使用率更有用。
用PromQL快速验证
生产环境不建议手动一个个查/metrics,但调试时可以用命令直接看一下某类指标是否拉通:
kubectl get --raw /api/v1/nodes | wc -lPrometheus里常用的查询示例:
rate(container_cpu_usage_seconds_total{namespace="prod"}[5m])再按Pod聚合:
sum by (pod) (container_memory_working_set_bytes{namespace="prod"})如果container_memory_working_set_bytes长期贴着limit且继续上涨,即使没有OOM,应用GC压力也会变大,这是内存告警设置时容易忽略的部分。
容器监控和虚拟机监控区别在哪:旧阈值不能照搬
拿虚拟机的经验直接套容器平台,多数情况下会得到两种结果:要么告警太松没发现,要么告警太频繁没人看,容器监控和虚拟机监控区别在哪,主要看四个维度的对比。
| 对比维度 | 虚拟机监控 | 容器监控 |
|---|---|---|
| 监控对象 | 物理机或虚拟机的整体资源 | 容器、Pod、命名空间、节点多层 |
| 指标生命周期 | 随VM长期稳定存在 | 随Pod调度随时新建或消失 |
| CPU衡量 | 主机CPU使用率 | cgroup限制内使用率、CPU节流时间 |
| 内存衡量 | 活跃内存与已用内存 | working set、page cache、limit距离 |
| 告警聚合 | 按主机名聚合 | 按Pod标签、Service、命名空间聚合 |
| 容量判断 | 节点总容量是否充足 | 还需看请求与限制比值、超配比例 |
容器CPU有一个关键差异:CPU throttling,容器在CPU限制内被强制节流时,主机CPU利用率可能并不高,但应用响应时间已经明显上升,因此生产环境容器监控方案里,container_cpu_cfs_throttled_seconds_total这类指标必须纳入告警。
再比如内存,容器内free命令看到的内存不一定可靠,因为cgroup限制可能比宿主机内存小得多,直接使用宿主机的内存使用率去判断容器健康,会漏掉大量OOM风险。
器云平台监控落地:采集链路与告警阈值
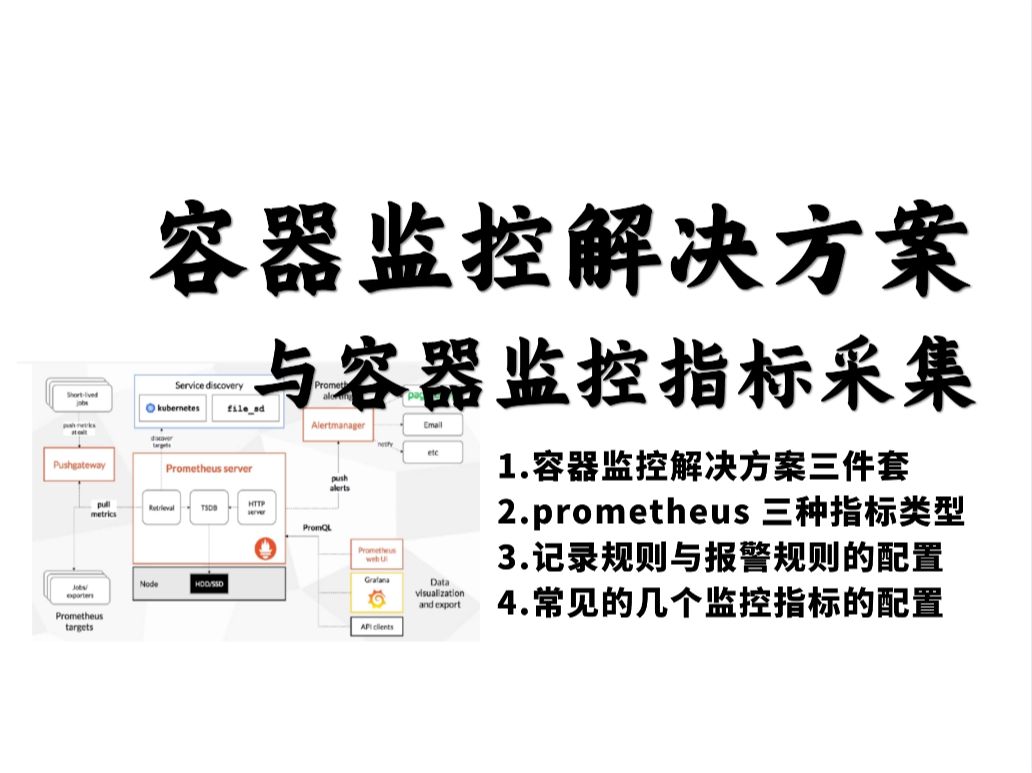
器云平台监控落地,多数基于开源Prometheus技术栈,实际采集链路一般包含四类组件:
- node-exporter:采集节点资源
- cAdvisor:采集容器资源
- kube-state-metrics:采集Kubernetes对象状态
- 云平台控制台:提供托管面板与部分聚合指标
自建环境下,执行kubectl get pods -n monitoring可以确认采集组件是否全部运行,Prometheus拉取到的数据通常会写入时序库,再由Grafana展示。
告警阈值方面,业内专家指出,阈值要结合业务正常波动来定,不建议直接复制社区模板,可参考的原则有:
- CPU节流持续时间达到秒级,应触发告警,而不是只看CPU使用率超过某个固定值
- 内存working set连续多个采样周期接近limit且仍在增长,应立即通知
- Pod重启次数短时间集中出现,即使资源使用率不高也要告警
- etcd写磁盘同步延迟持续高于存储设备正常响应水平,说明控制平面可能受损
kubelet_pleg_relist_duration_seconds明显变慢,往往早于节点NotReady出现
这些阈值需要根据实际流量峰谷调整,告警规则里多用持续时间条件,少用单点瞬时触发,能显著降低夜间打扰。
成本与容量:监控不只是排障
监控还有一个常被低估的作用:把资源账单说清楚,容器平台里很多资源并没有被真正使用,却占着配额不释放,需要关注:
kube_pod_container_resource_requests:容器请求的资源kube_pod_container_resource_limits:容器的资源上限- 节点可分配资源与已请求资源比值
- 命名空间级别的资源实际使用率与配额使用率
请求与限制差距过大,往往意味着资源超配,行业共识认为,合理的请求值应接近真实平均使用量,而不是拍脑袋填一个很小的数字,否则调度器会以为节点还有大量空闲,导致局部节点过载,而监控面板上整集群使用率却很低。
容器平台监控指标一般要覆盖五类数据:基础设施资源、容器运行时、编排控制平面、应用服务、安全合规,五类数据不是并列选择题,而是同一条排障链路上的不同视图,少看一层,故障就要靠重启和猜来临时解决,把指标、事件、日志、成本放到同一个监控体系里,才能让容器平台从“能跑”变成“可控”。
Q&A:容器平台监控指标相关疑问
容器平台监控指标一般要覆盖哪几类关键数据?
要覆盖基础设施资源、容器运行时、编排控制平面、应用服务与安全合规五类关键数据,基础设施看节点CPU、内存、磁盘、网络;容器运行时看单容器的cgroup使用、重启、OOM状态;控制平面看API Server、etcd、Scheduler的健康;应用服务看请求延迟、错误率、Pod生命周期;安全合规看权限变更、敏感操作审计和镜像漏洞状态。
Kubernetes监控指标怎么选才能避免告警风暴?
按故障场景反向选择指标,而不是按指标清单全部开启,优先保留能回答“谁、何时、哪里、为什么”的信号,例如Pod名称、命名空间、节点、退出码和关键资源指标,对瞬时抖动设置持续时间条件,对同一服务的多个Pod告警做抑制,只保留聚合后的一条通知,这样能把告警数量压到可处理范围内。
容器监控和虚拟机监控区别是否会影响成本统计?
会,虚拟机监控通常按单机计算资源使用率,容器平台必须按Pod和命名空间聚合,同时结合资源请求、限制和实际使用量三个值才能算出真实成本,如果只看节点使用率,忽略未分配资源和闲置请求,成本分析会出现较大偏差,容器平台的计费粒度更细,每一项limit和request的变化都会直接影响容量账单。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/640503.html