用容器跑机器学习训练任务,资源瓶颈主要集中在CPU、内存、GPU显存、存储IO和网络带宽五个维度,其中GPU显存和存储IO最容易被忽视。容器本身只是进程隔离,它不会替你解决物理资源不足的问题,反而会因为资源配额设置不合理,让训练任务跑得更慢,本篇文章将逐一拆解这些瓶颈的真实成因、排查路径和实操对策。
容器化部署机器学习模型要注意什么:CPU与内存的配额陷阱
很多团队把容器当成虚拟机用,直接给训练任务分配了4核8G这种“够用”的配额,结果模型迭代效率直线下降,业内专家指出,容器跑机器学习训练任务,CPU和内存的瓶颈通常不是硬件不够,而是配额方式选错了。
CPU配额:limits写死反而拖慢训练
容器编排平台默认的CPU配额有两种模式:requests(预留)和limits(上限),问题出在limits上,当你给训练容器设了严格的CPU limits,比如4核,Kubernetes的CPU管理器会按照CFS配额周期来限制进程的执行时间,这意味着即使宿主机上还有大量空闲CPU,你的训练进程也没法愉快地借来用,只能干等下一个调度周期。
- 实操建议:训练任务这类长跑型负载,优先只设requests,不设limits,让调度器保证基础资源,剩余算力按宿主机负载弹性使用。
- 如果你的平台要求必须设limits,建议把requests和limits设为相同值,避免出现“预留低、上限高”这种看似灵活实则无益的配置。
内存配额:OOM Killer比崩溃更难受
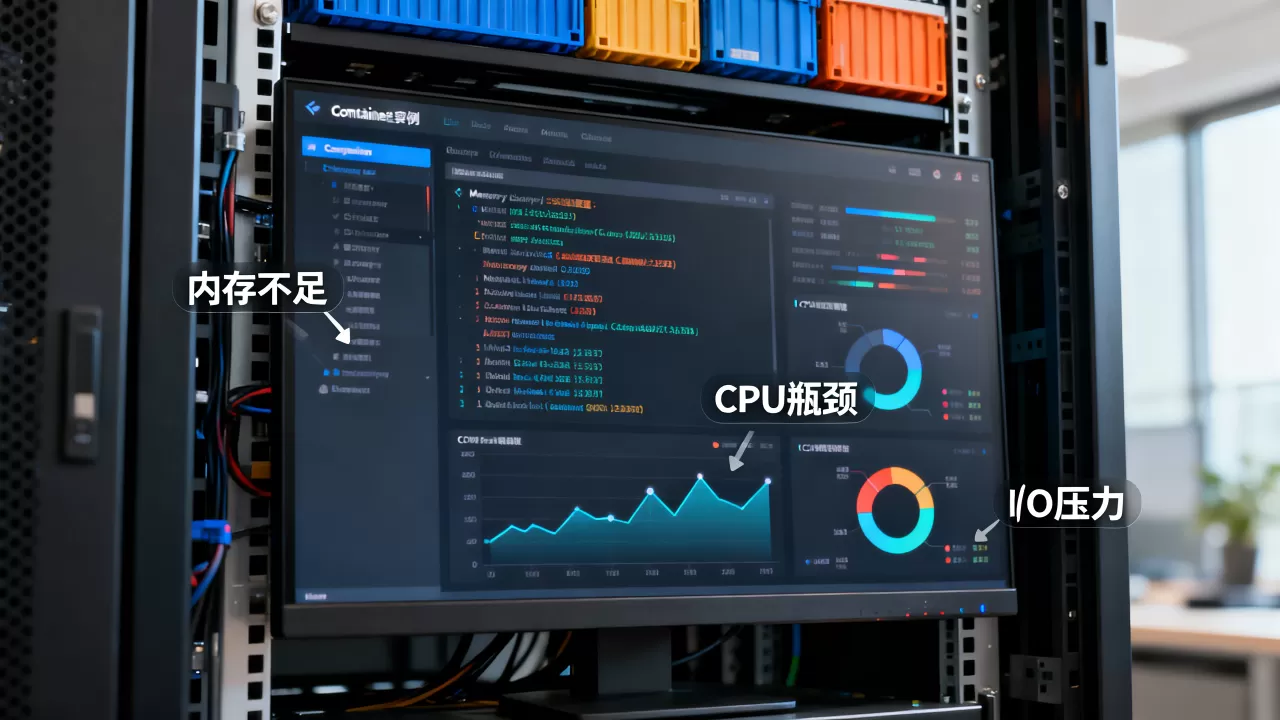
内存瓶颈更隐蔽,容器内进程看到的内存状态和宿主机内核看到的内存状态是不同的,当你的容器内存达到limits阈值,内核会先尝试回收页缓存,回收不了就直接触发OOM(Out Of Memory),更麻烦的是,OOM杀掉的可能是你的Python主进程,而不是某一个子进程,训练日志里常见的“Killed”就是这种情况。
- 排查命令:进入容器执行
dmesg | grep -i oom(部分容器镜像没有权限,可在宿主机上执行)。 - 数据加载时用
papermill或joblib做并行预处理,内存峰值往往会冲到单批数据的3-5倍,配额至少要留足这个余量。
Kubernetes跑深度学习任务资源限制对比:GPU调度最容易翻车
GPU的瓶颈和CPU/内存完全不同,Kubernetes对GPU的管理目前主要依赖设备插件(Device Plugin),它把GPU当作一种可计数的资源(比如nvidia.com/gpu: 1),但你没法在K8s原生层面限制显存大小。
显存隔离是个伪命题
很多团队以为给容器设了nvidia.com/gpu: 1,这个容器就能独占一张卡的全部显存,大错特错,这个限制仅仅代表容器能使用一张GPU设备,显存能用多少,取决于你的CUDA程序里有没有手动调用
cudaDeviceSetLimit或tensorflow的显存自适应配置,多数深度学习框架默认暴力占用全部空闲显存,一旦两个容器被调度到同一张卡上,后启动的那个就会直接报CUDA_ERROR_OUT_OF_MEMORY。
- 一种更稳的做法:用NVIDIA MPS(Multi-Process Service)控制并发,或者在代码里用环境变量
CUDA_VISIBLE_DEVICES配合Pytorch的torch.cuda.set_per_process_memory_fraction做软隔离。 - 行业共识认为,真正想要硬隔离显存,需要上NVIDIA vGPU或者MIG(Multi-Instance GPU)方案,但这两种方案目前对K8s的版本和GPU型号都有严格限制。
共享GPU卡适合什么场景
GPU共享调度适合推理服务、小批量离线推理这些对延迟不敏感的轻负载,如果是大模型预训练或微调,一张卡就要吃几十GB显存,强行共享只会在显存溢出和上下文切换之间反复横跳。
| 场景 | 是否适合GPU共享 | 核心原因 |
|---|---|---|
| 大模型预训练 | 否 | 单进程显存需求高,共享无法拆分 |
| 微调 | 视情况 | LoRA等参数高效微调可共享,全量微调不建议 |
| 批量推理 | 是 | 单请求显存占用低,通过并发提升利用率 |
| 交互式开发调试 | 是 | 低负载高时长,共享可显著提高资源利用率 |
存储性能瓶颈:被低估的数据加载环节
容器跑训练,存储瓶颈常常不在模型保存,而在数据加载和Checkpoint读写上,容器文件系统默认是overlayfs,读写性能远低于宿主机原生磁盘,尤其是大量小文件随机读写时,性能损失非常明显。
是把数据放镜像里还是挂载卷?
很多人贪图方便把数据集打进镜像,容器启动即用,这种做法在数据量小于2GB时勉强可行,一旦超过这个量级,镜像构建时间暴涨,而且每次拉取镜像都会占用大量网络带宽和磁盘IO,更合理的做法:
- 训练数据挂载为PVC(持久化存储卷)
- 模型代码保留在镜像内
- Checkpoint单独挂载一块高性能卷(如SSD类型)
小文件多导致的数据加载慢
图像分类任务里几十万张小图片,每个文件只有几十KB,容器内的数据加载器(比如tf.data、DataLoader)如果走网络存储(NFS、Ceph),会频繁发起元数据查询请求,这时瓶颈从GPU转移到了文件系统元数据服务上。
- 实操建议:用
tfrecord或webdataset将小文件打包成顺序读写的大文件,减少inode查询次数。 - 如果数据量在百GB级别,建议先把数据从网络存储拷贝到容器本地(如果节点有本地SSD),训练完再删除,这需要写一个简单的预处理步骤,但收益非常显著。
- 观察
iostat中的util指标,如果持续超过80%,可以考虑换用更快的存储方案。
网络带宽瓶颈:多机分布式训练的隐形天花板
分布式训练(如PyTorch DDP)对网络延迟和带宽极其敏感,容器网络的封装(iptables规则、CNI插件)会额外引入少量延迟,单机训练问题不大,一旦跨节点通信,带宽瓶颈会被立刻放大。
容器网络模型对通信效率的影响
K8s默认的flannel(VXLAN模式)或Calico(IPIP模式)都会对数据包进行额外封装,导致网络包变长、传输效率下降,这不难理解:同一条物理链路,裸机跑NCCL的环状通信能跑满100Gbps,容器里的VXLAN封装可能只剩70%。
- 优先考虑宿主机网络模式(hostNetwork),虽然会牺牲端口管理的便利性,但能显著降低通信延迟。
- 大规模训练集群建议为K8s节点配置RDMA(远程直接内存访问)和高性能CNI插件(如Volcano、Multus),否则多机扩展性会很差。
- 用
nvidia-smi topo -m查看节点间GPU拓扑,优先选NVLINK或PCIe直连的组网方式,避开跨NUMA节点通信。
通信原语的选择也要关注
AllReduce算子的实现非常依赖网络质量,多机训练时,如果网络条件一般,建议用gloo后端(CPU通信)配合模型并行,而不是强行用NCCL硬扛,NCCL对网络丢包和乱序非常敏感,用的不好反而比gloo更慢。
实操排查路径:从现象到根因
如果训练任务变慢了,建议按以下顺序定位,防止被容器层面的表象误导:
- 先看宿主机资源:登录节点执行
top、free -h、df -h,确认物理资源是否真的充裕。 - 再看容器内资源:进入容器执行
cat /sys/fs/cgroup/cpu/cpu.cfs_quota_us检查CPU配额,执行cat /sys/fs/cgroup/memory/memory.limit_in_bytes
查看内存上限,核对是否与启动参数一致。
- 最后看GPU状态:执行
nvidia-smi查看显存占用和温度,同时用nvidia-smi dmon查看实时利用率是否频繁波动到接近0%,如果是,说明瓶颈不在GPU算力而在数据加载或CPU预处理。
近似损耗参考表(基于经验值,非精确基准)
| 瓶颈类型 | 常见损耗区间 | 优先对策 |
|---|---|---|
| CPU limits过紧 | 训练时间延长30%-50% | 取消或放宽limits |
| 内存被OOM杀死 | 任务中断,重跑时间翻倍 | 调大limits或优化数据加载峰值 |
| 数据小文件IO | 数据加载耗时占单个step周期50%以上 | 打包成tfrecord/WebDataset |
| VXLAN网络封装 | 多机通信效率下降20%-30% | 换hostNetwork或RDMA |
Q:容器跑深度学习训练任务和裸机相比,性能损失有多大?
容器本身只是进程级隔离,通过cgroup和namespace实现资源限制和命名空间隔离,不引入额外的指令解释层,性能损耗极低,无特殊设置时通常可忽略,但存储驱动(overlayfs2)和网络叠加会带来可感知的开销,存储、网络方案选择不当造成的损耗远高于容器本身的运行时开销。
Q:Kubernetes中GPU资源限制应该怎么设置?
先明确平台是否支持GPU资源配额,标准K8s只支持GPU设备数量的配额,不支持显存配额,如果你的训练任务显存占用不固定,建议在启动参数中加入NVIDIA_DRIVER_CAPABILITIES=compute,utility,并用CUDA的cudaFuncSetAttribute或TensorFlow的set_memory_growth配合显存软限制,硬性显存隔离需要额外引入NVIDIA MIG或vGPU方案,并要求K8s版本和GPU型号全部兼容。
Q:容器内训练任务内存持续缓慢增长怎么办?
先区分是程序内存泄漏还是框架缓存增长,PyTorch、TensorFlow都会默认申请大量缓存内存,这属于正常现象,不代表泄漏,如果容器内存长期处于高位且持续不释放,建议检查DataLoader的num_workers数量是否过多,以及是否在循环中无意识地累积了分配图或计算图。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/639473.html