排查攻击源时误读正常爬虫流量,先别继续封IP,正确动作是停手、反查、比对行为:把百度蜘蛛IP和UA校验清楚,把返回404和突发抓取跟真实漏洞扫描分开,然后放行正常爬虫、对陌生IP限速,多数误报可以当天恢复抓取。
先分清:正常爬虫和恶意扫描的区别到底在哪
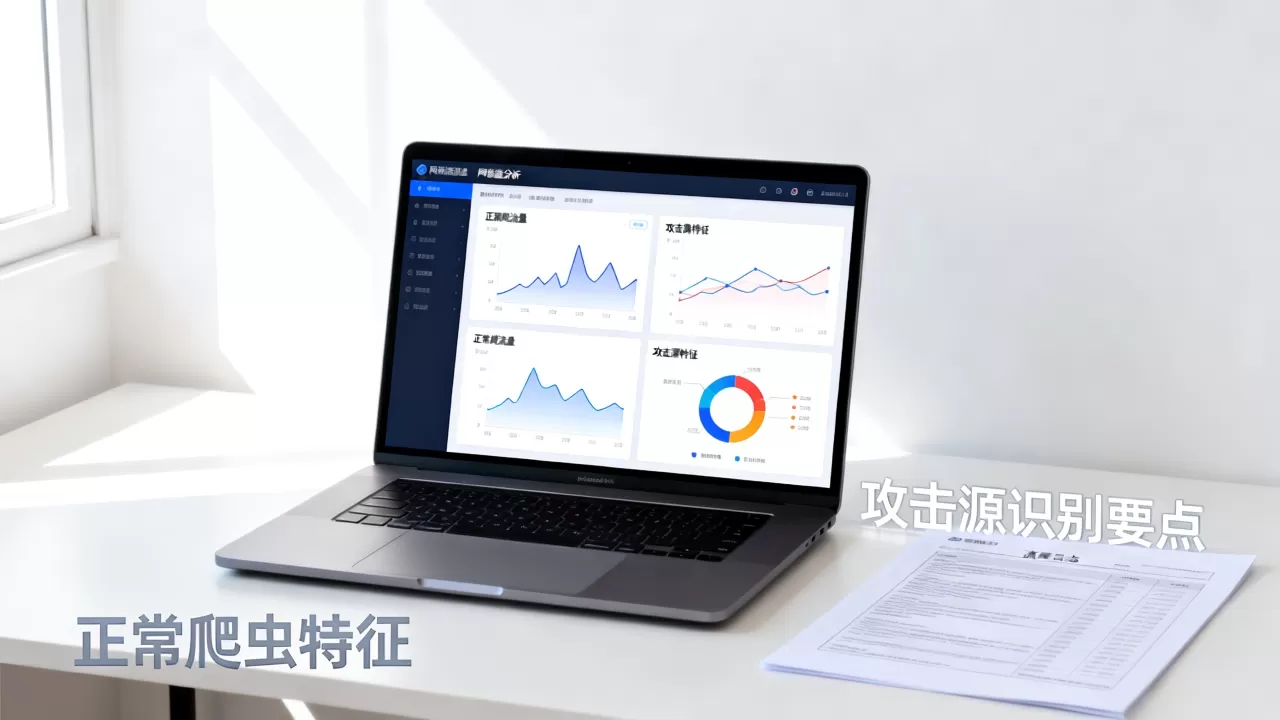
安全告警不会告诉你“这是百度蜘蛛在正常抓取”,它只会显示某个IP短时间请求大量URL、触发404或40x规则,你站在日志前面,第一步不是封IP,是先把请求特征拆成三类:路径、频率、资源消耗。

- 正常爬虫的路径有层次,首页、栏目页、内页、图片和CSS,顺着链接走。
- 恶意扫描的路径很集中。
/wp-admin、/.env、/phpmyadmin、/api/v1/user这类非公开入口反复出现。 - 正常爬虫频率多数有间隔,一个IP每秒几次请求已经算高。
- 恶意扫描器会并发请求几十条,把CPU和带宽瞬间拉起。
| 判断维度 | 正常爬虫 | 恶意扫描 |
| 请求路径 | 跟随链接,路径像真实浏览 | 集中敏感文件、后台入口 |
| 请求频率 | 多数分布在秒级几次以内 | 突发并发高,常出现几十次/秒 |
| HTTP方法 | GET为主,少量POST | POST、OPTIONS、PUT试探 |
| IP归属 | 搜索引擎官方段可反查 | 云主机、代理、海外IDC段居多 |
实际排查中,误报里相当一部分是搜索引擎对旧链接回访,站内改版、删除页面后,百度蜘蛛并不会马上忘记旧URL,它会反复请求直到确认404,这一点最容易被当成扫描攻击。
服务器日志大量404是攻击吗?多数不是攻击的特征
直接说结论:大量404本身不构成攻击证据,404表示请求的路径不存在,搜索引擎回访过期链接、用户分享链接失效、外站错误引用,都会让404在短时间内堆积。
判断方向放在“404路径是否集中在敏感入口”,比如你看到前20条404里全是/2026/07/旧文章.html,那基本是旧内容下线后的蜘蛛回访,如果404集中在
/wp-login.php、/.git/config、/admin/login,才需要按扫描处理。
一个可验证的统计命令:
grep " 404 " access.log | awk '{print $7}' | sort | uniq -c | sort -rn | head -20
跑完看路径,路径像正常栏目名,先别封,路径像漏洞字典,再拉黑。
百度蜘蛛ip段怎么判断真假?反查验证是第一步
攻击者会伪装UA,日志里写“Baiduspider”不等于就是百度,判断百度蜘蛛ip段怎么判断真假,核心动作是反查IP。
具体操作:
- 取出日志里声称Baiduspider的IP。
- 用
host 116.179.32.1或nslookup 116.179.32.1反查。 - 百度蜘蛛反查结果的主机名通常会落到baidu.com或baidu.jp域下。
- 反查结果如果指向简米云、酷番云、DigitalOcean、AWS等IDC,基本可以判定为伪装爬虫。
再补充两个交叉验证:
- 看请求路径,真百度蜘蛛不会大量请求
/wp-admin、/phpmyadmin。 - 看抓取频次,百度搜索资源平台的抓取诊断会显示官方蜘蛛的抓取时间,告警时间段能对上,说明大概率是真蜘蛛;对不上,就要警惕。
据百度搜索资源平台公开说明,站点可以通过反向DNS和UA双重校验识别百度蜘蛛,不能只依赖UA,行业共识认为,抓取频次突然升高但路径正常,多数是索引更新而非攻击。
不要只认IP段,UA和路径要一起看
百度蜘蛛的IP不是固定几个段,随着机房扩容,IP会变化,如果只按旧IP段加白,容易漏放,正确做法是:
- 先验证反查主机名。
- 再把验证通过的IP加入白名单。
- 定期更新白名单,而不是一次配置永久不管。
网站被爬虫攻击怎么处理?先放行再限速
你发现网站被爬虫攻击怎么处理,尤其当告警里混着真百度蜘蛛时,顺序不能反,先放行正常爬虫,再对剩余IP限速。
放行流程:
- 在宝塔面板或云WAF里删除对百度蜘蛛IP的封禁。
- 在Nginx配置里加入UA白名单。
示例配置片段:
if ($http_user_agent ~ "Baiduspider") {
    allow all;
}
不过这个写法太粗,更好的做法是用反查确认后的IP加白:
allow 220.181.108.0/24;allow 116.179.32.0/24;
这些只是格式示例,实际IP段请以反查结果为准。
放行后再处理真实攻击:
- 对非搜索引擎段配置限速。
limit_req_zone $binary_remote_addr zone=spider:10m rate=5r/s; - 在robots.txt里明确禁止抓取后台路径。
- 对持续扫描的IP直接拉黑。
顺序错了会导致一个问题:你封掉假蜘蛛时,把真蜘蛛一起封了,之后收录掉、自然流量掉,排查时间拉长到几周。
误封正常爬虫的隐性成本:国内服务器与搜索收录双重损失
误封正常爬虫不是没成本,它比多数人想的更贵。
- 百度蜘蛛连续被拒后,会降低抓取频率。
- 抓取下降后,新页面无法及时收录。
- 旧页面被移出索引后,再次进入需要更长时间。
- 自然搜索流量下降,订单或线索直接减少。
国内服务器上误封百度蜘蛛的情况尤其常见,机房自带的WAF默认规则看到高频IP就拦截,不管UA是不是Baiduspider,云安全产品也有“反爬虫”功能,误开后会拦掉搜索引擎,国内地区站点对百度蜘蛛依赖度高,误封的代价比海外站点更大。
反过来,如果站点做海外业务,需要注意Googlebot来自海外IP,国内机房如果只放行境内IP,Googlebot会被集体拦掉,判断地域时不要只看IP属地,还要看反查主机名是否属于Google。
实操:从攻击源告警到恢复收录的完整路径
遇到告警后,按下面顺序走,每条命令都可以直接复制到Linux服务器运行。
- 第1步:停止新增封禁,先关掉自动拉黑规则,避免误伤扩大。
- 第2步:导出攻击源IP。
awk '{print $1}' access.log | sort | uniq -c | sort -rn | head -20 - 第3步:逐IP反查。
host 116.179.32.1,看主机名是否属搜索引擎官方域。 - 第4步:比对UA和路径,Baiduspider的IP却在扫后台,标记为伪装。
- 第5步:在WAF或Nginx中放行验证通过的官方爬虫IP。
- 第6步:对剩余IP限速或封禁。
- 第7步:登录百度搜索资源平台,使用抓取诊断提交首页和内页,触发重新抓取。
- 第8步:观察24到48小时,看日志里百度蜘蛛是否恢复,收录是否止跌。
这套流程的核心不是“谁像攻击封谁”,而是“先救正常流量,再打恶意流量”。
很多站长把攻击源排查做成一次性动作,误读爬虫的根源是只看了“高频”和“404”两个特征,把路径和反查加进去,误封率会明显下降。
Q&A
怎么判断日志里大量404是攻击还是爬虫?
先统计404路径。grep " 404 " access.log | awk '{print $7}' | sort | uniq -c | sort -rn | head,如果路径大多是旧文章、栏目页,多半是搜索引擎回访,如果集中在/admin、/.env、/wp-login.php,再结合IP反查和UA判断是否恶意扫描。
服务器CPU高是爬虫还是攻击?
看当前请求的IP和路径。top看占用进程,再跑tail -f access.log观察实时请求,正常爬虫也会在集中抓取时拉高CPU,但路径通常正常、UA可反查,恶意扫描往往同时跑大量404和POST,路径集中在漏洞点,IP反查多为云主机或代理。
误封了百度蜘蛛ip段怎么解封?
先停止自动封禁规则,再在WAF或Nginx里删除对应黑名单,加入白名单,然后到百度搜索资源平台提交抓取诊断,触发百度蜘蛛重新访问,最后观察24小时日志,确认Baiduspider请求恢复,解封后并非立即恢复收录,旧页面重新入索引需要时间。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/654190.html