渲染农场的显卡配置,按项目规模来评估才靠谱:小项目两三张中高端卡就能应付,中大型项目按总帧量和交付周期倒推节点数,再决定单卡档次。渲染农场跟自用工作站的最大区别,在于它是按帧卖时间的生意,规模决定你在显卡上的投入会不会变成浪费或者瓶颈,所以别一上来就盯着参数表比跑分,先弄清楚自己手头的项目属于哪个量级。
为什么渲染农场必须按项目规模配显卡
一个农场最大的成本陷阱,不是卡买贵了,而是卡闲着,做一个家装效果图项目,单帧渲染往往只需要几分钟,一台主机一张卡就能覆盖需求,硬配十台机器纯属自己感动自己,反过来,一部三分钟的三维动画片,按每秒24帧算就是4320帧,单帧三分钟,单机连续渲染就要跑9天,这还不算场景迭代和返工,这种情况下,三五十个节点同时开工都未必稳。

所以项目规模直接决定两件事:显卡的档次和显卡的数量,档次管单帧速度,数量管总交付时间,两者互相咬合,分开谈都是耍流氓。
任务类型也会放大规模差异,室内外效果图、产品静帧这类项目,镜头短、场景相对轻,主流消费级显卡完全能打;建筑漫游、角色动画这类长镜头项目,场景复杂度高,显存需求直线上升;影视级特效和高端广告,涉及体积云、毛发、流体解算,节点和显存都得按上限配,行业共识认为:渲染农场真正烧钱的地方,是显卡空转等任务的时间,不是满负荷跑任务的时间,规模算错,烧的就是这类冤枉钱。
渲染农场显卡怎么选?先按项目规模画线
个人与小团队项目:一两台主机,两张卡
如果你接的活主要是效果图、短视频三维包装、小型产品动画,那么配置逻辑跟高端工作站几乎一样,一台双路电源稳定的主机,配两张同型号的RTX 4080或4070 Ti,显存不低于16GB,基本上能覆盖九成以上场景。
这个阶段的操作重点不是追新卡,而是做一次单帧压测,拿当前项目里最复杂的一个场景,分别设置不同分辨率、采样率和渲桨器参数,看看显存占用峰值卡在哪个位置,如果单帧控制在十分钟以内,后处理还能用热点重置的方式优化,说明配置够用;如果显存报错或者渲染时系统吃满,那就得调整方案,而不是单纯加节点。
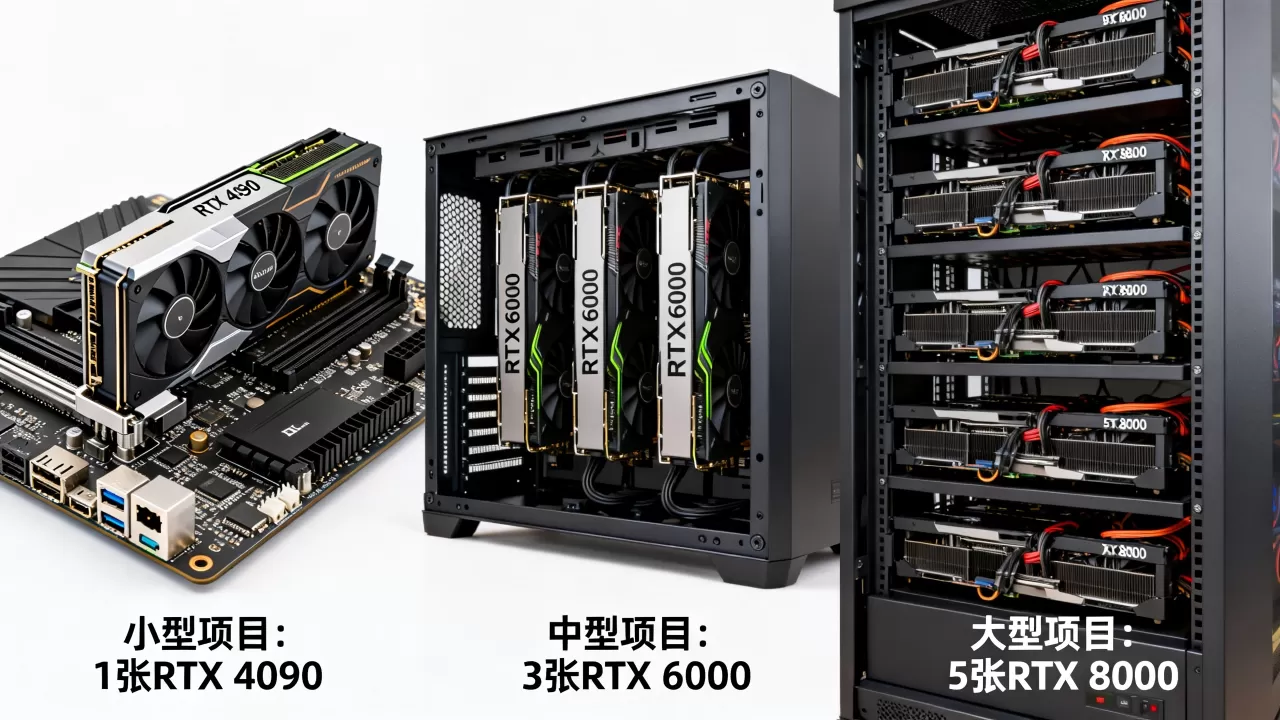
中型项目:十几个节点,统一型号
建筑漫游、短剧后期、批量产品展示这类项目,单机渲染已经明显拖不住进度,需要上小型分布式农场,节点数通常在六到二十个之间,显卡型号最好统一,避免新旧混插带来的调度麻烦,实际操作上,Adobe After Effects和常见帧渲染软件都能识别到多机并行,但要靠节点池管理软件统一调度,不同型号的卡会拉低整个池子的效率。
具体评估流程可以这样走:
- 挑三个代表性场景做单帧渲染测速,取平均值。
- 用平均单帧时间乘以总帧数,得出理论总耗时。
- 用交付天数反推需要的并发节点数量,预留至少两成余量。
- 将节点分组,按场景复杂度分配任务,避免所有机器抢内存。
大型项目:百卡集群,按卡型分池
院线动画、长剧集特效、大规模仿真数据可视化,这些项目的共性是多镜头并行、场景复杂度波动极大、交付节点卡得死,此时显卡配置不再是一台台看,而是按节点池整体规划,业内公用的做法是把集群拆成高显存池、高速度池和备用池:
- 高显存池用48GB级别显卡,专跑复杂场景。
- 高速度池用单卡浮点性能强的型号,跑普通镜头和后台缓存。
- 备用池混入上一代老卡,处理低优先级预演任务。
这种分组方式能最大化利用每一张卡的计算窗口,运维也能在监控面板上按池子查看负载,而不是看一堆散装数据。
| 项目规模 | 典型场景 | 单帧时长量级 | 建议配置 | 节点数量 |
|---|---|---|---|---|
| 个人/小团队 | 效果图、短视频 | 几分钟以内 | 双RTX 4080级别 | 1-2台 |
| 中型 | 建筑漫游、批量渲染 | 分钟到十几分钟 | RTX A6000级别,统一型号 | 6-20台 |
| 大型 | 影视动画、复杂特效 | 十几分钟以上 | 数据中心级显卡,分池调度 | 几十台以上 |
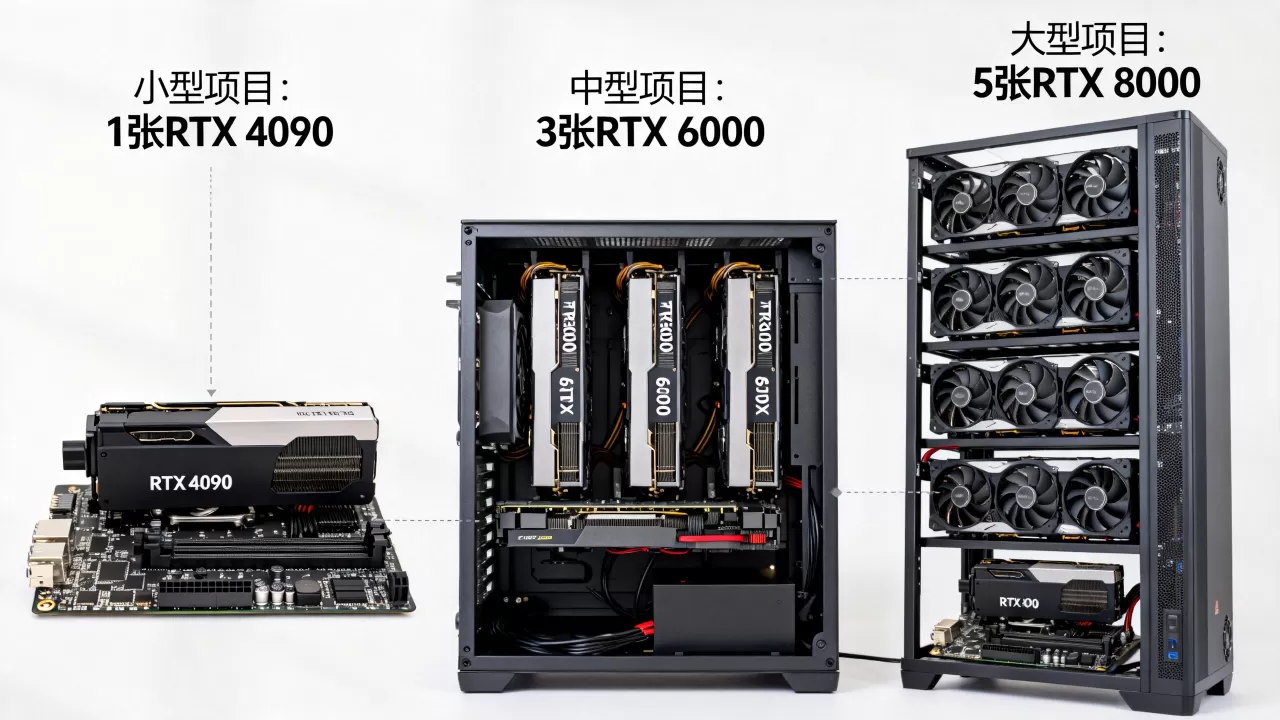
分布式渲染显卡怎么配置:从单帧时间倒推节点数
分布式渲染的核心其实不是什么高深公式,而是算账,先拿一个300帧的动画项目举例,单帧渲染五分钟左右,总计算量就是25小时左右,如果交付周期只有三天,每天实际干活时间按八小时算,一台主机得连轴转三天以上,这时候就需要至少三个节点并行,才能留出渲染器启动、场景加载和意外报错的时间。
具体做法是:先选一个最具代表性的镜头,用你意向中的候选显卡渲染一帧,用帧渲染时间乘以总帧数,得到单机总耗时;再除以可用工作日和单日有效渲染时长,结果向上取整就是最低节点数,考虑到多机调度和软件开销,一般建议在计算结果上再加一两个节点作为缓冲。
显存大小决定项目安全边界
显卡配置里最容易被低估的参数是显存,而不是流处理器数量,复杂的场景文件在渲染时如果显存爆掉,不会慢,而是直接报错或者直接退出,等于白跑,行业惯例是:节点显存按项目里最高复杂度场景来定,而不是按平均复杂度来定,部分时候一个大型场景就足够让你后悔省下的那几千块钱。
实操层面建议在配置环境时打开任务管理器的GPU专用内存监控,同时用配套SDK看显存分配情况,确认场景加载后显存占用量不超过总显存的八成,多卡协同渲染时显卡显存不叠加,每张卡各自加载一份场景,所以加卡解决不了显存不够的问题,只能靠换大显存卡。
渲染农场显卡配置方案的预算和地域差异
渲染农场多少钱一张卡?这个问题得反过来算
单看一块卡的价格没有意义,得看它在一个农场生命周期里能产出多少有效帧,消费级显卡价格相对亲民,但工作稳定性和长时间满载寿命不如专业卡;专业卡贵一截,胜在显存带宽和驱动稳定;数据中心级显卡性能最强,但溢价高,小型项目根本用不出差别。
大多数中小型农场的务实策略,是选择上一代专业卡或高端消费卡,价格处在腰斩位置,性能完全够用,据公开渠道行情,这类显卡的价格受供需波动影响很大,具体报价随渠道和地域变化,没有固定数,采买时多问几家供应商,重点确认质保政策是不是支持企业和服务器用途,不然售后方方面还透着麻烦。
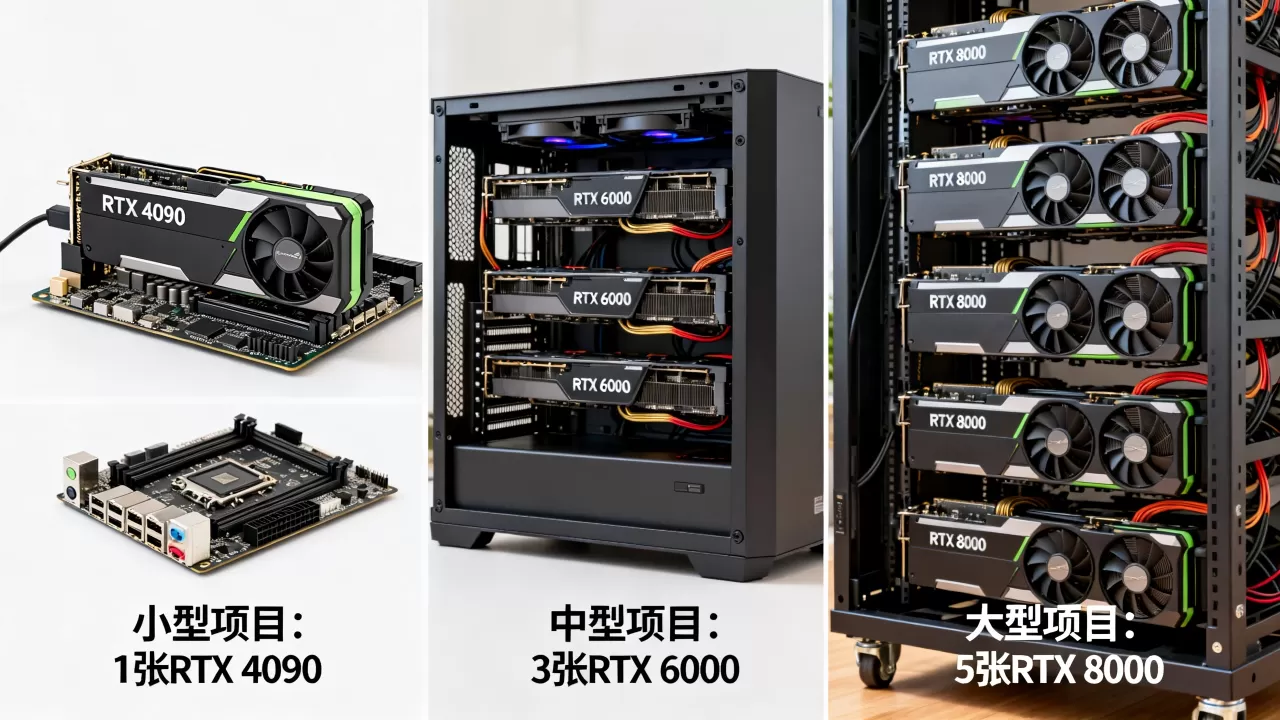
一线城市与二三线城市的配置差异
北京、上海、深圳这些城市,显卡现货渠道多,维修响应快,急单更容易找到临时租赁的备机,整体价格会更切近大盘价,二三线城市往往需要走电商平台或者异地渠道,物流时间、检测流程和售后周期都比一线城市慢,容易在项目高峰期掉链子,部分团队图省事选择全云渲染,把显卡配置的采购与运维压力转移给服务商,按项目付费,单体价格看着高,但省下的是机器的空转成本和人员维护时间。
渲染农场显卡配置怎么评估才算合理?常见问题解答
问:渲染农场显卡配置优先看哪几个参数?
显存容量、单卡长时间负载的散热设计、驱动对渲染软件的兼容性,这三样比核心频率和光追性能重要,场景加载后显存占用贴到上限说明配置不合理,渲染中途掉驱动会毁掉整个队列。
问:小型项目用消费级显卡和专业显卡差距大吗?
如果只是出货速度不敏感、单帧几分钟,消费级显卡的性价比优势非常明显,专业显卡的优势集中在显存容量和持续负载稳定性上,只有场景频繁触发显存超限的项目才值得换,多数小型工作室直接采购二手专业卡容易踩维修坑,不如选主流消费卡配良好散热机箱来得省心。
问:新旧显卡混用会导致渲染效率下降吗?
会,渲染农场的调度软件通常按节点池分配任务,不同型号混在一个池里时,调度器会按最低性能的那张卡做预算,导致高端卡也被压着跑,整体效率下降,规范的做法是按型号分池,让不同任务的负载自动路由到匹配的节点组里去,这样每张卡都能压榨出该有的帧速率。
端到端想一想:渲染农场的显卡配置从来不是买最强卡的问题,而是项目规模、交付周期、显存上限和预算四件事套在一起的决策题,先算清规模,再谈单卡型号,最后用冲高余量确认节点数量,才不会让农场的显卡变成账面上最亏的那一笔资产。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/702075.html