跨机房数据同步中断,根子多数不在数据库,而在网络链路的物理抖动、路由收敛和传输层重传这“三座大山”上。只要两端机房还隔着光纤和路由器,任何一层的微小异常都可能让同步进程眼睁睁看着数据“卡死”。
链路层的“隐形杀手”:光衰与误码率
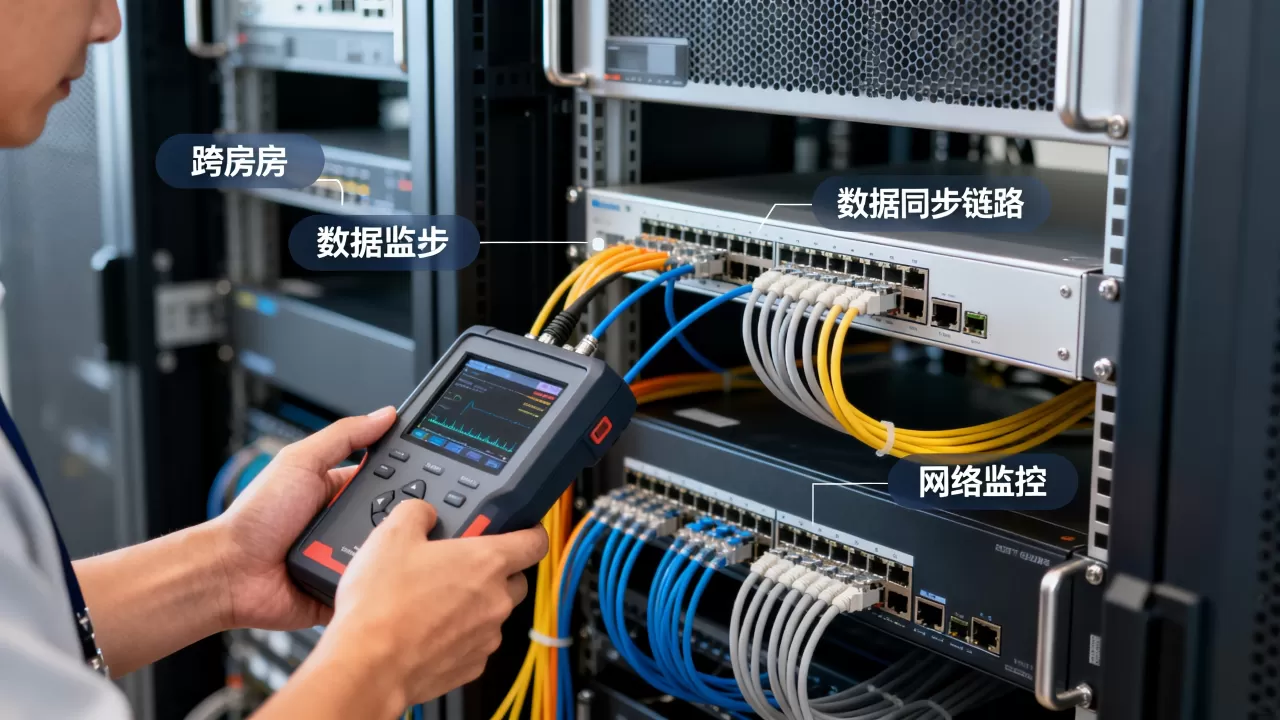
机房与机房之间的物理连接,看似一根光纤,实则中间串着大量分光器、配线架和光模块,行业共识认为,绝大多数跨机房同步断连,并非线路被挖断,而是光模块老化或接头污染导致的光功率下降。

- 光模块发射功率漂移:多模模块使用超过三年,发射功率普遍衰减,接收端误码率上升,数据链路层持续重传,同步进程无所适从。
- 光纤跳线弯曲半径过小:施工时扎带勒得过紧,弯曲损耗剧增,数据中心内部跨机柜尚不明显,跨楼宇、跨园区就彻底暴露。
- 单纤双向方案受色散影响:长距离场景下,单纤传输的色散容限低,高温季节尤为明显,误码率随着温度波动而忽高忽低。
操作层面验证:在两端机房同时执行ethtool -S eth0 | grep rx_errors,如果看到rx_crc_errors持续增长,就不用再怀疑数据库配置了,问题百分之百出在物理链路上。
路由层的“脑裂危机”:收敛时间超出预期
很多同步中断的真实原因,是路由收敛时间远大于同步进程的心跳超时阈值,所谓跨机房数据同步断连,对数据库而言是“连接超时”,对网络设备而言却是“常规路由切换”。
| 故障类型 | 收敛时间 | 同步进程表现 |
|---|---|---|
| 直连路由失效 | 毫秒级 | 无感知 |
| OSPF邻居重建 | 秒级 | 轻微抖动 |
| BGP路由撤销 | 数十秒 | 连接重置 |
| 全台设备重启 | 分钟级 | 同步彻底中断 |
实际生产环境中最常见的是BGP场景,两台机房路由器之间建立EBGP会话,当一端防火墙规则误改动,或交换机CPU因广播风暴繁忙而丢掉了BGP保活报文,会话在Hold Time内未被重置,路由即被撤销,整个过程无需物理链路中断,纯粹是路由协议层面的“误判死亡”。
异地多活机房网络中断怎么处理?第一时间不是查数据库日志,而是登录核心交换机执行show ip bgp summary,观察邻居状态若长时间处于Active或Idle,说明路由会话没建立起来,所有TCP长连接都会饿死。
路由策略不对称引发的黑洞
另一个隐蔽问题出自策略路由和防火墙规则的不对称,同步请求走A路径过去,响应却因防火墙状态表项老化走了B路径返回,在tcpdump抓包里表现出典型的“有去无回”。
- 防火墙会话超时设置过短,业务侧配置了NAT时尤其致命
- 等价路由的哈希算法不一致,多链路负载场景下回包走偏
- 黑洞路由存在但未配置宣告,故障切换后流量被静默丢弃
传输层的“卡死陷阱”:TCP重传的恶性循环
业务感知到的跨机房数据同步延迟排查,多数要落到TCP层找答案,同步工具(如Binlog复制或消息队列消费)通常依赖长时间存活的长连接,一旦网络发生短时拥塞,发送端就进入指数退避。
重传超时带来的雪崩效应
假设同步进程正传输一个较大的事务,此时RTT从正常的2ms飙升到200ms,发送端的拥塞窗口收缩到极小,数据包开始积压,如果中间设备的缓冲区有限,丢包必然发生。
- 发送端收到重复ACK,触发快速重传
- 重传的数据包再遇抖动,触发RTO超时
- 发送端等待重传超时(通常指数退避到数秒级别)
- 同步进程认为连接已死,主动断开并尝试重连
- 重连需要重新认证和追平位点,期间数据持续积压
这个循环一旦形成,即便网络恢复了,应用层也难以自行恢复,同步进程反复“断开-重连-追位点-再断开”,看起来像是同步工具出了问题,本质上却是传输层的一次小抖动被指数放大。
从现象到根因:一套完整的排查操作路径
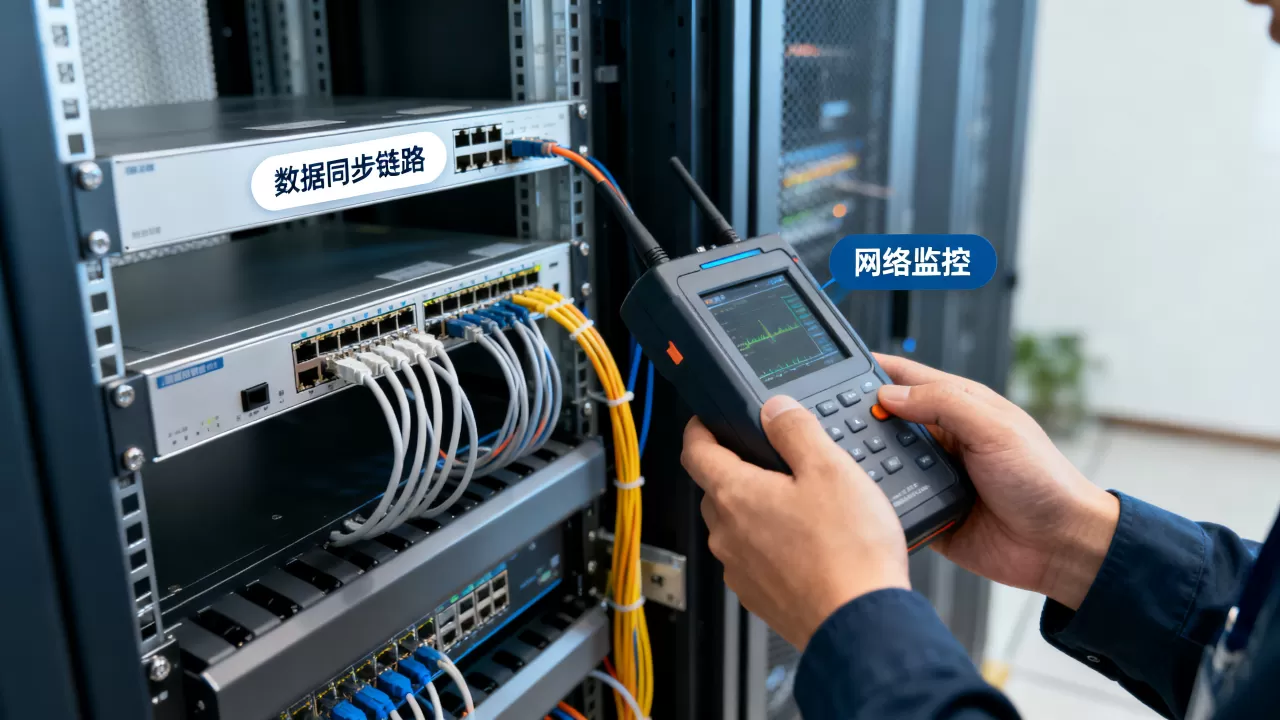
面对跨机房数据同步中断,提供一个经过验证的排查顺序,直接照做,不走弯路。
-
确认物理层:两端机房同时ping对端机房的内网互联IP,观察丢包率和时延波动。如果丢包率超过0.1%,且呈现出周期性规律,优先怀疑光模块温度漂移或链路被干扰。
-
放大链路层:
mtr -z -r -c 100 <对端IP>,逐跳查看延迟和丢包位置,重点看中间转发设备那几跳,连接机房的边界交换机往往是问题高发点。 -
检查协议层:登录BGP路由器检查会话状态,确认
Established之外的任何状态;同时查看show ip route中业务网段的路由来源,确认是否还是优选路径。 -
聚焦传输层:在服务器上执行
netstat -s | grep -E 'retrans|timeout',查看重传比例,TCP重传占比高于正常水平时,直接抓包看Retransmission的集中段。 -
验证应用层:确认网络问题排除后,再检查同步进程自身的binlog位点追平逻辑,多数情况下,网络恢复后同步能自动追平,不需要人工干预。
预防优先:消弭中断于无形
与其等中断发生后辗转排查,不如提前构建抗抖动的网络架构,以下措施按性价比排序。
链路冗余必须做到物理隔离
行业实践反复验证:两条看似独立的专线若走同一段管道或同一根光缆,就只是逻辑冗余而非物理冗余。跨机房同步稳定性,取决于专线和公网这“一主一备”的切换速度,两条物理路径独立,配合协议层面的自动切换,才能做到真正的故障自愈。
调整TCP参数适配跨机房场景
默认TCP协议栈按内网时延调优,放到跨城域网上需要针对性调整,具体参数路径如下:
net.ipv4.tcp_retries2 = 5        # 减少无用重传,缩短失败感知时间
net.ipv4.tcp_syn_retries = 3     # 加快连接失败后的重试节奏
net.ipv4.tcp_keepalive_time = 30 # 缩短死链探测周期,默认7200秒太长
net.core.netdev_max_backlog = 50000 # 应对突发流量
调整后需执行sysctl -p生效,这几处修改专门针对跨机房场景,能有效避免“连接看起来还在,实际早已死亡”的假死状态。
引入中间层做缓冲回放
对于苛求数据零丢失的业务,建议在同步链路中间加一层消息队列或WAL日志回放服务,网络中断期间,数据源源不断写入本地缓冲,网络恢复后按序追平。这从根本上剥离了网络质量与数据完整性的耦合关系。
故障模拟与演练:验证真实恢复能力
纸上谈兵毫无意义,每个季度做一次链路切换演练,直接拔掉主线路面光纤,观察同步进程能否在预期时间内完成切换和追平。
- 演练前记录binlog位点或消息队列偏移量
- 模拟链路中断后观察监控告警是否按预期触发
- 恢复链路后确认延迟逐步回落而非剧烈跳动
- 记录全流程耗时,与同步进程的RPO要求对照
多轮演练你会发现:真正导致同步失败的往往不是切换的瞬断,而是恢复后海量积压数据冲击下游引发的连锁反应,这一认知,值得用一次次演练去深化。
跨机房数据同步中断常见问题解答
专线抖动导致的同步中断,和公网抖动有什么区别?
专线抖动通常由运营商侧路由变更或光缆割接引起,表现为短时高丢包后迅速恢复;公网抖动则更加随机,受拥塞和路径绕行影响更大,专线的可靠性在长距离场景下显著优于公网,但两者的处理思路一致:通过冗余链路加自动切换来掩盖抖动窗口。
为什么ping通了,数据同步仍然频繁报错?
Ping使用的ICMP协议与业务TCP协议走不同的转发路径,某些网络设备默认对ICMP报文高优先级处理,造成“ICMP通、TCP断”的假象,验证跨机房网络质量,应当使用curl -v telnet://或nc -vz测试真实业务端口,而不是仅依赖ping。
机房之间的丢包率达到多少就需要介入处理?
丢包率超过0.01%时,TCP重传对同步延迟的影响已相当显著;超过0.1%时,长时间大事务的同步大概率出现中断,从监控趋势看,丢包率若连续五分钟高于0.1%,就需要立即排查链路质量并准备切换冗余路径。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/640071.html