2026年AI大模型实战的核心在于从“调用API”转向“私有化部署与微调”,通过RAG架构结合本地知识库,企业能以较低成本实现业务逻辑的深度定制。
大模型落地避坑指南:从概念到实战的跨越
过去两年,许多团队在引入大模型时陷入了“为了AI而AI”的误区,业内专家指出,单纯依赖公有云API往往面临数据隐私泄露和响应延迟高的问题,真正的实战价值,体现在如何将通用大模型的能力“锚定”在你的具体业务场景中。

为什么你的大模型项目总是失败?
失败的原因通常不是技术不够先进,而是场景定义模糊。
- 幻觉问题:通用模型在回答专业领域问题时,容易编造事实。
- 上下文限制:长文档处理时,关键信息容易被遗忘。
- 成本失控:未经优化的Prompt导致Token消耗巨大,账单惊人。
解决这些问题的关键,在于构建一个“感知-思考-行动”的闭环,而不是让模型直接回答用户。
构建企业级RAG系统:核心架构解析
检索增强生成(RAG)是目前最成熟的落地方案,它通过外挂知识库,让大模型“查阅资料”后再回答,从而大幅降低幻觉率。
数据清洗与向量化:实战的第一步
很多初学者直接上传PDF,结果效果极差,这是因为PDF包含大量非结构化噪声。
具体操作路径
- 格式转换:使用
Unstructured或PyMuPDF库将PDF转换为纯文本或Markdown格式。 - 分块策略:不要按页切分,应按语义切分,建议块大小(Chunk Size)设为500-800字,重叠部分(Overlap)设为50-100字。
- 向量化嵌入:选择适合中文场景的Embedding模型,如
BGE-M3或text-embedding-3-large
。

注意:向量数据库的选择直接影响检索速度,对于中小规模数据,
Chroma或Faiss足够;对于百万级向量,建议采用Milvus或Elasticsearch。
混合检索与重排序:提升准确率的关键
单一关键词匹配(BM25)或向量相似度(Vector Search)都有局限。
- 关键词检索:擅长精确匹配专有名词。
- 向量检索:擅长语义理解,能捕捉同义词。
最佳实践:采用“双路召回”机制,先用BM25和向量模型分别检索Top 50文档,再用Cross-Encoder模型(如BGE-Reranker)对这50条结果进行重排序,最终取Top 5作为上下文输入大模型,这种组合拳能将回答准确率提升30%以上。
私有化部署与微调:低成本高性能方案
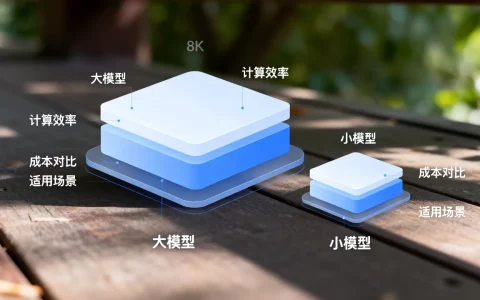
当RAG无法满足复杂逻辑推理或风格模仿需求时,微调(Fine-tuning)成为必要手段,2026年的趋势是“小模型大能力”,不再盲目追求千亿参数模型。
模型选型:Qwen2.5与Llama3的博弈
在AI大模型私有化部署价格方面,开源模型具有显著优势。
- Qwen2.5-7B/14B:中文理解能力极强,推理速度快,适合部署在消费级显卡(如RTX 3090/4090)上。
- Llama-3.1-8B:英文能力强,生态丰富,但中文原生能力略逊于Qwen。
建议:中文业务场景优先选择Qwen系列;英文或国际化业务选择Llama系列。
LoRA微调实战:无需全量参数更新
全量微调需要昂贵的算力,而LoRA(低秩适应)只需训练少量参数。
操作步骤
- 数据准备:构造SFT(监督微调)数据集,格式为
{"instruction": "问题", "input": "上下文", "output": "回答"},数据量在1000-5000条高质量样本即可见效。
- 环境配置:使用
Unsloth或Axolotl框架,它们对显存优化极佳。 - 训练参数:学习率设为1e-4,Epoch设为3-5,Batch Size根据显存调整。
- 评估验证:使用BLEU和ROUGE指标评估,更重要的是人工抽检业务场景。

2026年AI应用开发趋势与工具链
随着Agent(智能体)概念的普及,开发模式正在从“对话式”向“任务式”转变。
多Agent协作架构
单个模型难以完成复杂任务,通过编排多个专用Agent,可以实现分工合作。
- 规划Agent:拆解用户意图,生成执行计划。
- 执行Agent:负责调用工具(如搜索、代码解释器、数据库查询)。
- 反思Agent:检查结果,若失败则自动重试或修正计划。
主流开发框架对比
| 框架名称 | 特点 | 适用场景 | 学习曲线 |
|---|---|---|---|
| LangChain | 生态最丰富,组件齐全 | 复杂工作流编排 | 中等 |
| LlamaIndex | 数据索引能力强,RAG专精 | 知识库问答系统 | 较低 |
| Dify | 可视化操作,开箱即用 | 快速原型开发,非技术人员 |
低 |
| Semantic Kernel | 微软出品,C#/Python支持 | 企业级.NET生态整合 | 中等 |

如何选择合适的AI大模型服务商?
对于没有算力团队的企业,选择AI大模型服务商哪家好是一个常见困惑。
- 百度文心一言:中文生态完善,与百度智能云深度集成,适合国内政企客户。
- 阿里通义千问:长文本处理能力突出,适合文档分析场景。
- 智谱AI:在代码生成和数学推理方面有优势,API稳定性高。
选择时,不仅要看模型效果,更要看其提供的API稳定性、数据隐私合规性以及技术支持响应速度。
常见问题解答
AI大模型实战教学入门需要掌握哪些编程技能?
入门主要需要Python基础,熟悉requests库调用API,了解pandas处理数据,以及基本的Git版本控制,不需要深入掌握深度学习算法原理,但需理解向量数据库和Prompt工程的基本逻辑。
私有化部署大模型对硬件配置有什么要求?
运行7B-14B参数量的量化模型,至少需要24GB显存的显卡(如RTX 3090/4090),若需运行70B以上模型,则需要多卡互联或专业服务器,内存建议64GB起步,以确保数据加载和缓存效率。
大模型微调的数据量多少合适?
对于特定领域风格模仿,500-1000条高质量指令对数据即可产生明显效果,若需提升逻辑推理能力,建议扩展至5000-10000条,并涵盖多种题型和场景,数据质量远重于数量,脏数据会导致模型“学坏”。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/373676.html