构建离线数据仓库的核心在于建立稳定、分层且可追溯的数据流水线,通过ODS、DWD、DWS到ADS的分层架构,实现从原始数据到业务价值的高效转化。
在数字化转型的深水区,企业不再仅仅满足于“有数据”,而是追求“用好数据”,离线数据仓库作为企业数据资产的核心底座,其建设质量直接决定了BI报表的准确性、数据产品的响应速度以及AI模型的训练效果,很多团队在起步阶段容易陷入“重工具、轻架构”的误区,导致后期维护成本指数级上升,理解其底层逻辑并掌握实操路径,是数据工程师和架构师的必修课。

离线数据仓库的核心架构分层逻辑
业内专家指出,一个健壮的数据仓库必须遵循“高内聚、低耦合”的设计原则,通常采用经典的四层架构模型,这种分层并非为了炫技,而是为了解决数据血缘混乱、重复计算和清洗困难等实际痛点。
数据接入层:ODS原始数据保持原貌
ODS(Operational Data Store)层是数据进入仓库的第一站,这一层的核心原则是“全量同步”和“最小加工”。
- 数据源对接:无论是MySQL的业务日志、Nginx的访问日志,还是第三方API返回的JSON数据,进入ODS层时都应保持与源系统一致的结构。
- 分区策略:建议按天(dt)或小时(hour)进行分区存储,例如HDFS路径为
/data/ods/user_login_log/dt=20260101/,这样既便于后续的历史回溯,也方便增量抽取。 - 操作建议:不要在此层进行任何复杂的字段转换或去重操作,如果源系统数据质量极差,仅做基础的格式校验(如JSON合法性检查),异常数据应单独落入“脏数据表”,而非直接丢弃或强行清洗。
明细数据层:DWD清洗与标准化
DWD(Data Warehouse Detail)层是数据仓库中数据量最大、计算最频繁的层级,这里的目标是将原始数据转化为“干净、统一、标准化”的事实数据。
- 数据清洗:剔除空值、异常值,统一时间格式(如统一为UTC+8的YYYY-MM-DD HH:mm:ss),处理缺失值。
- 维度退化:将常用的维度属性(如用户姓名、城市名称、商品类别)冗余到事实表中,减少后续Join操作,提升查询性能。
- 一致性处理:确保同一指标在不同业务线中的定义一致。“活跃用户”在A部门定义为“登录即活跃”,在B部门定义为“产生交易”,在DWD层必须通过业务规则明确统一口径。
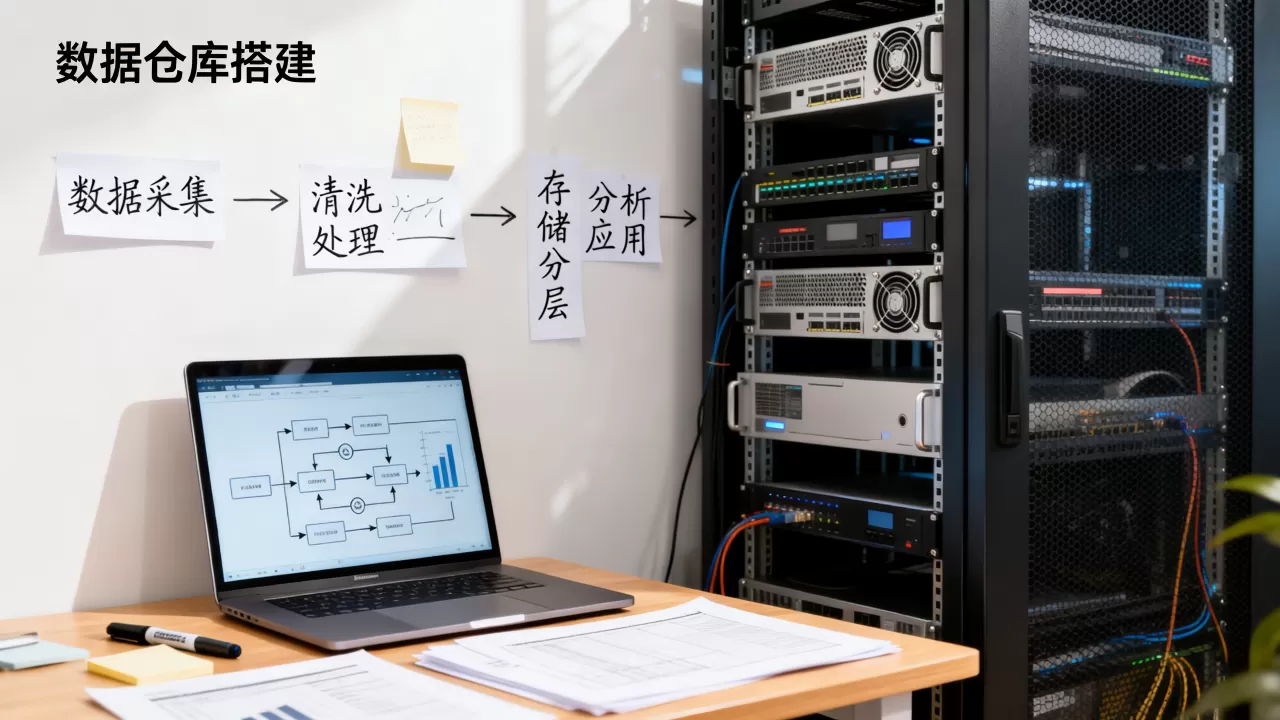
汇总数据层:DWS面向主题聚合
DWS(Data Warehouse Summary)层是连接明细数据与最终应用的桥梁,这一层通常以“主题域”为单位,进行轻度或中度汇总。
- 用户主题:构建用户行为宽表,包含用户过去7天、30天的登录次数、点击率、平均停留时长等聚合指标。
- 商品主题:构建商品销售宽表,包含销量、销售额、退货率等。
- 技术优势:通过预计算,将复杂的实时聚合逻辑转化为简单的读取操作,极大降低下游查询压力。
技术选型与离线计算引擎对比
在构建离线数据仓库时,选择合适的技术栈至关重要,不同的场景对延迟、吞吐量和生态兼容性的要求不同,导致技术选型存在显著差异。
传统Hadoop生态 vs 云原生数据湖
过去十年,Hadoop生态(HDFS + Hive + Spark)是离线数仓的主流选择,随着云原生技术的发展,存算分离架构逐渐成为新宠。
| 维度 | 传统Hadoop生态 (Hive/Spark) | 云原生数据湖 (Iceberg/Hudi + Spark/Flink) |
|---|---|---|
| 存储成本 | 较高,需维护HDFS副本 | 较低,支持对象存储(S3/OSS),存算分离 |
| 扩展性 | 受限于NameNode单点瓶颈 | 弹性伸缩,计算与存储独立扩容 |
| 数据更新 | 仅支持追加,Update/Delete成本高 | 支持ACID事务,高效支持Upsert操作 |
| 适用场景 | 大规模批处理,对实时性要求不高 | 需要频繁更新数据、近实时数仓或混合负载 |
业内共识认为,对于大多数中小型企业,直接使用云厂商提供的托管Hive服务或Spark服务,能大幅降低运维复杂度,而对于大型互联网企业,自建基于Iceberg或Hudi的数据湖架构,能更好地支持数据回溯和实时离线一体化需求。
调度系统:Airflow与DolphinScheduler的选择
离线数仓的依赖关系错综复杂,一个DWS表的生成可能依赖上百个DWD任务,强大的任务调度系统是数仓稳定运行的保障。
- Apache Airflow:以Python代码定义工作流,灵活性极高,适合技术团队开发能力强、需要高度定制化的场景。
- Apache DolphinScheduler:可视化拖拽界面,中文支持好,集群部署简单,适合国内企业快速上手,且对DAG依赖解析更直观。
实操建议:初期项目推荐使用DolphinScheduler,降低学习曲线;当业务逻辑极度复杂且需要与CI/CD深度集成时,再迁移至Airflow。
数据质量治理与监控体系搭建
数据仓库建得再好,如果数据不准,垃圾进,垃圾出”,数据质量治理不是上线后的补救措施,而是贯穿建设全程的核心环节。
核心监控指标
建立多维度的数据监控体系,重点关注以下三个维度:
- 完整性:表记录数是否异常波动?关键主键是否有空值?
- 准确性:数值字段是否在合理范围内?枚举值是否符合字典表定义?
- 及时性:T+1任务是否在凌晨4点前完成?延迟超过阈值需立即告警。
自动化校验工具链
不要依赖人工肉眼核对数据,应引入自动化数据质量监控平台(如Great Expectations或自研规则引擎)。
- 规则配置:在CI/CD流水线中嵌入数据质量检查,在DWD层任务结束后,自动执行SQL校验:“如果今日新增用户数环比下跌超过20%,则阻断下游任务并发送钉钉/企业微信告警”。
- 数据血缘追踪:利用工具(如DataHub或Atlas)自动生成数据血缘图,当上游源系统字段变更时,能快速评估对下游报表的影响范围,避免“牵一发而动全身”的灾难。
构建离线数据仓库常见误区与避坑指南
在实际落地过程中,许多团队会踩中一些典型陷阱,导致项目延期或效果不佳。
过度建模,追求完美范式
很多工程师受传统关系型数据库思维影响,试图在数仓中实现第三范式(3NF),数据仓库的核心是“分析”,而非“事务”,过度规范化会导致大量的Join操作,严重拖慢查询速度,正确的做法是:在DWD层保持星型或雪花型模型,在DWS层适当反范式化,用空间换时间。
忽视数据生命周期管理
数据会随时间增长而膨胀,如果不制定清理策略,存储成本将不可控,建议建立分层存储策略:
- 热数据(近3个月):存放在高性能SSD或云盘,支持快速查询。
- 温数据(3个月-1年):存放在标准存储,成本适中。
- 冷数据(1年以上):归档至低成本对象存储或磁带库,仅用于合规审计或长期趋势分析。
缺乏文档与元数据管理
“代码即文档”在数据仓库中往往失效,业务逻辑复杂,人员流动频繁,导致数据字典无人维护,必须建立统一的元数据管理平台,强制要求所有表、字段、指标必须有业务含义描述、负责人和更新频率,没有文档的数据仓库,最终会变成无人敢碰的“数据沼泽”。
构建离线数据仓库常见问题解答
构建离线数据仓库需要多少预算和周期?
预算和周期高度依赖于数据规模和团队规模,对于小型企业,使用云厂商托管服务,搭建一个基础数仓可能仅需数万元的初期投入和1-2个月的开发周期,对于大型企业,自建集群加上数据治理团队,年度投入可能达到数百万,完整建设周期通常需6-12个月,关键变量在于数据源的复杂度和业务指标的梳理难度,而非技术本身。
离线数据仓库与实时数仓有何区别?
离线数仓侧重于T+1的批量处理,擅长复杂关联计算和历史数据回溯,技术栈以Hive/Spark为主,稳定性高,实时数仓侧重于秒级或分钟级的数据响应,擅长流式计算,技术栈以Flink/Kafka为主,架构复杂度高,两者并非替代关系,而是互补关系,多数企业采用“离线打底,实时增强”的混合架构,离线数仓保证数据的准确性和完整性,实时数仓满足运营活动的即时决策需求。
如何验证离线数据仓库建设是否成功?
成功的标志不是技术栈有多先进,而是业务价值是否体现,具体可量化指标包括:报表产出时间提前了多少小时、数据查询响应速度是否达到秒级、数据准确率是否通过业务方验收、以及数据复用率是否提升(即同一份数据被多个业务线重复使用,而非各自为战),当业务方能够主动提出数据需求,而非被动等待报表时,数仓建设才算真正成功。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/259187.html