将HTML格式数据导入SQL数据库的核心路径是:先将HTML解析为结构化数据(如JSON或CSV),再通过ETL工具或编写脚本将其映射至数据库表中,利用SQL的INSERT语句完成最终入库。
在处理Web抓取、日志分析或老旧系统迁移时,我们常遇到HTML文件堆积如山,而业务系统却依赖关系型数据库的场景,直接让数据库读取HTML不仅效率低下,还容易引发格式混乱,业内专家指出,数据清洗与结构化转换是这一流程中耗时最长、也最关键的环节,很多人误以为SQL能直接解析HTML标签,数据库引擎擅长处理结构化数据,而非非结构化文本,我们需要在中间搭建一座桥梁,这座桥梁就是数据解析与转换层。
解析HTML并提取核心数据的技术选型
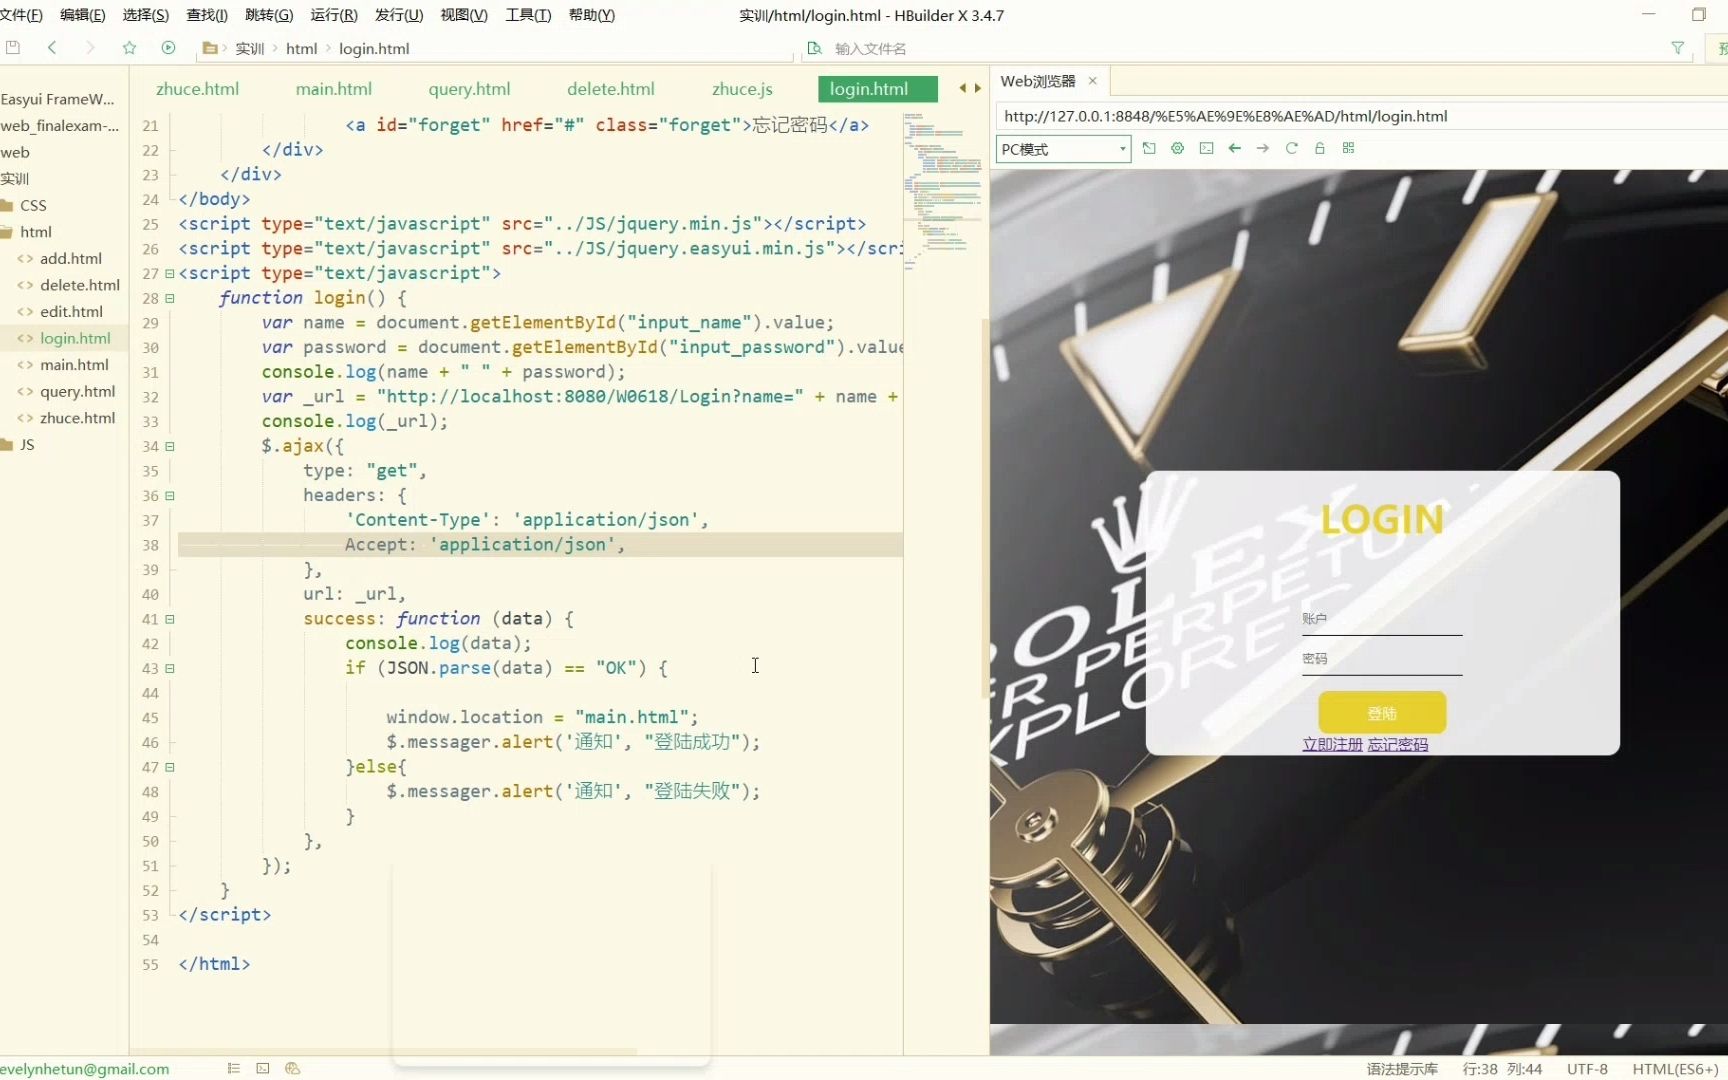
要将HTML转化为数据库可识别的格式,第一步是“读懂”网页结构,HTML本质上是树状结构的标签集合,我们需要从中提取出有意义的文本、链接或属性。
前端解析库与后端脚本的选择对比
目前主流的做法是使用编程语言中的解析库,Python因其丰富的生态成为首选,其内置的html.parser轻量级但功能有限,适合简单场景,对于复杂页面,BeautifulSoup配合lxml解析器是行业共识中的黄金组合,它能容忍残缺的HTML代码,快速定位元素,如果涉及动态渲染的页面,则需要引入Selenium或Playwright模拟浏览器行为,但这会显著增加资源消耗。
另一种思路是使用Node.js环境下的cheerio,它速度快、内存占用低,适合高并发场景下的静态页面解析,在选型时,需考虑目标数据的复杂度,如果只需提取表格数据,XPath表达式往往比CSS选择器更精准。
具体操作路径:使用Python提取表格数据
假设我们需要从一堆HTML文件中提取订单信息,操作步骤如下:
- 安装依赖:通过pip安装
pandas和beautifulsoup4。 - 加载文件

:使用
pd.read_html()函数,它能自动识别HTML中的<table>标签并直接转换为DataFrame对象,这是处理表格型HTML最高效的方法。 - 数据清洗:检查DataFrame中的空值,合并重复行,确保数据类型一致(如将金额列转为浮点数)。
- 导出中间格式:将清洗后的DataFrame保存为CSV或JSON文件,作为后续导入数据库的源数据。
这种“HTML到CSV”的转换策略,极大地降低了后续入库的复杂度。
构建高效的数据导入管道
拿到结构化数据后,如何将其高效、准确地写入SQL数据库,是决定系统稳定性的关键,直接逐行执行INSERT语句在数据量大时会导致严重的性能瓶颈。
批量插入与事务管理的最佳实践
数据库的写入性能受限于网络IO和磁盘IO,为了优化这一过程,必须采用批量插入策略,大多数SQL驱动(如MySQL Connector/J, psycopg2 for PostgreSQL)都支持批量执行。
- 分批提交:不要一次性将所有数据放入一个事务中,建议每处理1000-5000条记录提交一次事务,这样既能保证性能,又能避免单一大事务导致锁表或内存溢出。
- 使用UPSERT逻辑:在处理增量数据时,需考虑数据已存在的情况,使用
INSERT INTO ... ON DUPLICATE KEY UPDATE(MySQL)或ON CONFLICT(PostgreSQL)语法,可以避免先查询再插入的双重IO开销,实现原子性的更新或插入。
场景化案例:处理千万级日志数据的导入
假设你有一个包含千万级访问日志的HTML导出文件,需导入MySQL数据库。
- 预处理:使用Python脚本将HTML日志解析为CSV,并按日期字段排序。
- 创建表结构:在数据库中创建对应表,并对高频查询字段(如
user_id,timestamp)建立索引,注意,在导入大量数据前,暂时删除非唯一索引,导入完成后再重建,可提升数倍速度。 - 执行导入:使用
LOAD DATA INFILE命令(MySQL特有)或COPY命令(PostgreSQL特有),这些原生命令绕过SQL解析层,直接读取文件写入数据页,速度远超INSERT语句。 - 验证数据:导入后,通过抽样查询和总数比对,确保数据完整性。
常见陷阱与解决方案
在实际操作中,开发者常遇到字符编码错误、特殊字符转义失败以及外键约束冲突等问题。
字符编码与特殊字符处理
HTML文件中常包含HTML实体编码(如&, )或特殊Unicode字符,如果直接存入数据库,可能导致乱码或解析错误。
- 统一编码:确保源HTML文件、解析脚本、数据库连接字符串均使用UTF-8编码。
- 实体解码:在解析阶段,使用库提供的解码功能(如Python的
html.unescape)将实体转换为普通字符。 - SQL注入防护:虽然批量导入通常使用参数化查询或原生命令,但仍需对输入数据进行过滤,防止恶意脚本注入。
数据类型映射错误
HTML中的数据往往是字符串形式,而数据库表可能有严格的类型定义,HTML中的日期格式可能是“2026/01/01”,而数据库期望的是“2026-01-01”。
- 标准化日期:在导入前,使用正则表达式或日期解析库统一日期格式。
- 数值清洗:去除金额字段中的货币符号(如“$”、“¥”)和千分位逗号,确保其为纯数字格式。
自动化与监控机制
一次性的导入脚本难以应对持续变化的数据源,建立自动化管道和监控机制,是保障数据长期可用的关键。
使用ETL工具简化流程
对于非技术人员或需要频繁调整映射规则的场景,推荐使用开源ETL工具如Apache NiFi或Kettle,这些工具提供可视化界面,允许用户通过拖拽组件完成HTML解析、数据转换和数据库写入。
- 配置数据源:指定HTML文件路径或URL。
- 定义转换规则:在图形界面中配置字段映射和清洗逻辑。
- 设置调度任务:利用cron或工具内置调度器,定期执行导入任务。
错误日志与告警
自动化脚本难免出错,建立完善的日志记录机制,记录每批数据的处理数量、成功数、失败数及错误详情,当失败率超过阈值时,通过邮件或即时通讯工具发送告警,确保问题能被及时发现和处理。
Q&A:HTML导入SQL常见问题解答
HTML格式导入到sql数据库中速度慢怎么办?
提升导入速度的核心在于减少数据库的IO开销,在导入前暂时禁用或删除目标表的非唯一索引,导入完成后再重建索引,这通常能带来显著的性能提升,避免逐行INSERT,改用批量插入或数据库原生加载命令(如MySQL的LOAD DATA INFILE或PostgreSQL的COPY),确保数据库连接池配置合理,避免频繁建立和断开连接。
如何处理HTML中的动态内容和JavaScript渲染数据?
静态解析库无法获取JavaScript动态生成的内容,此时需使用无头浏览器工具,如Selenium、Playwright或Puppeteer,这些工具模拟真实浏览器环境,等待页面完全加载后再提取DOM数据,虽然这种方式速度较慢且资源消耗大,但对于依赖JS渲染的页面是必要手段,建议在提取数据后,缓存结果以避免重复请求。
HTML导入sql数据库时出现乱码如何解决?
乱码通常由编码不一致引起,首先检查HTML文件的编码声明,通常位于<meta charset="...">标签中,确保Python或Java等解析脚本在读取文件时指定正确的编码(如encoding='utf-8'),验证数据库连接字符串和表结构的字符集设置是否为UTF-8,在数据入库前,可使用html.unescape()等函数处理HTML实体编码,确保数据纯净。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/356797.html