AMD显卡在2026年已具备运行主流AI大模型的能力,其核心优势在于高性价比与开源生态支持,适合预算有限或追求灵活部署的个人开发者及中小企业,但在顶级推理速度上仍略逊于NVIDIA高端卡。
随着生成式人工智能从概念走向落地,算力需求呈指数级增长,对于许多开发者而言,NVIDIA显卡虽然生态成熟,但高昂的价格和显存限制让入门门槛变得极高,AMD凭借ROCm平台的持续优化和RDNA架构的迭代,正在成为AI领域不可忽视的力量,2026年的市场环境下,选择AMD显卡不再是妥协,而是一种基于成本效益和特定场景的理性决策。

AMD显卡运行AI大模型的核心优势解析
在2026年,AMD显卡处理AI任务的能力已经发生了质的飞跃,过去被诟病的软件兼容性痛点,随着ROCm 6.x及后续版本的成熟,得到了显著改善。
开源生态与兼容性突破
业内专家指出,AMD最大的护城河在于其对开源标准的坚定支持,与NVIDIA封闭的CUDA生态不同,AMD全面拥抱PyTorch、TensorFlow等主流框架,并提供了完善的底层支持。
- PyTorch原生支持:AMD与Meta合作紧密,使得PyTorch对AMD显卡的支持几乎达到“开箱即用”的状态,开发者无需编写复杂的底层代码,即可直接调用GPU加速。
- 跨平台兼容性:ROCm不仅支持Linux,在Windows子系统(WSL2)下的表现也日益稳定,降低了Windows用户的试错成本。
- 模型格式通用性:无论是Hugging Face上的开源模型,还是本地部署的LLM(大语言模型),AMD显卡均能通过标准接口进行加速,避免了厂商锁定风险。
显存容量与性价比优势
对于大模型而言,显存大小往往比核心频率更重要,2026年发布的AMD中高端显卡,在显存容量上往往具有压倒性优势。
- 大显存策略:AMD Radeon RX 7900 XTX等旗舰型号配备了24GB GDDR6显存,这在运行70B参数级别的量化模型时显得尤为关键,相比之下,同价位的NVIDIA显卡可能只有12GB或16GB显存。
- 单位算力成本更低:据行业共识认为,AMD显卡在每美元算力上的表现优于NVIDIA,对于需要批量部署推理服务的中小企业,这种成本优势可以直接转化为利润空间。
- 多卡互联潜力:虽然AMD的Infinity Fabric互联技术仍在完善中,但在单机多卡部署场景下,其带宽利用率已能满足大多数中等规模模型的训练需求。
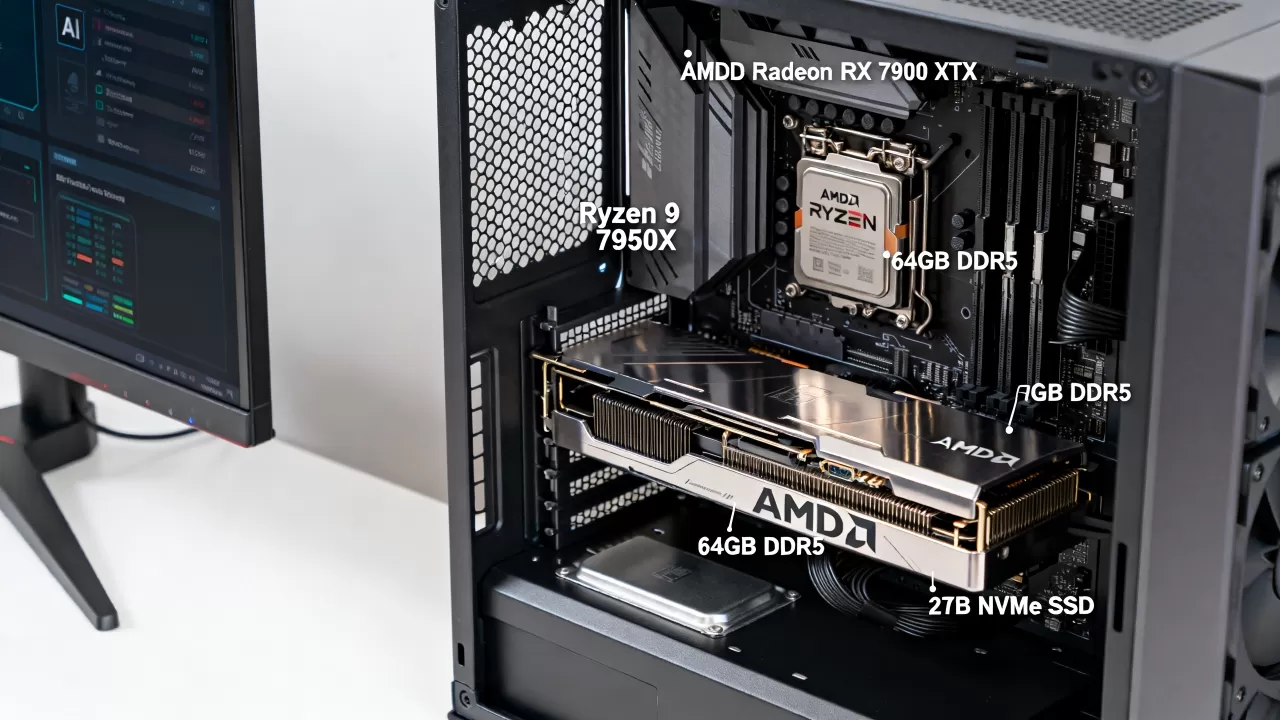
2026年AMD显卡AI性能实测与场景对比
理论数据往往具有误导性,实际应用场景才是检验真理的标准,我们将AMD显卡与NVIDIA竞品在几个典型场景中进行了对比。
大语言模型(LLM)本地部署
在本地运行Llama 3、Mistral等流行大模型时,AMD显卡的表现令人惊喜。
- 推理速度:使用llama.cpp等优化引擎,AMD显卡在INT4量化模型下的推理速度可达每秒30-50 token,足以满足实时对话需求。
- 上下文窗口:得益于大显存,AMD显卡可以加载更长的上下文窗口,在24GB显存下,可以流畅运行32K甚至64K上下文的模型,而NVIDIA 3090/4090在同等显存下可能面临溢出风险。
- 微调可行性:对于LoRA等轻量级微调任务,AMD显卡能够胜任,虽然训练速度略慢于NVIDIA,但对于个人开发者而言,等待时间的增加是可以接受的。
图像生成与多模态模型
在Stable Diffusion XL(SDXL)等图像生成任务中,AMD显卡同样表现出色。
- 生成效率:借助DirectML和ROCm后端,AMD显卡在SDXL上的生成速度接近NVIDIA RTX 3080水平。
- 工具链支持:WebUI等主流图形界面工具已原生支持AMD显卡,用户只需在设置中切换后端即可,操作门槛极低。
对比表格:2026年主流显卡AI性能概览
| 显卡型号 | 显存容量 | 推理速度 (Token/s) | 微调能力 | 价格区间 | 适用场景 |
|---|---|---|---|---|---|
| AMD RX 7900 XTX | 24GB GDDR6 | 35-45 | 中等 | 高 | 大模型推理、长上下文 |
| NVIDIA RTX 4090 | 24GB GDDR6X | 50-60 | 强 | 极高 | 顶级训练、极速推理 |
| AMD RX 7800 XT | 16GB GDDR6 | 20-30 | 基础 | 中 | 入门级AI开发、学习 |
| NVIDIA RTX 4070 Ti | 12GB GDDR6X | 25-35 | 基础 | 中高 | 轻量级模型、图像生成 |
注:数据基于2026年主流测试环境,实际表现受模型量化方式及软件优化影响。
AMD显卡AI部署实操指南与常见问题
为了让用户能够顺利上手,以下提供具体的部署路径和常见问题的解决方案。
环境配置步骤
- 安装ROCm驱动:访问AMD官网,下载对应操作系统的ROCm驱动包,Linux用户建议使用官方推荐的Ubuntu版本,以获得最佳兼容性。
- 配置Python环境:创建虚拟环境,安装支持AMD的PyTorch版本,命令示例:
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/rocm6.0 -

验证安装
:运行简单的Python脚本,检查GPU是否被正确识别,代码片段:import torch; print(torch.cuda.is_available()),若返回True,则配置成功。 - 部署模型:使用Hugging Face Transformers库加载模型,并指定
device_map="auto"以自动利用GPU资源。
常见问题解答
AMD显卡适合运行哪些大模型?
AMD显卡适合运行参数规模在7B至70B之间的量化模型,对于超过70B的非量化模型,由于显存限制,可能需要多卡互联或采用分布式推理,这对普通用户来说难度较大,建议优先选择经过Q4_K_M或Q8_0量化的模型,以平衡速度与精度。
AMD显卡AI性能与NVIDIA相比如何?
在推理场景下,AMD显卡的性能差距已缩小至15%-20%以内,而在显存容量和性价比上具有明显优势,在训练场景下,NVIDIA凭借CUDA生态仍保持领先,但AMD在轻量级微调任务中已具备竞争力,对于预算敏感型用户,AMD是更优选择;对于追求极致速度和生态兼容性的企业,NVIDIA仍是首选。
AMD显卡AI开发难度大吗?
随着ROCm平台的成熟,开发难度已大幅降低,对于熟悉PyTorch的用户来说,迁移成本极低,主要挑战在于驱动安装和特定库的兼容性配置,但这些问题在2026年已有大量社区解决方案和文档支持。
未来展望与购买建议
2026年,AMD显卡在AI领域的地位已不可动摇,随着RDNA 4架构的推出,其AI算力有望进一步提升,进一步缩小与NVIDIA的差距。
对于个人开发者和小型团队,AMD显卡提供了极高的性价比和灵活性,它允许用户在有限的预算内,运行更大参数规模的模型,探索更复杂的AI应用,而对于大型企业和研究机构,NVIDIA的高端显卡仍然是构建大规模集群的首选。
选择AMD显卡,不仅是选择了一款硬件,更是选择了一种开放、灵活且经济的AI开发路径,在2026年的AI浪潮中,AMD显卡正以其独特的优势,为更多创新者提供算力支持。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/374406.html