


2026年AI大模型显卡选择的核心结论是:预算充足且追求极致推理速度首选NVIDIA H20或L20,若侧重本地部署与性价比则AMD MI300X或消费级RTX 4090是务实之选,具体需根据模型参数量及并发需求决定。
在2026年的今天,AI大模型已经从实验室走向千行百业,显卡不再仅仅是游戏玩家的玩具,而是算力基础设施的核心,面对琳琅满目的型号,许多技术负责人和开发者常常陷入选择困难症,究竟是该咬牙上专业卡,还是用消费级卡凑合?不同场景下,哪款显卡能真正帮我省钱又省力?本文将剥离营销话术,从实际部署场景出发,为你梳理清晰的选型逻辑。

企业级推理与训练:H20与L20的博弈
对于大多数中国企业而言,合规性与性能之间的平衡是首要考量,随着出口管制的常态化,NVIDIA推出的特供版芯片成为了市场主流。
H20与L20性能对比
H20和L20虽然同属Hopper架构的衍生产品,但在实际应用中各有侧重,H20拥有更高的互联带宽和计算密度,适合大规模分布式训练和超高并发的推理场景,其FP8精度下的算力表现依然强劲,能够支撑千亿参数模型的微调任务,相比之下,L20更偏向于推理优化,显存容量较大,适合处理长文本或高分辨率图像生成的负载。
业内专家指出,在构建私有化知识库时,L20的性价比往往优于H20,因为知识库问答通常不需要极致的训练算力,而是更看重显存大小以容纳更大的上下文窗口,据统计,多数企业在部署RAG(检索增强生成)系统时,L20的单卡吞吐量能够满足中等规模的并发请求,且功耗控制更为优秀。
部署实操建议
若选择H20或L20集群,建议采用NVLink或高速以太网进行互联,对于H20,务必开启FP8混合精度训练,这能显著减少显存占用并提升训练速度,在推理端,使用vLLM或TGI框架进行部署,并针对H20的架构特点调整批处理大小(Batch Size),一般建议初始Batch Size设为16,根据GPU利用率动态调整,避免显存溢出。
高性价比本地部署:AMD MI300X与消费级显卡
并非所有场景都需要昂贵的企业级数据中心卡,对于初创团队、个人开发者或边缘计算节点,AMD MI300X以及NVIDIA的消费级旗舰卡提供了极具吸引力的替代方案。
AMD MI300X的崛起
AMD MI300X凭借192GB的大显存,在运行超大参数模型时展现出独特优势,在2026年的生态建设中,ROCm软件栈的成熟度已大幅提升,对PyTorch和TensorFlow的支持更加完善,虽然其单卡算力略逊于同级的NVIDIA旗舰卡,但192GB的显存允许用户直接在单卡上加载70B甚至更大参数的模型,无需复杂的模型并行策略。
行业共识认为,对于预算有限但需要运行大模型的研究机构,MI300X是打破显存瓶颈的有效手段,其优势在于“大显存即正义”,在模型加载阶段能节省大量时间。
消费级RTX 4090的极限玩法
对于个人开发者,RTX 4090依然是桌面端的王者,24GB显存虽然无法运行70B全精度模型,但通过量化技术(如4-bit或8-bit量化),可以流畅运行Llama-3-70B或Qwen-72B等主流开源模型。
实操中,建议使用Ollama或LM Studio等工具,以Ollama为例,只需一条命令即可拉取并运行量化模型:
ollama run llama3:70b-q4_K_M
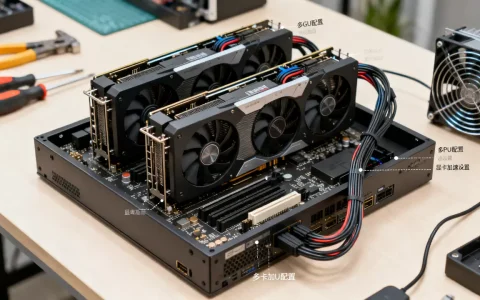
这条命令会自动下载4-bit量化版本的Llama-3模型,并在RTX 4090上运行,虽然推理速度相比FP16全精度有所下降,但对于本地测试、代码辅助和日常对话而言,延迟完全在可接受范围内,若需更高性能,可尝试双卡SLI(需主板支持)或购买二手RTX 3090组建16GB x 2的集群,通过模型并行实现32GB显存,从而运行更大的模型。
不同场景下的选型决策树
为了更直观地辅助决策,我们将常见场景与推荐配置进行对比。
| 应用场景 | 核心需求 |
推荐显卡 | 理由 |
|---|---|---|---|
| 大规模预训练 | 极致算力、高带宽 | H20集群 | 支持大规模分布式训练,生态兼容性好 |
| 企业级私有化部署 | 稳定性、合规性 | L20 / H20 | 显存充足,推理吞吐量大,符合国内合规要求 |
| 初创公司/研究 | 性价比、大显存 | AMD MI300X | 单卡192GB显存,降低模型并行复杂度 |
| 个人开发者/极客 | 低成本、灵活性 | RTX 4090 | 易于获取,社区支持丰富,量化后性能可观 |
| 边缘计算/物联网 | 低功耗、小体积 | Jetson Orin系列 | 集成度高,功耗低,适合嵌入式场景 |
地域与采购策略
在采购环节,地域因素也会影响最终选择,一线城市由于数据中心资源丰富,通常能更容易获取到H20或L20的现货,且售后服务响应更快,而在二三线城市,由于物流和售后网络的覆盖差异,部分开发者可能更倾向于选择本地有代理的AMD MI300X或消费级显卡,租赁算力云也是一种灵活的选择,尤其在测试阶段,按需租用H20实例可以避免初期巨额资本支出。
未来趋势与避坑指南
展望2026年下半年,AI芯片市场将继续分化,专用ASIC芯片在特定推理任务上的效率可能超越通用GPU;软件优化将成为关键竞争力。
软件生态的重要性
硬件只是基础,软件栈的成熟度决定了最终的上手难度,NVIDIA的CUDA生态依然占据主导地位,这意味着绝大多数开源模型和工具链都优先支持NVIDIA显卡,如果你选择AMD MI300X,需要投入更多精力进行环境配置和代码适配,尤其是处理一些非标准的算子时,可能需要自行优化Kernel。
避坑建议
不要盲目追求最新型号,对于大多数应用,上一代旗舰卡的性能已经过剩,且价格更具优势,关注显存带宽而非仅仅关注显存容量,在LLM推理中,带宽往往是瓶颈,H20的高带宽特性在此时体现明显,预留20%-30%的显存余量,用于处理动态批处理和系统开销,避免因显存碎片化导致的服务中断。
AI大模型显卡选择常见问题解答
2026年AI大模型显卡选择中,H20和L20哪个更适合初创企业?
初创企业通常预算有限且团队规模较小,对运维复杂度敏感,L20在推理场景下性价比更高,且显存容量足以应对大多数中小规模模型的部署需求,除非有明确的训练需求,否则L20是更稳妥的选择,其功耗更低,散热要求也相对宽松,适合部署在普通机房环境中。
RTX 4090能运行多大的大模型?
RTX 4090拥有24GB显存,在FP16精度下可运行约13B-14B参数的模型,若使用4-bit量化技术,可运行70B参数的大模型,但推理速度会显著降低,且需接受一定的精度损失,对于需要更高并发的场景,建议考虑多卡互联或使用云端算力。
AMD MI300X在2026年的软件兼容性如何?
截至2026年,AMD的ROCm软件栈已支持主流深度学习框架,包括PyTorch 2.x和TensorFlow 2.15+,对于常见的Transformer架构模型,兼容性良好,但在处理某些小众算子或旧版代码时,可能仍需进行少量代码修改或依赖社区提供的补丁,总体而言,其生态成熟度已足以支撑生产环境部署。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/380162.html

评论列表(1条)
H20?那叫特供版吧哈哈。不过4090确实香,就是怕被查到挖矿。各有各的理吧,别争了,有钱上A,没钱上N,大家都对!