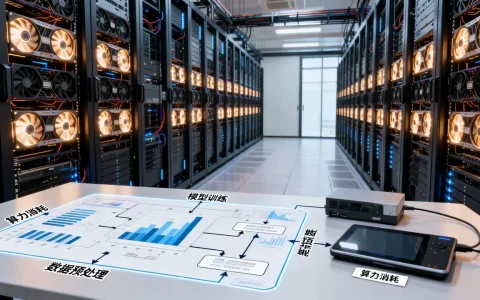
大模型分布式训练采用数据并行策略,核心在于将数据集切分后分发至多卡同步梯度,通过All-Reduce通信机制实现模型参数的一致性更新,这是解决显存瓶颈、提升训练吞吐量的标准工业实践。
随着大语言模型参数量突破千亿甚至万亿级别,单机单卡的显存限制已成为制约模型迭代速度的最大障碍,业内专家指出,单纯依靠增加单卡显存不仅成本高昂,且存在物理上限,因此分布式训练架构成为必然选择,数据并行(Data Parallelism, DP)作为最基础且易于实现的并行策略,通过复制模型副本并分散数据负载,有效平衡了计算与通信开销,是目前大多数企业落地大模型训练的首选方案。

数据并行核心原理与架构解析
理解数据并行,首先要打破“一张卡跑完所有数据”的传统思维,在数据并行模式下,每个GPU都持有完整的模型权重副本,训练过程并非串行执行,而是高度并行的。
前向传播与反向传播机制
具体执行流程如下:
- 数据分片:原始训练数据集被均匀切分为多个批次(Batch),每个批次分配给不同的GPU。
- 独立计算:每个GPU使用本地数据批次,基于持有的完整模型副本进行前向传播,计算损失值。
- 梯度同步:随后,各GPU独立执行反向传播,计算梯度,不同GPU上的梯度可能存在差异,因为数据分布不同。
- All-Reduce聚合:这是关键步骤,系统通过NCCL等通信库,执行All-Reduce操作,将所有GPU计算的梯度求平均值,得到全局平均梯度。
- 参数更新:每个GPU使用这个全局平均梯度,同步更新本地的模型权重。
由于每轮迭代后所有GPU的权重保持一致,下一轮迭代开始时,它们依然拥有相同的模型状态,这种机制确保了模型收敛方向的一致性,同时利用了多卡算力。

与模型并行的本质区别
许多初学者容易混淆数据并行与张量并行(Tensor Parallelism),业内共识认为,两者的核心区别在于“切分对象”不同,数据并行切分的是“数据”,模型本身保持完整;而张量并行切分的是“模型层”,将单个算子拆分到多卡上计算,对于中小规模模型或显存充足的场景,数据并行是效率最高的选择;当模型大到单卡无法容纳单层权重时,才需引入张量并行。
主流框架实现与代码实操
在实际工程中,手动实现数据并行涉及复杂的通信逻辑,极易出错,目前主流的大模型训练框架均内置了高效的数据并行模块,开发者只需配置即可。
PyTorch DDP实战路径
PyTorch的分布式数据并行(DDP)是最广泛使用的解决方案,其核心优势在于支持梯度累积和动态形状处理,以下是标准操作路径:
- 初始化进程组:使用
torch.distributed.init_process_group初始化后端(如NCCL),设置端口和进程数量。 - 封装模型:将普通模型包裹在
torch.nn.parallel.DistributedDataParallel中。 - 调整DataLoader:使用
DistributedSampler确保每个进程获取不重复的数据子集,避免数据重叠导致的训练偏差。 - 执行训练循环:代码逻辑与普通训练几乎无异,DDP会在后台自动处理梯度同步。
关键代码配置示例
# 伪代码示例,展示核心配置
model = MyModel()
model.to(device)
model = DDP(model, device_ids=[local_rank])
# 数据加载器必须使用分布式采样器
train_sampler = DistributedSampler(dataset)
train_loader = DataLoader(dataset, batch_size=..., sampler=train_sampler)

FSDP:显存优化的进阶选择
当模型参数量极大,即使采用数据并行,单卡显存仍可能溢出时,全分片数据并行(FSDP, Fully Sharded Data Parallel)是更优解,据工信部相关技术白皮书显示,FSDP通过将模型参数、梯度和优化器状态在进程间分片存储,可显著降低显存占用。
相比标准DDP,FSDP的显存效率提升可达数倍,其工作原理是将模型参数分片存储在不同GPU上,前向传播时临时收集参数,反向传播时再分发,虽然通信开销略有增加,但换来了极高的显存利用率,特别适合训练百亿级以上参数的大模型。
性能调优与常见问题排查
部署数据并行训练并非一蹴而就,通信瓶颈往往是性能提升的拦路虎。
通信开销与带宽优化
数据并行的效率取决于GPU间的通信速度,在大规模集群中,All-Reduce操作产生的通信量巨大。
- 拓扑感知:确保服务器内部GPU通过NVLink高速互联,服务器间通过InfiniBand网络互联。
- 梯度压缩:对于带宽受限的场景,可采用梯度压缩技术,减少传输数据量。
- 混合精度训练:结合FP16或BF16格式,不仅减少显存占用,还能加速矩阵运算和通信传输。
常见故障排除指南
在实际操作中,开发者常遇到以下问题:
- 死锁(Deadlock):通常由数据加载不均或通信同步失败引起,检查
DistributedSampler是否正确设置,确保每个进程的数据量一致。 - 显存泄漏:监控显存使用情况,检查是否有未释放的中间变量,建议使用

torch.cuda.empty_cache()
- 收敛异常:若损失函数震荡,可能是学习率未随卡数线性缩放,通常建议学习率与总Batch Size成正比,即
新学习率 = 基础学习率 (当前卡数 / 基础卡数)。

大模型分布式训练数据并行教程Q&A
大模型数据并行与模型并行如何选择?
选择依据主要取决于模型规模与硬件资源,若模型参数较小,单卡可容纳完整模型,优先选择数据并行,因其实现简单、通信开销低、扩展性好,若模型过大,单卡无法容纳单层权重,或显存成为主要瓶颈,则需引入张量并行或流水线并行,业内专家建议,对于千亿参数模型,通常采用数据并行结合张量并行的混合策略,以兼顾显存效率与计算速度。
数据并行训练时,学习率应该如何调整?
学习率调整遵循线性缩放规则,当Batch Size增大时,梯度噪声减小,模型收敛更稳定,因此可以适当增大学习率,具体而言,若将Batch Size扩大N倍,学习率也应大致扩大N倍,使用1张卡时学习率为1e-4,使用8张卡进行数据并行时,总Batch Size变为8倍,学习率应调整为8e-4,这一规则适用于大多数Transformer架构的大模型训练,但需结合具体任务进行微调。
FSDP相比传统DDP有哪些具体优势?
FSDP的核心优势在于极致的显存优化,传统DDP中,每张卡都存储完整的模型参数、梯度和优化器状态,显存占用随参数量线性增长,而FSDP将这些状态分片存储,单卡仅需存储部分参数,据统计,在训练超大模型时,FSDP可将单卡显存占用降低至DDP的1/3甚至更低,FSDP支持细粒度的通信优化,仅在需要时通信必要数据,进一步提升了训练效率,是目前大模型训练的主流技术选型。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/391287.html