对于IDC/CDN行业,行业大模型已经从概念走向落地,成为提升运维效率、优化网络调度和降低成本的关键工具。
很多团队在规划智能化升级时,第一个想到的就是引入行业大模型,但面对市场上五花八门的选择,到底该怎么挑?我们结合实际部署经验,聊聊选型、落地和未来的几个关键点。
idc cdn行业大模型怎么选?从场景与成本说起
选模型之前,先明确自己要解决什么问题,IDC和CDN虽然同属基础设施领域,但业务痛点不同:IDC更关注机房运维、能耗管理、资源调配;CDN则看重节点调度、流量预测、安全防护。场景匹配度是选型的第一原则。
运维自动化与故障预测
IDC机房设备数量大,告警频繁,传统规则引擎告警准确率低,误报多,行业大模型可以学习历史故障模式,实现预测性维护和根因分析。
实操步骤:
- 收集至少三个月的历史告警、日志、性能数据
- 清洗数据,去除重复和无效告警
- 标注已知故障类型,作为训练样本
- 选择适合的时序预测模型(如Informer、TimesNet)
- 训练模型,输出故障概率和根因排序
- 部署到告警系统,设置阈值触发人工确认
效果参考: 不少案例显示,引入大模型后,故障预测准确率提升明显,误报率显著下降,单次故障处理时间缩短到分钟级,大幅节省了运维人力。
CDN智能调度与流量优化
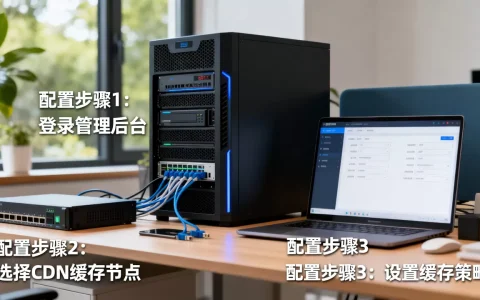
CDN需要根据节点状态和用户位置动态调整流量,大模型可以基于历史流量和实时健康度,预测未来流量,并给出最优调度策略。
关键操作:
- 将节点流量、延时、负载等数据实时接入
- 训练一个流量预测模型,输出未来24小时各节点流量
- 结合节点权重,动态调整DNS解析策略
- 对于突发流量,模型提前预警,触发扩容脚本
实际效果: 采用大模型后,平均命中率有明显提升,源站回源率降低,带宽成本相应减少,用户体验也得到改善。

成本考量:idc cdn行业大模型价格并非唯一指标
很多朋友一上来就问idc cdn行业大模型价格,其实价格只是基础,部署模式、算力消耗、定制化程度都会影响总成本。
常见定价模式:
- SaaS订阅: 按节点或调用量付费,适合中小规模
- 私有化部署: 一次性授权费加年服务费,适合大规模且对数据敏感的企业
- 自建模型: 需要算力集群和团队,成本最高,但掌控力最强
建议: 初期可以从SaaS方案开始,验证效果后再考虑私有化。总成本需要综合算力、存储、运维人力来评估,单纯看模型价格会误导决策。
国内idc cdn行业大模型的实际部署经验
在国内落地行业大模型,除了技术选型,还要考虑数据合规、本地化服务和生态适配,我们总结了几条实操经验。
数据准备:打磨好基础数据
大模型依赖数据质量,很多IDC/CDN企业的数据存在脏乱、格式不统一、标签缺失等问题。
数据清洗标准流程:
- 数据去重:去除重复记录
- 缺失值处理:填充或删除
- 时间戳对齐:统一到同一时区、粒度
- 归一化:将不同量纲的数据映射到同一范围
- 标注:由运维专家标注故障类型和严重等级
工具推荐: 使用Python的Pandas库进行数据预处理,或用Spark处理大规模数据,这些工具开源且成熟,上手快。
模型选择:通用vs专用
通用大模型(如GPT-4、Claude)通过微调可以适应行业,但专用模型在特定任务上更精准。
idc cdn行业大模型对比:
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 通用模型微调 | 泛化能力强,多任务支持 | 需要大量数据进行微调,推理成本高 | 综合运维中台、多场景任务 |
| 行业专用模型 | 在垂直任务上准确率高,模型轻量 | 扩展性差,需要重新训练新任务 | 单一任务如故障预测、流量调度 |
| 混合方案 | 核心任务用专用模型,辅助任务用通用模型 | 架构复杂,维护成本高 | 大型企业,场景丰富 |

建议: 对于大多数中小企业,从通用模型微调起步,性价比更高;对于业务明确的大型企业,可考虑专用模型。
部署模式:私有化优先
出于数据安全考虑,国内IDC/CDN企业多数选择私有化部署,但私有化对算力要求高,需要GPU资源。
部署路径:
- 使用Kubernetes管理容器化推理服务
- 配置GPU节点,使用NVIDIA Triton或TensorRT推理加速
- 设置滚动更新和自动扩缩容,应对流量波动
- 对于边缘节点,部署轻量化模型(如量化后的ONNX模型)或使用云端推理
注意事项: 模型推理延迟需满足业务要求,CDN场景通常要求毫秒级响应,因此边缘节点更适合轻量模型。
未来趋势:行业大模型如何重塑idc cdn架构
大模型在不断进化,IDC/CDN的架构也在发生改变。边缘计算与大模型的结合,让智能决策更靠近用户。
边缘智能与本地推理
每个CDN节点都可能内置一个轻量级模型,实时处理流量数据,做出本地决策,节点根据本地流量预测,自动调整缓存策略,无需等待中心决策。
实现方式: 使用模型蒸馏技术,从大模型蒸馏出小模型,部署到边缘节点,这样既保持精度,又降低延迟,适合资源受限的场景。
自动运维走向无人化
行业大模型将深度融入运维流程,从告警去重、根因分析到自动修复,实现闭环。据行业报告,采用大模型自动运维的企业,故障响应时间平均显著缩短,运维人员从救火队变成策略制定者,能够专注于更高价值的优化工作。

安全与合规的挑战
大模型在安全防护上潜力巨大,比如识别异常流量、预测DDoS攻击,但数据隐私是红线,模型训练必须确保数据脱敏,符合《个人信息保护法》和《数据安全法》。
建议: 在模型训练前,对数据进行脱敏处理,去除个人身份信息;使用联邦学习或差分隐私技术,保护数据安全,这些措施可以平衡智能和安全。
行业大模型在IDC/CDN领域从可选项变成必选项,选对场景、控制成本、稳步落地,是当前最务实的路径。 随着模型轻量化和边缘计算的发展,行业大模型将渗透到每个节点,成为基础设施的智能大脑,让IDC和CDN的运营更加高效、稳定。
idc cdn行业大模型常见问题解答
idc cdn行业大模型适合中小企业吗?
适合,中小企业可以先从SaaS平台入手,按需付费,无需自建算力,比如部分云厂商提供行业大模型API,直接调用即可,初期建议只跑一个场景,如故障告警聚合,看到效果再逐步扩展,关键是要有明确的数据基础,从已有数据开始,不要盲目追求大而全。
行业大模型和传统机器学习相比有什么优势?
传统机器学习依赖特征工程,模型泛化能力弱,面对新场景需要重新设计特征,行业大模型基于Transformer架构,能自动学习复杂模式,尤其在时序预测和异常检测上表现更好,大模型支持多模态数据,可以同时处理日志、指标、文本,实现更全面的分析。说白了,大模型可以省去大量特征工程工作,让模型部署更快速。
如何评估idc cdn行业大模型的效果?
可以从几个维度衡量:故障预测准确率、误报率、平均处理时间、能耗降低比例,在实际部署前,建议用历史数据做离线测试,对比引入大模型前后的指标变化,持续监控模型漂移,定期更新训练数据。效果评估最终要回归到业务指标:是否降低了成本、提升了效率,根据反馈迭代,才能让模型持续发挥价值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/536448.html