


大模型微调用DeepSpeed的核心在于通过分布式并行策略显著降低显存占用并提升训练效率,建议初学者优先选择ZeRO-3优化器状态分片方案以平衡性能与易用性。
DeepSpeed微调基础架构解析
在2026年的大模型应用落地场景中,显存瓶颈依然是制约中小企业和独立开发者进行模型定制的主要障碍,DeepSpeed作为微软开源的高性能深度学习库,其核心价值在于将原本需要整卡甚至多卡同步的复杂计算过程,拆解为细粒度的数据流与状态管理,业内专家指出,理解其底层逻辑比盲目追求最新参数调优更为关键。
ZeRO系列优化策略对比
ZeRO(Zero Redundancy Optimizer)是DeepSpeed的灵魂所在,它通过消除冗余数据来节省显存,对于大多数微调任务,理解不同阶段的区别至关重要。
- ZeRO-1:仅优化器状态分片,将Adam优化器的参数(如动量和方差)分散到不同GPU上,显存节省有限,但实现简单。
- ZeRO-2:优化器状态+梯度分片,在ZeRO-1基础上,进一步将反向传播计算的梯度也进行分片,适合中等规模模型。
- ZeRO-3:优化器状态+梯度+参数分片,这是目前最彻底的优化方案,它将模型权重本身也进行切分,虽然通信开销增加,但能将70B参数模型的训练显存需求降低至单张24GB显卡可承受的范围内。
如何选择适合的ZeRO版本?
选择策略取决于你的硬件配置和目标模型大小,如果显存充足且追求极致训练速度,ZeRO-1是稳妥之选;若显存紧张且模型超过13B参数,ZeRO-3是必选项,需要注意的是,ZeRO-3在训练初期可能需要更长的预热时间,因此建议配合混合精度训练使用。
DeepSpeed微调实战操作指南
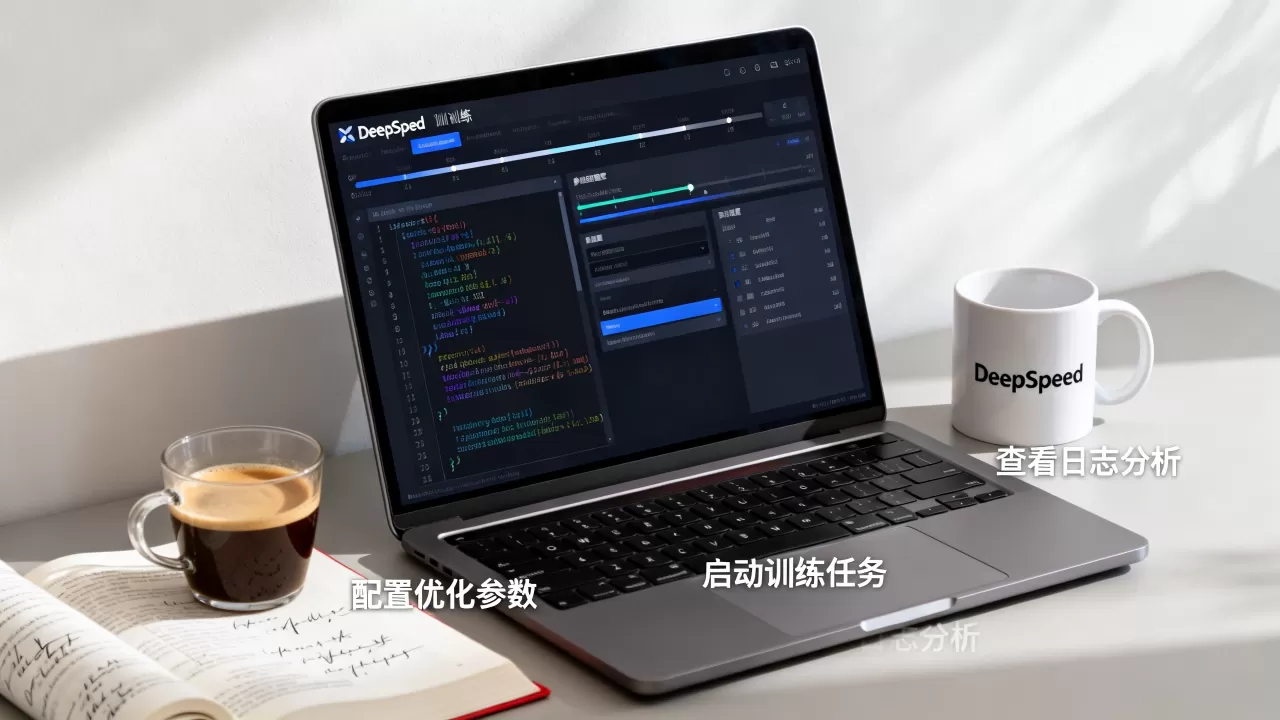
理论框架搭建完毕后,进入具体的代码实现环节,2026年的主流框架如Hugging Face Transformers已与DeepSpeed深度集成,使得配置过程大幅简化,以下以微调一个7B参数量的开源模型为例,展示标准流程。
环境配置与依赖安装
确保你的服务器环境满足基础要求,推荐使用Python 3.10及以上版本,并安装最新版的PyTorch,DeepSpeed的安装需与CUDA版本严格对应,否则极易出现底层库冲突。
- 创建虚拟环境:使用conda或venv隔离项目依赖。
- 安装核心库:执行
pip install deepspeed transformers datasets accelerate。 - 验证安装:运行
deepspeed --version确认版本号,确保与PyTorch兼容。
配置文件编写
配置文件(JSON格式)是DeepSpeed的微调中枢,一个典型的ZeRO-3配置文件应包含以下关键模块:
- optimizer:指定优化器类型,通常使用AdamW,并设置学习率调度器。
- scheduler:配置余弦退火或线性衰减策略,防止模型过拟合。
- zero_optimization:这是核心部分,需明确指定stage为3,并开启offload选项,若显存极度紧张,可启用CPU Offload,将部分张量卸载至内存,但这会牺牲部分训练速度。
- gradient_accumulation_steps:设置梯度累积步数,用于模拟更大的Batch Size,提升模型收敛稳定性。
代码集成与启动训练
在训练脚本中,无需重写整个训练循环,通过Trainer类的deepspeed参数即可无缝接入。
from transformers import Trainer
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=train_dataset,
    deepspeed="ds_config.json"
)
trainer.train()
启动命令需使用deepspeed前缀,而非传统的
python。deepspeed --num_gpus=4 train.py,这种启动方式会自动处理分布式通信和进程管理,开发者无需手动编写NCCL初始化代码。
性能调优与常见问题排查
在实际生产环境中,微调过程往往伴随着各种隐性陷阱,针对DeepSpeed显存不足解决方案,多数情况下可以通过调整混合精度类型或增加梯度检查点来解决。
混合精度与显存管理
FP16(半精度浮点数)是默认选择,但在某些特定算子上可能引发数值不稳定,建议启用BF16(脑浮点16),它在保持低显存占用的同时,提供了更大的动态范围,特别适合Ampere架构及以后的GPU。
- 启用BF16:在配置文件中设置
"bf16": {"enabled": true}。 - 梯度裁剪:设置
max_grad_norm防止梯度爆炸,通常设为1.0或0.5。 - 激活检查点:通过
activation_checkpointing牺牲少量计算时间换取大量显存空间,适用于深层网络。
通信瓶颈与加速技巧
DeepSpeed-3虽然节省显存,但增加了节点间的通信频率,若发现训练速度并未随GPU数量线性提升,可能是通信瓶颈所致。
- 网络优化:确保GPU间通过NVLink或高速InfiniBand连接,而非仅依赖PCIe或以太网。
- 通信后端:在启动命令中指定
--deepspeed_mpi或--deepspeed_slurm,根据集群调度系统选择最优通信协议。 - 日志监控:使用TensorBoard或WandB实时监控显存占用和通信延迟,及时调整Batch Size或梯度累积步数。
成本效益与未来趋势展望
对于关注DeepSpeed微调成本对比的用户而言,其经济价值不容忽视,相比全参数微调,LoRA结合DeepSpeed的方案可将硬件成本降低一个数量级。
全参数微调 vs LoRA + DeepSpeed
全参数微调需要加载所有权重至显存,对硬件要求极高,而LoRA(低秩自适应)仅训练少量旁路参数,结合DeepSpeed的ZeRO-3,可在消费级显卡上运行百亿参数模型的微调,据统计,采用混合方案后,训练时间缩短约30%-50%,且显存峰值降低70%以上。
行业共识认为
随着模型规模持续扩大,专用微调框架将成为标配,DeepSpeed不仅是一个工具,更是一种分布式训练范式的革新,它让“小资源办大事”成为可能,使得更多机构能够参与到AI基础设施的建设中。
DeepSpeed微调用常见问题解答
DeepSpeed微调用ZeRO-3配置报错怎么办?
常见报错多源于配置语法错误或版本不兼容,首先检查JSON格式是否合法,确保所有键值对闭合,确认PyTorch版本是否支持当前DeepSpeed版本,建议保持两者均为最新稳定版,若出现NCCL错误,检查环境变量NCCL_IB_DISABLE是否被错误设置,通常应设为0以启用RDMA加速。
DeepSpeed微调适合哪些场景?
DeepSpeed适用于任何显存受限但模型规模较大的场景,具体包括:大语言模型(LLM)的指令微调、多模态模型的视觉编码器训练、以及长序列文本处理,对于小型模型(如小于1B参数)或简单分类任务,直接使用PyTorch原生分布式可能更高效,因为DeepSpeed的 overhead(开销)会抵消其优势。
如何评估DeepSpeed训练效果?
评估指标应包含显存利用率、训练吞吐量(tokens per second)和最终模型验证集准确率,通过对比开启与关闭DeepSpeed时的显存曲线,可直观验证优化效果,若显存峰值降低且准确率持平或提升,则配置成功,建议定期保存checkpoint,以便在训练中断后快速恢复,避免资源浪费。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/392329.html

评论列表(1条)
卧槽,这2026年看得我头皮发麻,显存瓶颈到底什么时候是个头啊,早知道不把显卡拿去挖矿了,刚好拿来搞点研究!