大模型在推荐领域的微调,核心在于利用高质量用户行为数据对基座模型进行指令对齐与偏好优化,从而显著提升推荐系统的个性化精度与业务转化率。
推荐系统早已不再是简单的协同过滤或点击率预估,随着大语言模型(LLM)展现出强大的语义理解与逻辑推理能力,将其引入推荐领域成为行业共识,直接调用通用大模型无法满足垂直场景的精准需求,微调(Fine-tuning)成为了连接通用智能与特定业务场景的关键桥梁,这一过程并非简单的“喂数据”,而是一套严谨的工程化流程,涉及数据清洗、指令构建、模型训练及效果评估等多个环节。
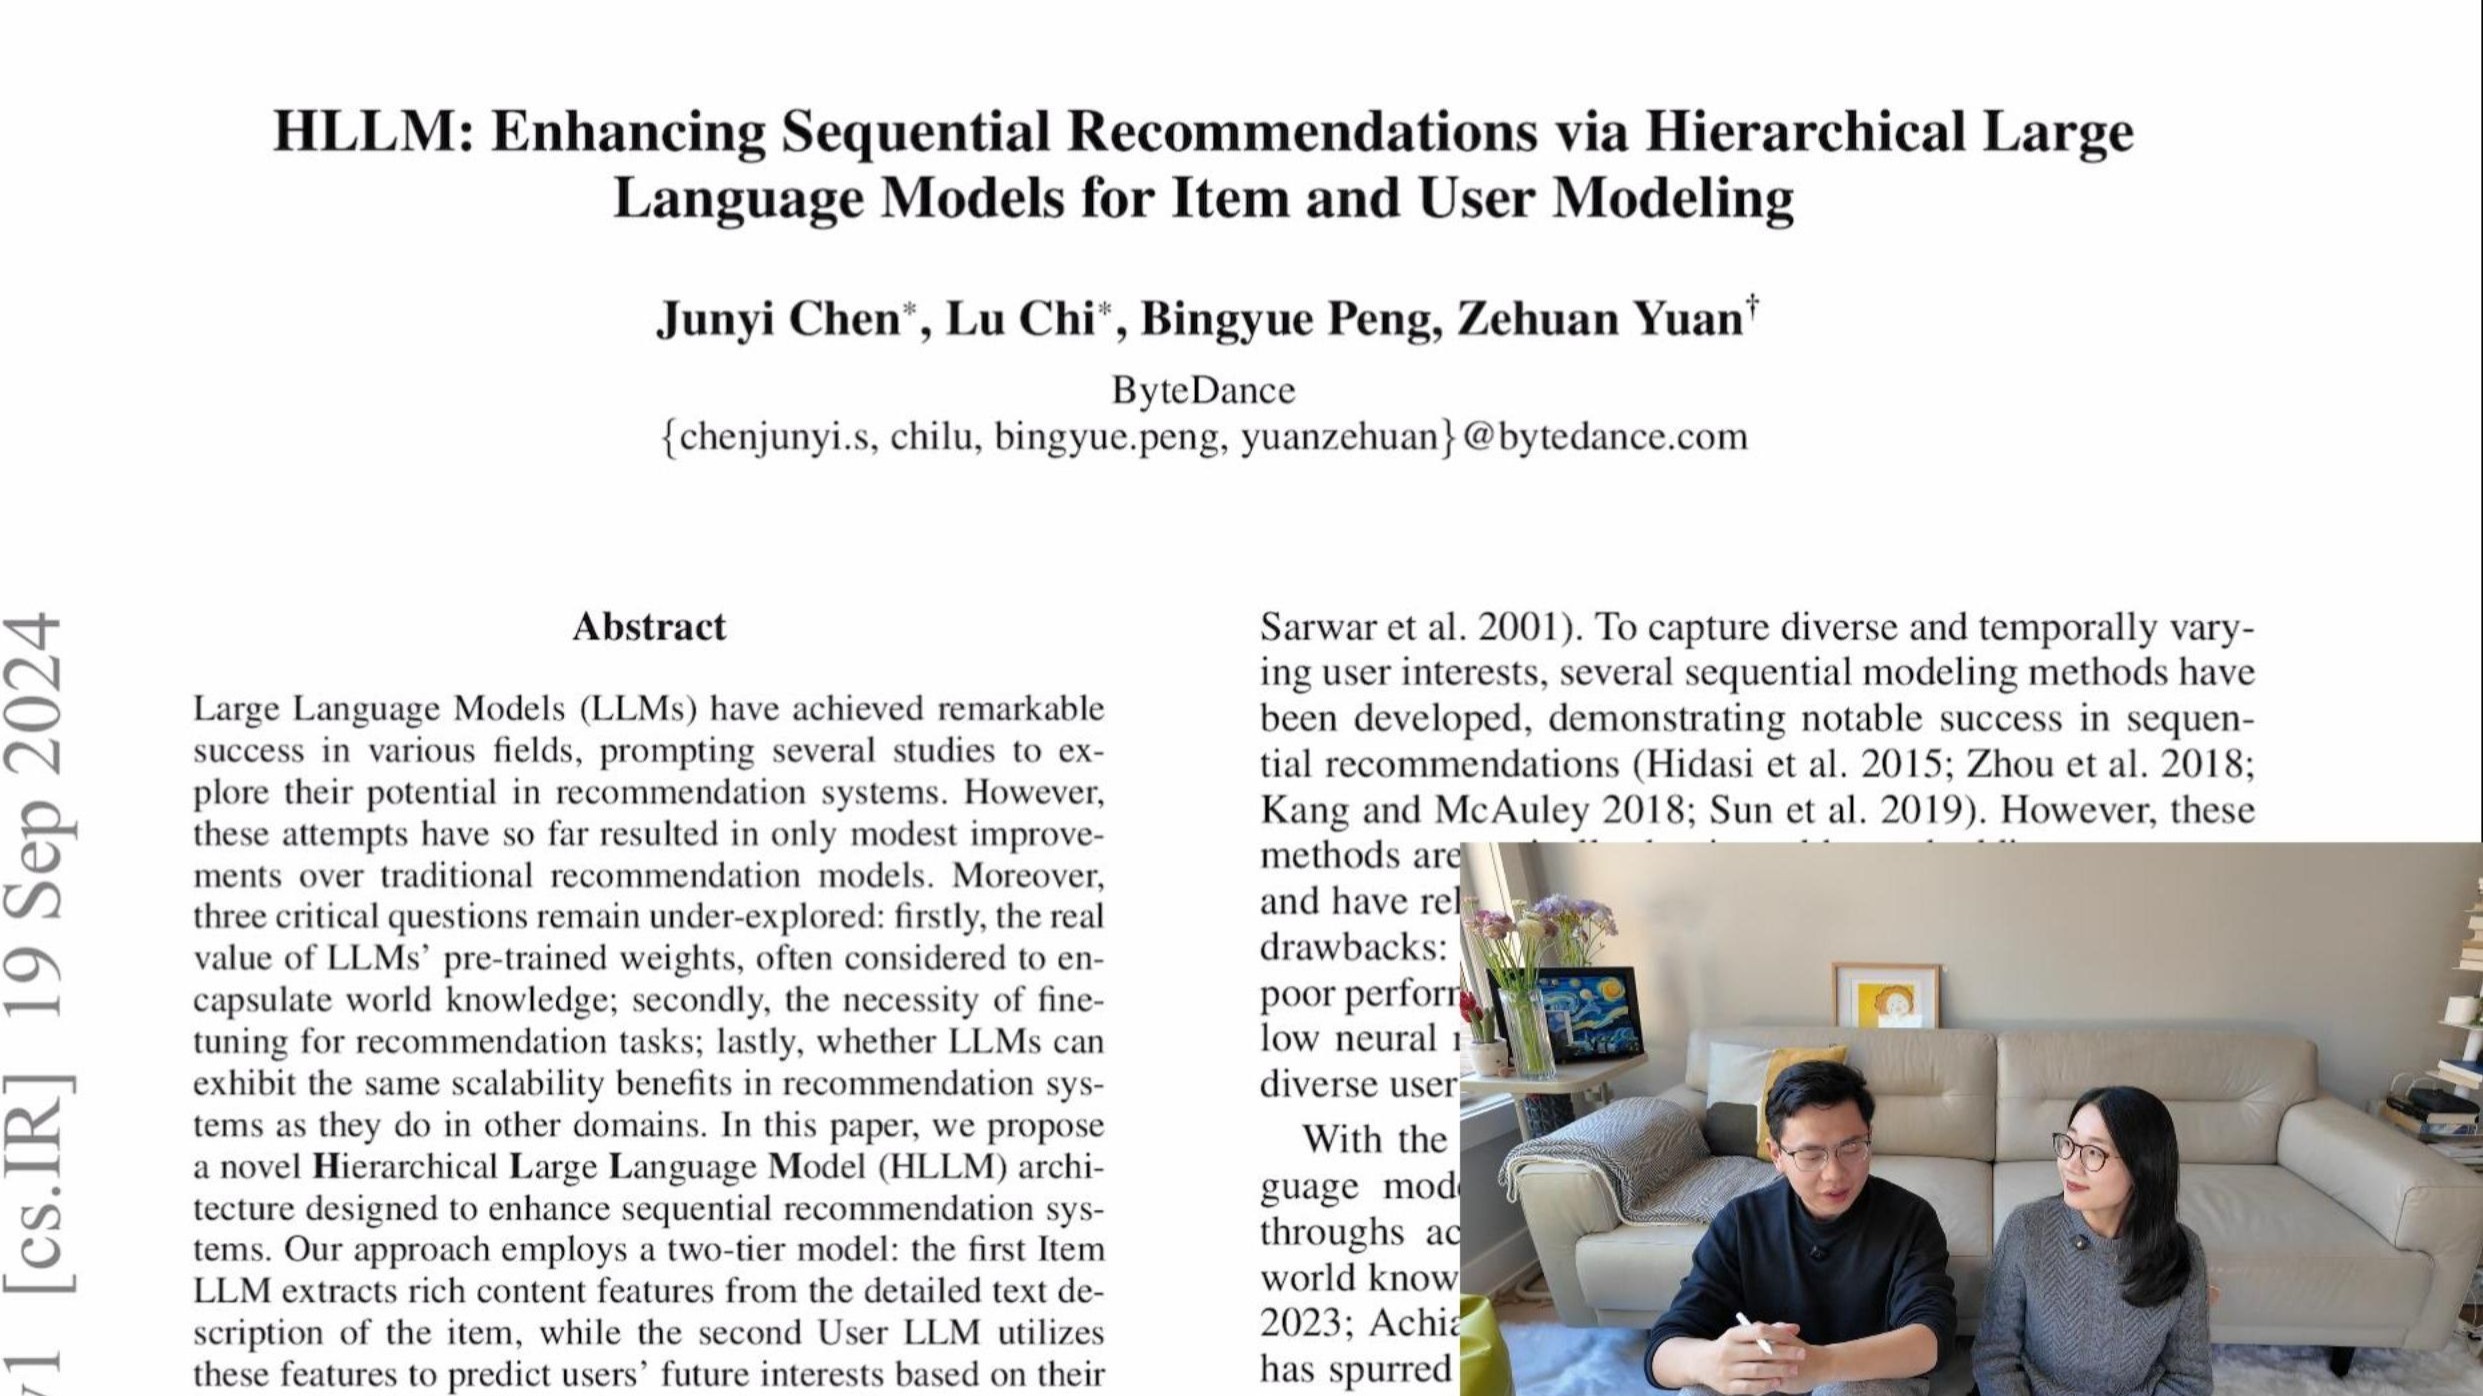

为什么推荐场景需要专门微调大模型
通用大模型虽然博学,但在处理推荐任务时存在明显的局限性,它们缺乏对特定平台用户画像、商品属性以及实时交互数据的深度理解,业内专家指出,未经微调的模型往往给出泛泛而谈的建议,无法捕捉用户细微的偏好变化。
解决语义鸿沟与冷启动问题
推荐系统面临的最大挑战之一是“冷启动”,当新用户或新商品出现时,传统基于统计的方法因缺乏历史数据而失效,大模型具备强大的零样本(Zero-shot)或少样本(Few-shot)学习能力,能够通过理解商品标题、描述文本以及用户的历史交互语义,快速建立初步连接。
- 语义理解优势:大模型能理解“适合送礼的红色口红”这类复杂查询,而传统模型只能匹配关键词。
- 长尾商品激活:对于销量低但属性独特的长尾商品,大模型能通过语义相似性将其推荐给潜在感兴趣的用户,激活长尾流量。
提升可解释性与用户信任
传统的黑盒推荐模型难以向用户解释“为什么推荐这个”,微调后的大模型可以生成自然语言推荐理由,如“根据您的浏览记录,这款降噪耳机符合您对通勤安静环境的需求”,这种可解释性显著提升了用户的点击意愿和信任度。

大模型推荐微调的核心实操步骤
微调不是魔法,而是数据与算法的精密配合,以下流程基于行业主流实践,适用于大多数基于Transformer架构的大模型。
第一步:构建高质量指令数据集
数据质量决定微调上限,推荐场景的数据构建需遵循“指令-输入-输出”三元组结构。
数据清洗与去噪
原始用户行为日志包含大量噪声,如误触、刷单或无效曝光,必须通过规则过滤和异常检测算法剔除脏数据,据统计,清洗后的有效数据占比通常不足原始数据的30%,但这部分数据才是模型学习的核心。
指令工程与格式标准化
将结构化数据转化为自然语言指令。
- 输入:用户ID、历史点击商品列表、当前查询词。
- 指令:“请根据用户历史偏好,从候选商品列表中推荐最合适的3个商品,并说明理由。”
- 输出:商品ID及推荐理由文本。
第二步:选择合适的微调策略
全量微调成本高昂且易导致灾难性遗忘,目前主流方案采用参数高效微调(PEFT)。
LoRA与QLoRA的应用
低秩自适应(LoRA)技术通过在预训练模型的权重矩阵中添加低秩分解矩阵进行训练,仅更新少量参数,QLoRA进一步引入4位量化技术,大幅降低显存需求。
- 成本对比:相比全量微调,LoRA可将显存占用降低约70%,训练速度提升2-3倍。
- 效果保持:在推荐任务中,LoRA微调后的模型性能通常能达到全量微调的95%,性价比极高。
多阶段训练策略
建议采用两阶段训练法:
- 通用指令微调:使用通用问答数据,提升模型的指令遵循能力。
- 领域适配微调

:使用推荐领域数据,强化模型对商品和用户偏好的理解。

第三步:训练监控与超参数调优
训练过程中需密切关注损失函数(Loss)的变化趋势。
- 学习率设置:通常设置为1e-4至5e-5之间,过小导致收敛慢,过大导致模型震荡。
- 批次大小(Batch Size):根据显存容量调整,一般建议设置为16或32,以平衡梯度估计的稳定性与训练速度。
- 早停机制:当验证集损失不再下降时,立即停止训练,防止过拟合。
评估体系与线上部署挑战
微调完成后,如何验证效果并稳定上线是另一道关卡。
离线评估指标
除了传统的准确率(Precision)和召回率(Recall),推荐场景更关注排序指标。
- NDCG@K:归一化折损累计增益,衡量推荐列表的整体排序质量。
- MRR:平均倒数排名,关注首个相关商品的排名位置。
线上A/B测试
线上评估是最终真理,需设计严格的A/B测试实验,对比微调模型与基线模型的核心业务指标。
- 核心指标:点击率(CTR)、转化率(CVR)、人均停留时长。
- 副作用监测:监控推荐结果的多样性与新颖性,避免信息茧房效应加剧。
常见误区与避坑指南
在实际操作中,许多团队容易陷入以下误区,导致微调效果不佳。
数据量并非越多越好
盲目追求数据规模而忽视质量,会导致模型学习到噪声模式,业内共识认为,数千条精心构造的高质量指令数据,往往优于数十万条粗糙的原始日志。
忽视推理延迟
大模型推理速度慢是制约线上应用的主要因素。
- 量化部署:使用INT8或INT4量化模型,可在精度损失极小的情况下,将推理速度提升
2-4倍
。 - 缓存机制:对高频用户画像和商品Embedding进行缓存,减少重复计算。

过度依赖模型能力
大模型并非万能,对于强实时性、高并发的推荐场景,仍需结合传统深度学习模型(如DeepFM、DIN)进行混合架构设计,大模型更适合用于重排序(Re-ranking)或生成推荐理由,而非从头生成所有候选集。
大模型推荐领域微调常见问题解答
大模型推荐领域微调需要多少数据量
对于垂直领域的推荐任务,通常不需要海量数据,一般建议准备1000至5000条高质量、经过人工校验的指令-响应对即可启动微调,若数据量不足,可通过数据增强技术(如改写指令、合成负样本)扩充数据集,关键在于数据的多样性和标注准确性,而非单纯的数量堆砌。
微调后模型出现幻觉如何处理
幻觉是大模型生成不符合事实内容的现象,在推荐场景中,表现为推荐了不存在的商品或错误的属性,解决方法包括:
- 约束解码:限制模型只能从候选商品ID列表中选择,禁止生成未授权内容。
- 检索增强生成(RAG):将实时检索到的商品知识作为上下文输入模型,确保生成内容基于真实数据。
- 后处理校验:在模型输出后,增加一层规则校验模块,过滤掉明显违背业务逻辑的结果。
微调成本与商业可行性如何平衡
微调成本主要取决于模型规模和训练时长,采用QLoRA等高效微调技术,单卡GPU即可在数天内完成中等规模模型的训练,成本可控,对于中小企业,可考虑使用云服务商提供的微调平台,按量付费,避免自建基础设施的高昂固定成本,随着模型蒸馏技术的发展,未来可将大模型能力迁移至小模型,进一步降低线上推理成本。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/393248.html