


大模型RLAIF(基于人类反馈的强化学习)的核心在于通过AI生成反馈数据来替代或辅助人工标注,从而以更低的成本、更高的效率优化大模型的对齐效果,解决传统RLHF在数据稀缺和标注成本高昂上的痛点。
为什么大模型需要RLAIF技术
在2026年的AI应用生态中,通用大模型已经具备了强大的基础能力,但如何让模型更懂人类意图、更符合伦理规范,成为了行业竞争的焦点,传统的RLHF(基于人类反馈的强化学习)虽然有效,但面临着巨大的瓶颈。
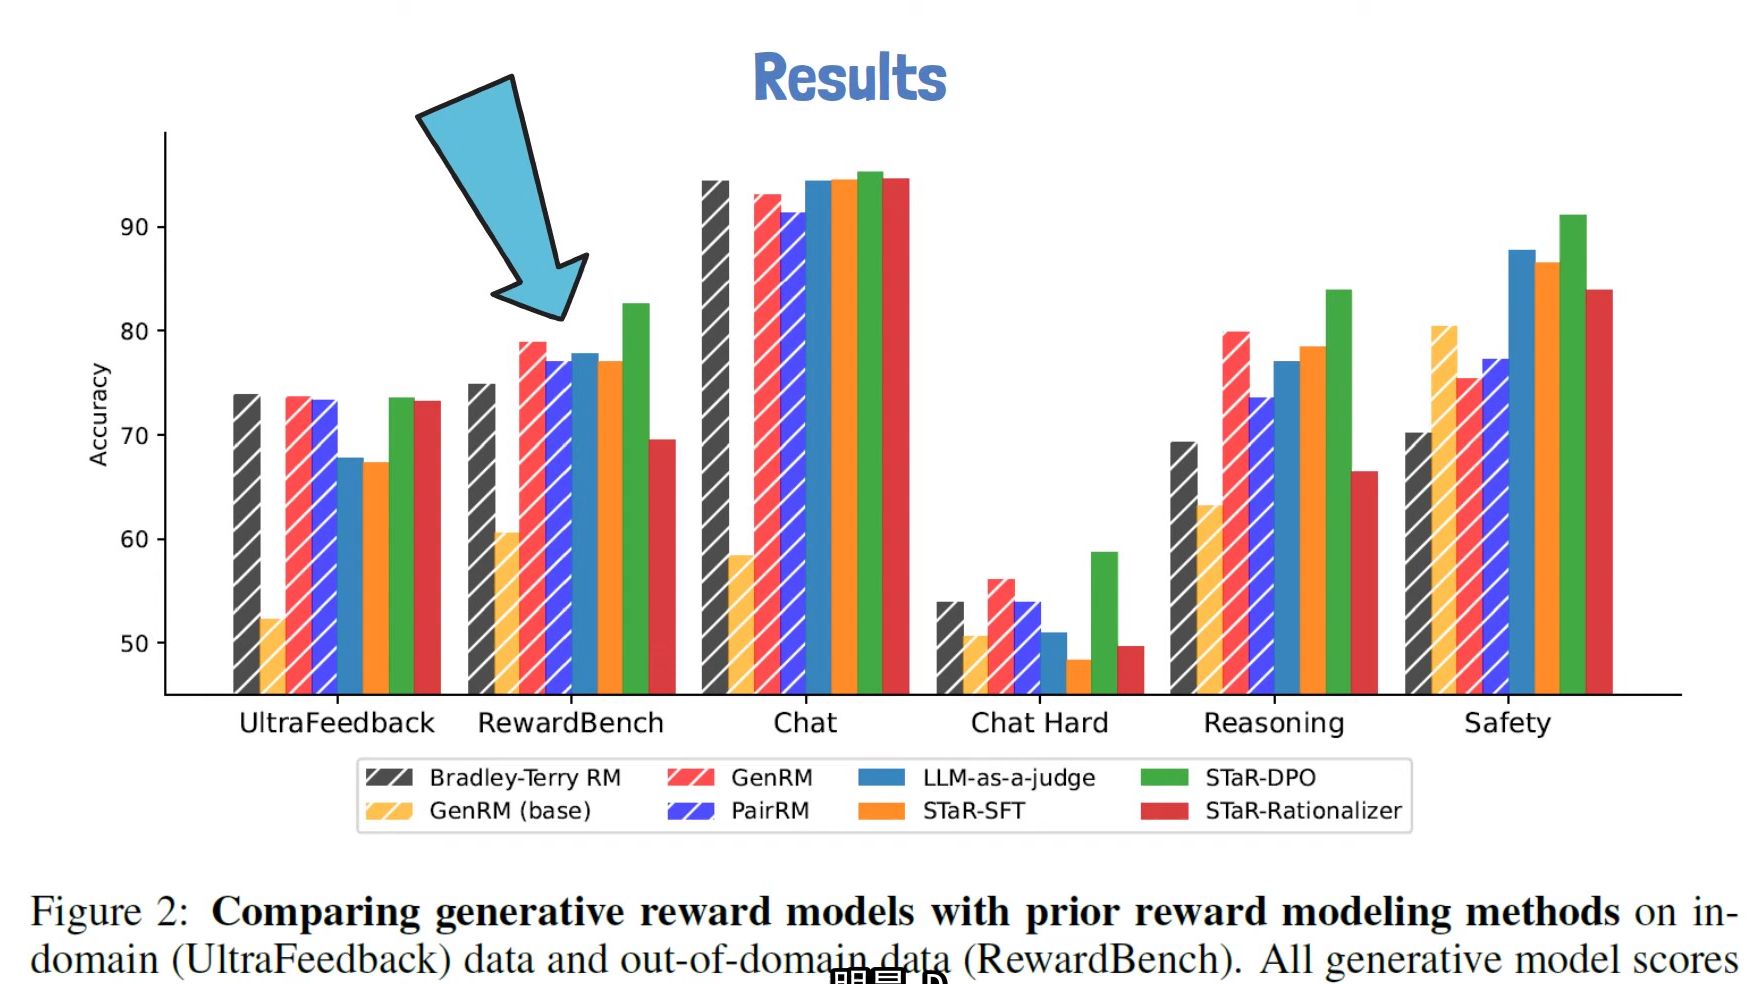
业内专家指出,人工标注不仅成本高昂,而且存在主观性偏差,当模型规模达到千亿甚至万亿参数时,依靠人工构建高质量的对齐数据集变得几乎不可持续,RLAIF的出现,正是为了解决这一规模化难题,它利用一个经过微调的“裁判模型”来生成反馈信号,替代了部分或全部的人工标注工作。
RLHF与RLAIF的核心差异对比
为了更清晰地理解两者的区别,我们可以从以下几个维度进行对比:
- 数据来源:RLHF依赖真实人类专家的评分和排序;RLAIF依赖预训练或微调后的AI模型生成偏好数据。
- 成本效率:RLHF需要大量人力投入,周期长,成本高;RLAIF通过自动化生成反馈,显著降低了标注成本,提升了迭代速度。
- 一致性:人类标注容易受情绪、疲劳影响,标准不一;AI裁判模型在相同输入下能保持较高的一致性,减少噪声。
- 扩展性:RLHF难以扩展到多语言、小众领域;RLAIF可以轻松扩展至任何有足够预训练数据的领域。
具体场景下的应用差异
以医疗问答为例,如果采用RLHF,需要聘请大量医生对成千上万条回答进行评分,这不仅耗时,且不同医生的判断标准可能存在差异,而采用RLAIF,可以先训练一个专门针对医疗领域的“裁判模型”,让它对模型生成的回答进行打分和排序,虽然AI裁判可能存在幻觉,但通过引入人类抽检机制,可以有效控制风险,同时大幅降低标注成本。
RLAIF的技术实现路径
RLAIF并非简单地替换标注人员,而是一套完整的技术流程,其核心逻辑是利用一个大模型作为“教师”,指导另一个模型作为“学生”进行优化。
第一步:构建偏好数据集
这是RLAIF的基础,通常的做法是:
- 生成候选回答:让一个大模型针对同一问题生成多个不同的回答。
- AI裁判排序:使用另一个经过指令微调的模型(即裁判模型),对这些回答进行排序或打分,裁判模型通常基于简单的规则或预训练知识,判断哪个回答更符合逻辑、更安全或更有帮助。
- 数据清洗:虽然AI生成数据效率高,但仍需引入少量人工抽检,剔除明显的错误排序,确保训练数据的质量。
第二步:训练奖励模型
基于生成的偏好数据,训练一个奖励模型(Reward Model),这个模型的作用是给模型的输出打分,分数越高代表越符合人类偏好,在RLAIF中,这个奖励模型是由AI生成的反馈数据训练出来的,而非人工标注数据。
第三步:强化学习优化
使用PPO(近端策略优化)等强化学习算法,结合奖励模型的反馈,对基础大模型进行微调,在这个过程中,模型会不断尝试生成高分回答,从而逐渐对齐人类价值观。
实操中的关键技巧
在实际操作中,为了提高RLAIF的效果,业内共识认为需要关注以下几点:
- 裁判模型的多样性:使用多个不同架构或训练数据的裁判模型生成反馈,通过投票机制减少单一模型的偏差。
- 温度参数调整:在生成候选回答时,适当调整温度参数,增加回答的多样性,避免模型陷入局部最优。
- 人类反馈闭环:定期引入人工反馈,对AI裁判的排序结果进行修正,形成“AI生成-人工校验-模型更新”的闭环。
RLAIF在实际应用中的挑战与对策
尽管RLAIF优势明显,但在落地过程中仍面临不少挑战,如何确保AI裁判的公正性、避免模型自我强化导致的偏差,是开发者必须解决的问题。
避免模型自我复制偏差
如果裁判模型和生成模型过于相似,可能会出现“自嗨”现象,即模型只喜欢自己生成的回答,而忽略了外部视角,对策包括:
- 解耦训练:确保裁判模型和生成模型在训练数据上有一定的独立性。
- 引入外部知识:在裁判模型的训练数据中,加入大量来自互联网、书籍等外部知识,增强其客观性。
处理长尾场景
对于某些小众领域或长尾问题,预训练的裁判模型可能缺乏足够的知识储备,导致反馈质量下降,可以采用以下策略:
- 领域微调:针对特定领域,使用少量高质量人工数据对裁判模型进行微调,提升其在该领域的判断能力。
- 混合反馈机制:在长尾场景中,结合人工反馈和AI反馈,以人工反馈为主,AI反馈为辅。
成本与效果的平衡
在实际项目中,开发者往往需要在成本和效果之间找到平衡点,据统计,完全依赖AI反馈可能在某些复杂任务上表现不佳,而完全依赖人工标注则成本过高,多数情况下,采用“AI为主,人工为辅”的混合模式是较为理想的选择。
2026年RLAIF的未来发展趋势
随着AI技术的不断进步,RLAIF也在不断演进,未来的发展方向主要集中在以下几个方面:
更智能的裁判模型
随着多模态大模型的发展,裁判模型将不再局限于文本,而是能够处理图像、音频、视频等多种模态的数据,这将极大地拓展RLAIF的应用范围,使其在视频生成、语音交互等领域发挥更大作用。
自动化程度提升
未来的RLAIF系统将更加自动化,减少人工干预的需求,通过引入自我进化机制,裁判模型能够自动发现并修正自身的错误,进一步提升反馈质量。
伦理与安全强化
随着AI在社会各领域的深入应用,伦理和安全问题日益突出,未来的RLAIF将更加注重价值观对齐,确保模型生成的内容符合社会公序良俗,避免产生有害信息。
常见问题解答
RLAIF与RLHF哪个更适合中小企业
对于中小企业而言,RLAIF通常更具优势,由于中小企业往往缺乏足够的人力资源和资金进行大规模人工标注,RLAIF通过AI生成反馈数据,显著降低了数据准备成本,RLAIF的迭代速度快,能够帮助中小企业快速推出符合市场需求的产品,如果企业拥有特定的垂直领域专家资源,且对数据质量要求极高,RLHF可能仍是更好的选择。
RLAIF生成的数据是否可靠
RLAIF生成的数据可靠性取决于裁判模型的质量,如果裁判模型经过充分训练,并引入了人工校验机制,其生成的数据通常是可靠的,由于AI模型可能存在幻觉或偏见,完全依赖AI反馈可能导致模型在某些边缘场景下表现不佳,建议在实际应用中,结合人工抽检和混合反馈机制,以确保数据质量。
如何评估RLAIF模型的效果
评估RLAIF模型的效果,通常采用定量和定性相结合的方法,定量方面,可以使用自动化指标如BLEU、ROUGE等,以及基于奖励模型的打分;定性方面,则需要人工抽样评估模型回答的逻辑性、安全性和有用性,还可以进行A/B测试,对比使用RLAIF优化前后的模型在实际用户场景中的表现,以直观评估其效果提升程度。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/393979.html

评论列表(1条)
卧槽2026年都来了?看着真带劲,这RLAIF要是真能把那帮人工标注给省了,那可太贼对了,咱现在整模型不得老费劲了,整挺