大模型LoRA微调所需的显存大小并非固定值,通常取决于模型参数量、批次大小及优化技术,主流7B模型在开启Q-LoRA时最低仅需约6GB-8GB显存,而全参数微调则需24GB以上,具体配置需根据硬件条件与精度需求权衡。
在本地部署大模型或进行私有化微调的场景中,显存往往是制约开发效率的最大瓶颈,许多初学者容易陷入“显存越大越好”的误区,却忽略了显存占用的核心变量是模型精度、序列长度以及优化策略,理解这些变量如何相互作用,才能避免硬件资源浪费或训练中途崩溃,业内专家指出,显存管理不仅是硬件选择问题,更是算法优化能力的体现。

显存占用的核心决定因素
要准确预估显存需求,必须先拆解影响显存消耗的三大关键维度,这不仅仅是看模型有多大,更要看你怎么用。
模型参数规模与精度
模型参数量是显存占用的基础底座,以目前主流的开源模型为例,7B(70亿参数)和13B(130亿参数)是个人开发者最常接触的两个量级。
- FP16/BF16精度:这是全精度微调的标准配置,对于7B模型,仅权重就需要约14GB显存,如果加上优化器状态、梯度以及激活值,实际需求会翻倍。
- INT8/INT4精度:通过量化技术,可以将权重压缩,4bit量化下,7B模型的权重仅需约3.5GB显存,这是Q-LoRA技术能够普及的关键,它让消费级显卡也能触碰大模型微调门槛。
批次大小(Batch Size)与序列长度
很多开发者发现,模型很小,但显存依然爆满,问题通常出在这里。
- 批次大小:Batch Size直接决定同时处理的数据量,Batch Size越大,显存占用呈线性增长,在显存有限时,通常采用梯度累积(Gradient Accumulation)来模拟大Batch效果,从而在不增加显存峰值的前提下保持训练稳定性。
- 序列长度:上下文窗口越长,激活值占用的显存越多,处理1024长度的文本与处理8192长度的文本,显存消耗差异巨大,对于长文档微调,建议适当截断或使用Flash Attention等优化技术。

LoRA与全参数微调的本质区别
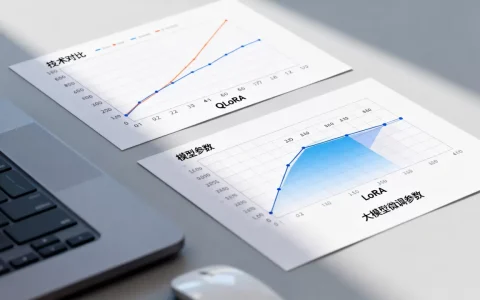
这是选择硬件配置的分水岭,全参数微调需要更新模型所有权重,因此需要存储完整的梯度、优化器状态和动量,显存开销极大,而LoRA(Low-Rank Adaptation)仅训练注入的低秩矩阵,参数量通常仅为原模型的0.1%-1%。
- 全参数微调:显存需求 ≈ 模型权重 + 梯度 + 优化器状态 + 激活值。
- LoRA微调:显存需求 ≈ 冻结模型权重 + 少量LoRA参数 + 激活值。
不同场景下的显存配置建议
基于上述因素,我们可以将常见场景划分为三个梯队,对应不同的硬件选择策略。
入门级:7B模型Q-LoRA微调
这是目前个人开发者性价比最高的选择,通过4bit量化加载模型,并仅微调LoRA适配器。
- 最低配置:NVIDIA RTX 3060 (12GB) 或 RTX 4060 (8GB-12GB)。
- 实际体验:在8GB显存下,需将Batch Size设为1,并使用梯度累积,训练速度较慢,但完全可行,12GB显存则更为从容,可尝试稍大的Batch Size。
- 适用人群:预算有限的学生、个人研究者、小规模垂直领域数据微调。
进阶级:7B/13B模型LoRA微调
当数据量增大或需要更高精度时,8GB显存显得捉襟见肘。
- 推荐配置:NVIDIA RTX 3090/4090 (24GB)。
- 优势:24GB显存允许加载13B模型的4bit量化版本,或7B模型的8bit量化版本,可以支持更大的Batch Size和更长的序列长度,训练效率显著提升。
- 场景:企业级私有知识库构建、高质量指令微调、多轮对话训练。

专业级:13B+模型或全参数微调
若需进行13B及以上模型的全参数微调,或追求极致性能,消费级显卡已难以胜任。
- 推荐配置:NVIDIA A100 (40GB/80GB) 或 H100,或多卡并联消费级显卡。
- 策略:使用DeepSpeed ZeRO-3等分布式训练框架,将模型权重、梯度和优化器状态分散到多张显卡上。
- 场景:大型语言模型基座优化、大规模预训练后微调、对模型性能要求极高的商业应用。
显存优化实操技巧
即使拥有高端显卡,不合理的代码配置也会导致显存溢出,以下是经过验证的优化路径。
启用混合精度训练
不要只依赖模型权重的量化,训练过程中的激活值也占用大量显存。
- 操作:在PyTorch中使用
torch.cuda.amp(自动混合精度)。 - 效果:将前向和反向传播中的激活值从FP32转换为FP16/BF16,可节省约50%的激活值显存,且对模型精度影响微乎其微。
使用梯度检查点(Gradient Checkpointing)
这是一种典型的“以时间换空间”策略。
- 原理:不保存所有层的激活值,而是在反向传播时重新计算前向传播的结果。
- 操作:在Hugging Face Transformers库中,设置
gradient_checkpointing=True。 - 代价:训练速度会下降约20%-30%,但显存占用可降低30%-50%,是突破显存瓶颈的有效手段。
优化数据加载与预处理
显存溢出有时并非来自模型本身,而是来自数据预处理。

- 避免:不要在内存中一次性加载所有数据并进行大规模预处理。
- 建议:使用生成器或流式读取数据,确保每个Batch的数据在送入GPU前已经过Tokenizer处理,并裁剪至最大长度。
常见疑问解答
大模型LoRA微调需要多大显存才能跑通7B模型?
若采用Q-LoRA(4bit量化)技术,最低需要6GB-8GB显存即可运行,但训练速度较慢,建议Batch Size设为1并使用梯度累积,若采用8bit量化或标准LoRA,建议至少12GB显存以保证流畅训练,对于13B模型,则需24GB及以上显存。
显存不足时,除了换显卡还有什么解决办法?
除了更换硬件,可通过以下软件手段缓解:1. 启用Gradient Checkpointing,牺牲部分训练速度换取显存空间;2. 减小Batch Size,增加Gradient Accumulation Steps;3. 缩短Sequence Length,仅保留关键信息;4. 使用DeepSpeed或FSDP等分布式训练框架,将参数分散到多卡或CPU内存中。
LoRA微调与全参数微调的显存差异有多大?
全参数微调需要存储完整的模型权重、梯度和优化器状态,显存需求通常是LoRA的3-5倍,7B模型全参数微调可能需要48GB+显存,而Q-LoRA仅需6-8GB,这种差异使得LoRA成为资源受限场景下的首选方案,尤其适合个人开发者和中小企业。
显存并非唯一的衡量标准,合理的算法优化与硬件配置相结合,才能在有限的资源下实现最大的模型效能,选择适合自身数据规模与硬件条件的微调策略,比盲目追求高配硬件更为关键。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/394926.html