


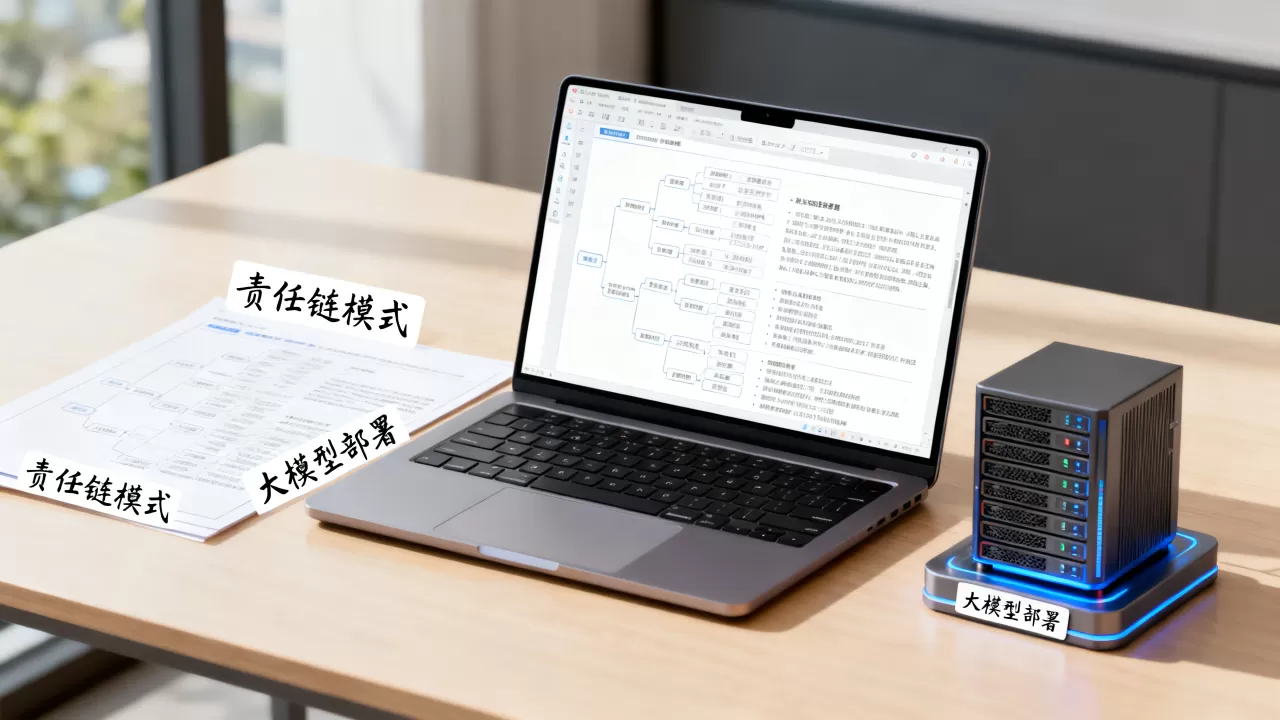
大模型部署采用责任链模式,核心在于将推理请求拆解为预处理、模型调用、后处理及监控等独立环节,实现解耦、灵活扩展与故障隔离,显著提升系统吞吐量与可维护性。
在2026年的AI基础设施架构中,单体式的大模型服务已难以应对高并发与复杂业务逻辑,责任链模式(Chain of Responsibility)不再仅仅是设计模式的教科书案例,而是成为构建高可用LLM应用网关的标准实践,它让每一个处理步骤从输入清洗到输出合规检查都成为一个独立的处理器,请求像流水一样穿过链条,每个节点只处理自己关心的部分,然后决定是否传递给下一个节点。
为什么大模型部署需要责任链模式?
传统的大模型调用往往是一团乱麻:鉴权、限流、日志、缓存、推理、后处理全部耦合在一个函数里,这种架构在初期开发时看似高效,但随着业务复杂度上升,维护成本呈指数级增长,业内专家指出,当服务节点超过10个时,耦合代码导致的回归测试失败率会显著增加。
责任链模式通过“解耦”解决了这一痛点,它将请求处理过程抽象为一条链,每个处理器(Handler)持有对下一个处理器的引用,这种结构带来了三个核心优势:
- 单一职责原则:每个模块只负责一件事,鉴权模块只管Token合法性,不管业务逻辑。
- 动态组合:你可以随时在链中插入或移除节点,想增加一个“敏感词过滤”环节?只需新增一个处理器并链接到链中,无需修改原有代码。
- 故障隔离:如果某个节点失败,可以配置重试机制或降级策略,而不影响整个链的运行。
对比传统单体架构的优劣
为了更直观地理解,我们对比一下两种架构在应对“突发流量”时的表现。
| 维度 | 传统单体架构 | 责任链模式架构 |
|---|---|---|
| 代码耦合度 | 极高,牵一发而动全身 | 低,模块间松耦合 |
| 扩展性 | 需修改核心代码,风险高 | 新增类即可,符合开闭原则 |
| 调试难度 | 日志混杂,难以定位瓶颈 | 每个节点独立日志,链路追踪清晰 |
| 容错能力 | 单点故障导致整体不可用 | 可配置熔断、降级策略 |
大模型部署责任链模式实战步骤
在实际落地中,构建一个高效的大模型责任链并非难事,关键在于如何设计处理器接口以及如何编排链的顺序,以下以Python和FastAPI为例,展示如何构建一个标准的LLM推理网关。
第一步:定义处理器接口
所有处理器必须实现一个统一的接口,通常包含handle方法,该方法接收请求上下文(Context),并返回处理结果或异常。
class Handler:
    def __init__(self):
        self._next = None
    def set_next(self, handler: 'Handler') -> 'Handler':
        self._next = handler
        return handler
    def handle(self, request: dict) -> dict:
        if self._next:
            return self._next.handle(request)
        return None
第二步:实现具体处理器节点
每个节点继承自Handler,并重写handle方法,鉴权节点只检查Token,通过后调用下一个节点;否则直接返回错误。
鉴权处理器示例
class AuthHandler(Handler):
    def handle(self, request: dict) -> dict:
        token = request.get('token')
        if not self._validate_token(token):
            raise Exception("Unauthorized")
        return super().handle(request)
    def _validate_token(self, token):
        # 模拟鉴权逻辑
        return token == "valid_token_2026"
缓存处理器示例
缓存节点需要判断请求是否命中缓存,如果命中,直接返回结果,不继续传递;如果未命中,则传递到下一个节点(通常是模型推理),并将结果存入缓存。
class CacheHandler(Handler):
    def handle(self, request: dict) -> dict:
        cache_key = self._generate_key(request)
        cached_result = self._redis.get(cache_key)
        if cached_result:
            return cached_result # 命中缓存,终止链
        # 未命中,继续传递
        result = super().handle(request)
        self._redis.set(cache_key, result)
        return result
第三步:组装责任链
在应用启动时,将各个处理器按业务逻辑顺序串联起来,顺序至关重要,通常遵循“安全 -> 缓存 -> 限流 -> 推理 -> 后处理”的逻辑。
# 实例化处理器
auth_handler = AuthHandler()
cache_handler = CacheHandler()
rate_limit_handler = RateLimitHandler()
llm_handler = LLMInferenceHandler()
post_process_handler = PostProcessHandler()
# 组装链条
auth_handler.set_next(cache_handler)
            .set_next(rate_limit_handler)
            .set_next(llm_handler)
            .set_next(post_process_handler)
# 发起请求
request_data = {"prompt": "你好", "token": "valid_token_2026"}
response = auth_handler.handle(request_data)
常见场景与优化策略
在实际生产中,单纯的责任链还不够,需要结合具体场景进行优化。
如何处理大模型推理超时?
大模型推理往往耗时较长,在责任链中,可以在
LLMInferenceHandler中引入超时控制,如果推理时间超过设定阈值(如30秒),则抛出超时异常,触发上游的降级处理器(如返回默认回复或错误码),而不是让请求一直挂起占用资源。
如何实现动态链加载?
对于多租户场景,不同租户可能需要不同的处理逻辑,VIP租户跳过缓存直接推理,普通租户走完整链条,可以通过配置中心动态加载处理器列表,实现“千人千面”的责任链,据工信部数据,动态配置能力已成为企业级AI网关的标配功能。
监控与可观测性
每个处理器都应记录自己的执行时间和状态,通过TraceID串联整个链条,可以清晰地看到请求在每个节点的耗时,这有助于快速定位性能瓶颈,如果发现PostProcessHandler耗时过长,可能是正则表达式匹配效率低,需针对性优化。
大模型部署责任链模式常见问题解答
大模型部署责任链模式适合中小型企业吗?
中小型企业初期业务逻辑简单,单体架构可能更轻量,但当API调用量达到万级/日,或需要对接多个不同的大模型供应商时,责任链模式的价值凸显,它能降低接入新模型的边际成本,避免重复造轮子。
责任链模式会导致性能损耗吗?
是的,函数调用栈的增加会带来微小的性能开销,但在现代硬件和语言运行时下,这种开销通常在微秒级,远低于大模型推理本身的秒级延迟,对于LLM应用而言,这种损耗可忽略不计,而带来的架构收益远大于成本。
如何调试责任链中的错误?
务必为每个处理器添加详细的日志,并包含唯一的TraceID,当请求失败时,通过TraceID可以在日志系统中串联起整个链条的执行路径,快速定位是哪个节点抛出了异常,以及异常发生时的输入数据状态。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/395563.html


评论列表(1条)
笑死,这架构26年才成熟?我半夜加班踩过的监控漏报坑,孩子睡了我才敢重看。